La boîte noire des LLM est un problème pratique : un modèle peut répondre à une question difficile en quelques secondes, tout en nous laissant incapables d'expliquer quels calculs internes ont produit cette réponse. Le 15 octobre 2026, Nick Cammarata, coauteur de l'étude de 2023 d'OpenAI sur les neurones, a publié Neural Networks Are Already Clean en tant que chercheur chez Goodfire. Il soutient que cette « boîte noire » pourrait être plus facile à étudier que ne le pensait le domaine. Cette affirmation mérite de l'attention. Elle nécessite aussi une lecture prudente : l'essai est une hypothèse de travail, et son article technique associé sur les neurones des modèles de langage n'est pas encore publié.
La question utile est de savoir si les chercheurs peuvent passer d'une description intéressante d'un neurone à une explication fiable du comportement d'un modèle. Cammarata apporte de nouveaux éléments en faveur de la première étape ainsi que plusieurs démonstrations causales de la seconde. Aucun de ces éléments ne constitue une cartographie complète d'un grand modèle de langage.
Pour un résumé en termes simples, accédez à la version simplifiée.
Pourquoi la boîte noire des LLM persiste-t-elle ?
Les chercheurs connaissent les opérations mathématiques d'un réseau entraîné. La difficulté consiste à expliquer comment des millions de composants appris se combinent pour produire une réponse donnée. Un seul neurone artificiel peut s'activer pour des exemples qui semblent sans rapport. S'il réagit à la fois au visage d'un chat et à l'avant d'une voiture, que représente-t-il réellement ?
Une réponse influente a été la superposition : un modèle pourrait regrouper des caractéristiques sans rapport dans des directions internes qui se chevauchent, parce qu'il dispose d'un espace limité. Les chercheurs entraînent ensuite un second modèle, souvent un autoencodeur parcimonieux, pour séparer ces caractéristiques.
Cammarata soutient qu'une partie des éléments classiques en faveur de cette représentation a été mal interprétée. Le mélange apparent pourrait plutôt refléter un motif partagé, un microscope imparfait ou une architecture de réseau qui rendait les couches ultérieures plus difficiles à entraîner. Sa définition de la superposition désigne spécifiquement le regroupement de calculs sans rapport dans le même mécanisme ; d'autres chercheurs utilisent ce terme plus largement pour désigner la représentation d'un nombre de concepts supérieur au nombre de dimensions. Son essai explique cette distinction.
Qu'est-ce qui a changé dans la nouvelle étude ?
Le neurone familier du chat et de la voiture provenait d'un modèle de vision, et non d'un LLM. Cammarata le décrit désormais comme réagissant à un motif visuel partagé en forme de V. Selon son interprétation, le neurone regroupe une structure visuelle apparentée plutôt que de dissimuler deux concepts arbitraires dans un même emplacement. Il indique également qu'après des modifications architecturales apportées à InceptionV1, un modèle de vision, 99 à 100 % des neurones de sa couche finale sont devenus faciles à interpréter, tandis que la taille du modèle et les données d'entraînement restaient inchangées. Il s'agit d'une affirmation concernant une couche réentraînée d'un modèle de vision. Ce n'est pas une statistique sur les modèles de chat modernes.
Les éléments concernant les modèles de langage sont plus pertinents pour les LLM et plus préliminaires. L'équipe de Goodfire estime que, lors d'un audit initial de Qwen3-32B, environ 90 % des pôles de neurones ont une fonction principale, souvent accompagnée de petites ramifications apparentées. Environ 7 % supplémentaires ont deux fonctions apparentées, tandis qu'environ 2 à 4 % restent inexpliqués.
Un « pôle » désigne un côté de la réponse positive ou négative d'un neurone ; ce pourcentage ne signifie pas que 90 % du comportement d'un LLM a été expliqué. Cammarata précise que la classification varie selon le seuil retenu pour les activations faibles, la profondeur du modèle, la densité des circuits et ce qui est considéré comme une seule fonction. Ces réserves figurent à côté de l'estimation.
L'équipe propose davantage que de simples étiquettes pour les activations. Son essai interactif comprend 1 000 études de cas de neurones sélectionnés aléatoirement parmi Qwen3-32B et Qwen3.6-35B-A3B. Lors d'un test, un agent a utilisé des explications écrites pour inventer des exemples qui devraient activer un neurone ainsi que des quasi-exemples qui ne devraient pas l'activer. Parmi 183 neurones dont le côté positif était expliqué, les nouveaux exemples ont produit une forte activation dans 76 % des cas, contre 11 % pour les quasi-exemples. Il s'agit d'un test de prédiction utile dans le cadre de l'équipe. Cela ne prouve pas que les descriptions capturent chaque activation importante ni chaque effet en aval.
Les chercheurs peuvent-ils modifier la réponse d'un LLM en intervenant ?
Oui, dans certains exemples sélectionnés. Goodfire retrace des groupes de neurones de Qwen3-32B, puis les supprime pour observer les changements. Dans un prompt dont les indices pointent vers le père Noël, la suppression de huit neurones sélectionnés associés à la réponse a fait baisser la probabilité déclarée par le modèle pour « Santa » à 0,059 ; la suppression du même nombre de neurones aléatoires dans les mêmes couches l'a laissée à 0,997. Cela montre que ces neurones sélectionnés ont joué un rôle dans ce prompt et dans la prédiction du mot suivant. Il ne s'agit pas d'un taux de réussite mesuré sur des prompts ou des modèles arbitraires. L'intervention et le contrôle sont présentés dans l'essai original.
Cammarata présente également un graphe d'attribution fondé sur les neurones pour Kimi K3, un modèle comportant plusieurs milliers de milliards de paramètres. L'exemple du portefeuille suit certains chemins du prompt vers une réponse concernant la restitution d'un bien perdu. L'essai qualifie les groupes affichés de portion sélectionnée manuellement et précise que les audits complets à cette échelle n'ont pas encore commencé. Une portion lisible d'un très grand modèle est prometteuse, mais elle ne peut pas nous dire ce que faisait chaque chemin omis.
Comment les autres chercheurs réagissent-ils ?
Le 17 octobre, le chercheur Leo Gao a publié Neural networks are not already clean. Il reconnaît que des travaux antérieurs ont peut-être qualifié trop rapidement les neurones de polysémantiques.
Son objection est qu'une description claire des exemples les plus marquants peut tout de même ignorer des entrées qui devraient activer le neurone, des réponses faibles qui ont de l'importance ou l'importance de l'intensité de l'activation. Gao propose un test plus exigeant : remplacer les valeurs du neurone par des valeurs prédites à partir de l'explication, puis mesurer si le reste du modèle se comporte toujours de la même manière. Si le comportement se dégrade, l'explication a manqué quelque chose d'important.
La réponse directe de Neel Nanda établit une distinction similaire. Il voit une valeur pratique à utiliser les neurones natifs et les graphes d'attribution pour étudier un comportement suspect particulier. Il reste toutefois convaincu que cela ne prouve pas qu'une rétro-ingénierie ambitieuse soit proche, et souligne notamment les activations faibles dans les LLM ainsi que les informations présentes dans le flux résiduel. Cammarata lui-même affirme que l'attention est moins bien comprise dans ces travaux et que les immenses modèles de langage sont encore loin d'être entièrement cartographiés.
Le désaccord est constructif. Goodfire demande si les composants propres au réseau peuvent servir de point de départ à l'interprétation. Gao et Nanda demandent quelle quantité d'explications doit être prédite avant que nous puissions leur faire confiance. Un neurone peut sembler lisible, participer causalement à une réponse et néanmoins présenter un comportement important que nous n'avons pas capturé.
Deux autres réactions renforcent l'exigence de preuve. Dans la même discussion publique, John Wentworth demande une explication neurone par neurone du modèle de vision ConvNeXt présenté, accompagnée des éléments justifiant chaque interprétation. Il affirme que le microscope public, à lui seul, ne lui a pas permis de comprendre immédiatement la signification de ces neurones. Il s'agit d'une demande concernant un artefact inspectable, et non d'un test qui réfuterait les résultats sur les LLM. Alex Gibson souligne une autre lacune : l'essai qualifie sa conclusion la plus importante de hautement spéculative, tandis que certains courts messages sur les réseaux sociaux semblent plus affirmatifs. Il s'agit de premières réactions individuelles, et non d'un verdict général du domaine.
Cela rend-il un système d'AI sûr ou transparent ?
Aucun certificat de sécurité ne découle de ces résultats. L'explication d'un neurone est une affirmation locale. Un graphe d'attribution est un compte rendu partiel d'un calcul. Une affirmation de sûreté au niveau du système nécessiterait une couverture des circuits importants, des tests fiables contre les comportements non détectés et des preuves que la méthode fonctionne au-delà des exemples choisis pour l'inspection. Pour un système utilisant des outils, les permissions des agents AI→ doivent toujours limiter ce que le modèle peut faire, quelle que soit la lisibilité de ses circuits internes.
L'article technique de Goodfire sur les modèles de langage et une réplication indépendante seront importants à cet égard.
Il existe également une limite d'accès. Ces expériences inspectent les activations internes et interviennent sur des composants. Si votre produit appelle uniquement une API de chat hébergée, vous ne pouvez pas effectuer les mêmes tests sur ce modèle au moyen de prompts ordinaires.
La version simplifiée
Une question entre dans un modèle d'AI et une réponse en sort. La difficulté consiste à savoir ce qui s'est passé à l'intérieur.
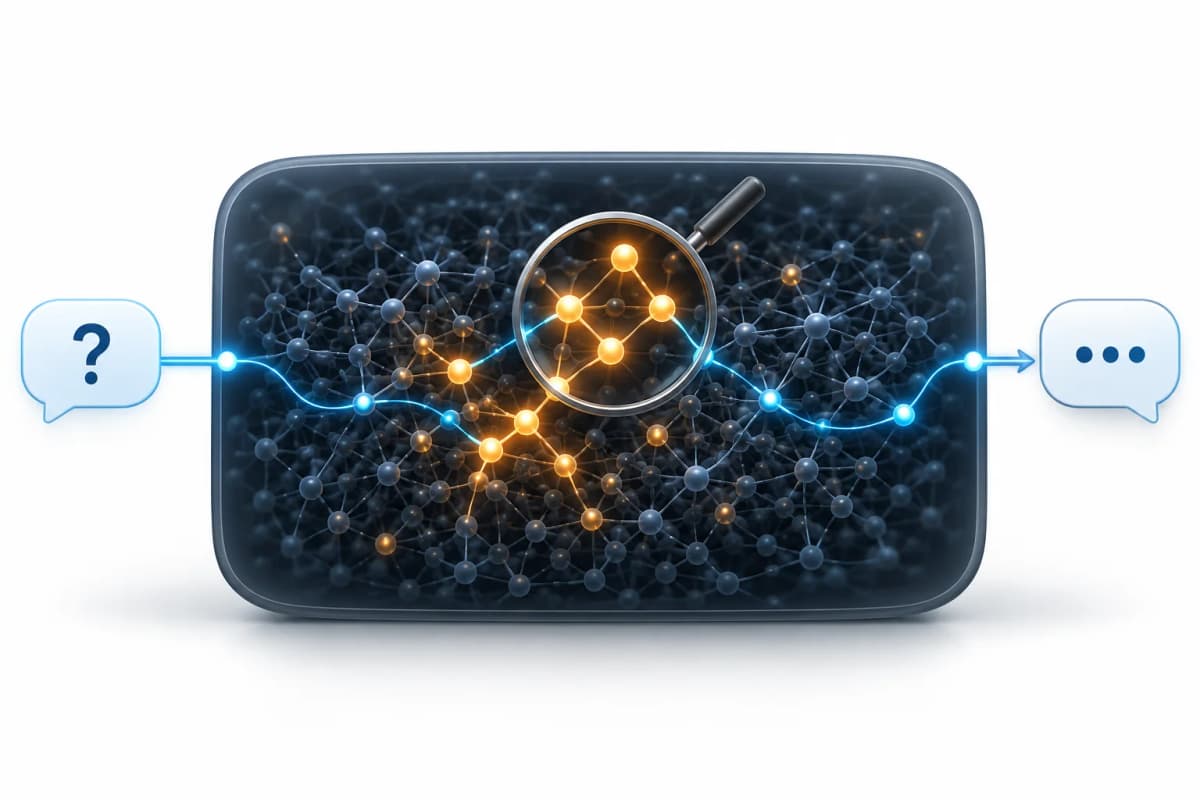
Ce qui s'est passé : Goodfire a examiné de petites parties d'un modèle de langage appelées neurones. Lors de certains tests, les chercheurs ont pu décrire le rôle de certains d'entre eux et modifier une réponse en les supprimant.
Pourquoi c'est important : Le fonctionnement interne du modèle pourrait être plus facile à étudier que ne le pensaient de nombreux chercheurs.
Ce que cela ne signifie pas : Nous ne pouvons pas encore expliquer chaque réponse ni déclarer le modèle sûr. Si vous construisez des produits avec des API d'AI ordinaires, continuez à tester les sorties et à limiter ce que l'AI peut faire. Des études ultérieures pourraient conduire à de meilleurs outils pour déboguer et surveiller les modèles.
Qu'est-ce que cela signifie pour les produits d'AI aujourd'hui ?
Pour les workflows d'agents et de contenu que je construis, ce résultat ne nous donne pas de nouveau bouton à activer. Le travail immédiat consiste à tester les tâches réellement exécutées par les utilisateurs, à vérifier les sources et les affirmations factuelles, à journaliser le comportement du modèle et des outils, à restreindre les permissions des outils et à exiger une validation humaine avant toute action externe lourde de conséquences. Ces contrôles répondent aux défaillances observables, que les neurones du modèle soient lisibles ou non.
Vous pouvez tout de même évaluer le comportement externe d'un modèle hébergé. Mon guide précédent sur la calibration de la confiance des LLM→ couvre une tâche de ce type : vérifier si un score suit la justesse sur votre propre travail. Cela mesure une question différente de l'interprétabilité mécaniste, et les deux nécessitent des limites claires.
Avant d'adopter un moniteur interne, je demanderais quel comportement il détecte sur des tâches mises de côté, à quelle fréquence il manque des cas dangereux ou interrompt des cas bénins, s'il agit avant un appel d'outil et si le fournisseur expose réellement les activations nécessaires. Les sorties ordinaires d'une API ne répondent pas à ces questions.
Qu'est-ce qui pourrait changer à plus long terme ?
Si d'autres équipes reproduisent les résultats sur les neurones et parviennent à retracer les chemins importants entre eux, les développeurs de modèles pourraient diagnostiquer les défaillances au niveau des mécanismes plutôt que d'étudier uniquement les sorties. Cammarata évoque également des agents de recherche automatisés et la modification prudente d'un environnement d'entraînement qui s'avérerait nuisible comme étapes futures possibles. Il s'agit de propositions à tester, et non de capacités établies par cet essai.
Une direction connexe dispose déjà d'un exemple concret. Dans une étude distincte de Goodfire sur Kimi K3, une sonde d'activation alimente un second modèle qui évalue s'il faut interrompre une interaction risquée avec un agent. Goodfire rapporte des résultats prometteurs dans ses propres évaluations. Ce moniteur nécessite un accès aux activations internes, et l'étude ne valide pas les explications de Cammarata sur les neurones. Elle montre ce que des signaux au niveau du modèle pourraient éventuellement offrir à un fournisseur ou à un déploiement avec poids ouverts ; un client d'API aurait besoin d'un service exposé et de sa propre évaluation adaptée à ses tâches.
Une meilleure visibilité interne pourrait aider les revues de sécurité et accélérer également le développement des modèles. L'équilibre reste inconnu. Une norme future utile demanderait aux fournisseurs de montrer quels comportements leurs explications internes couvrent, où elles échouent et si un moniteur améliore les contrôles fondés uniquement sur les sorties dans des workflows réalistes.
Que devons-nous surveiller ensuite ?
Je rechercherais cinq éléments de preuve dans l'article technique annoncé et les travaux de suivi :
Ma lecture est que Goodfire a présenté un argument crédible en faveur d'un examen plus approfondi des neurones natifs d'un modèle. L'équipe a également fourni aux chercheurs de meilleurs protocoles pour alimenter le débat. Au 17 octobre 2026, la conclusion la plus solide est plus limitée que « la boîte noire des LLM est résolue » : certaines parties pourraient être plus lisibles que prévu, et le chemin entre des parties lisibles et des explications fiables de l'ensemble du modèle reste ouvert. Pour les équipes qui construisent sur des API hébergées, les tests de comportement et les limites de permissions restent le point de départ pratique.
Sources principales : l'essai de recherche de Cammarata, la réponse de Gao, la discussion directe entre chercheurs et l'étude distincte de Goodfire sur le moniteur d'activation.