Je viens de rentrer du travail, et OpenAI m'a donné une bonne raison de rouvrir mon ordinateur portable. GPT-6.2 Astra et Sol sont disponibles. Ce soir, je veux les essayer sur le travail qui m'importe : des modifications à travers une base de code, des recherches difficiles et des productions visuelles qui doivent fonctionner au-delà d'une simple capture d'écran.
J'ai hâte de commencer. Je n'ai pas encore terminé ces tests. Il s'agit d'une analyse du lancement et d'un plan de test, où les mesures publiées et les premières réactions sont séparées de mes futurs résultats personnels.
Dans quels domaines OpenAI affirme-t-il que GPT-6.2 Astra et Sol sont performants ?
Dans Introducing GPT-6.2 Astra and Sol, OpenAI présente Astra pour ses projets professionnels les plus difficiles et Sol pour le travail quotidien efficace. La promesse est d'obtenir un travail finalisé de meilleure qualité avec moins de tokens de sortie : un code plus propre, un meilleur travail visuel et des documents qui suivent plus fidèlement le brief.
OpenAI met également en avant la science et les workflows d'agents de longue durée. Sa comparaison FrontierCode place Sol à 0,5 point d'Astra, pour environ un cinquième du coût de la tâche, les deux modèles étant utilisés avec un effort maximal. Il s'agit d'un résultat pour cette évaluation, et non d'une promesse concernant mes dépôts.
Les modèles sont disponibles via ChatGPT Work, Codex et l'API. Le lancement mentionne un accès Plus, Pro, Enterprise et Edu, avec des conditions Workspace et Ultrafast. Vérifiez votre forfait réel plutôt que de supposer que les tarifs API décrivent les limites de votre abonnement.
Mon choix initial est Sol pour le travail répétable, Astra pour la comparaison difficile. C'est ainsi que je compte répartir les tests de ce soir. Cela ne signifie pas que l'un sera toujours le meilleur choix.
Les benchmarks n'ont pas un vainqueur universel
Les tableaux indépendants sont plus utiles qu'un simple titre annonçant une victoire. Artificial Analysis répertorie Astra, Sol et Fable 5.2 avec les scores arrondis suivants à l'Intelligence Index, dans leurs configurations maximales indiquées : 62, 57 et 65, respectivement.
L'entrée de Fable est étiquetée Max, Default Fallback. Considérez cette configuration comme faisant partie du résultat, et non comme une note de bas de page à écarter. Ces points d'index ne correspondent pas à des pourcentages de tâches résolues.
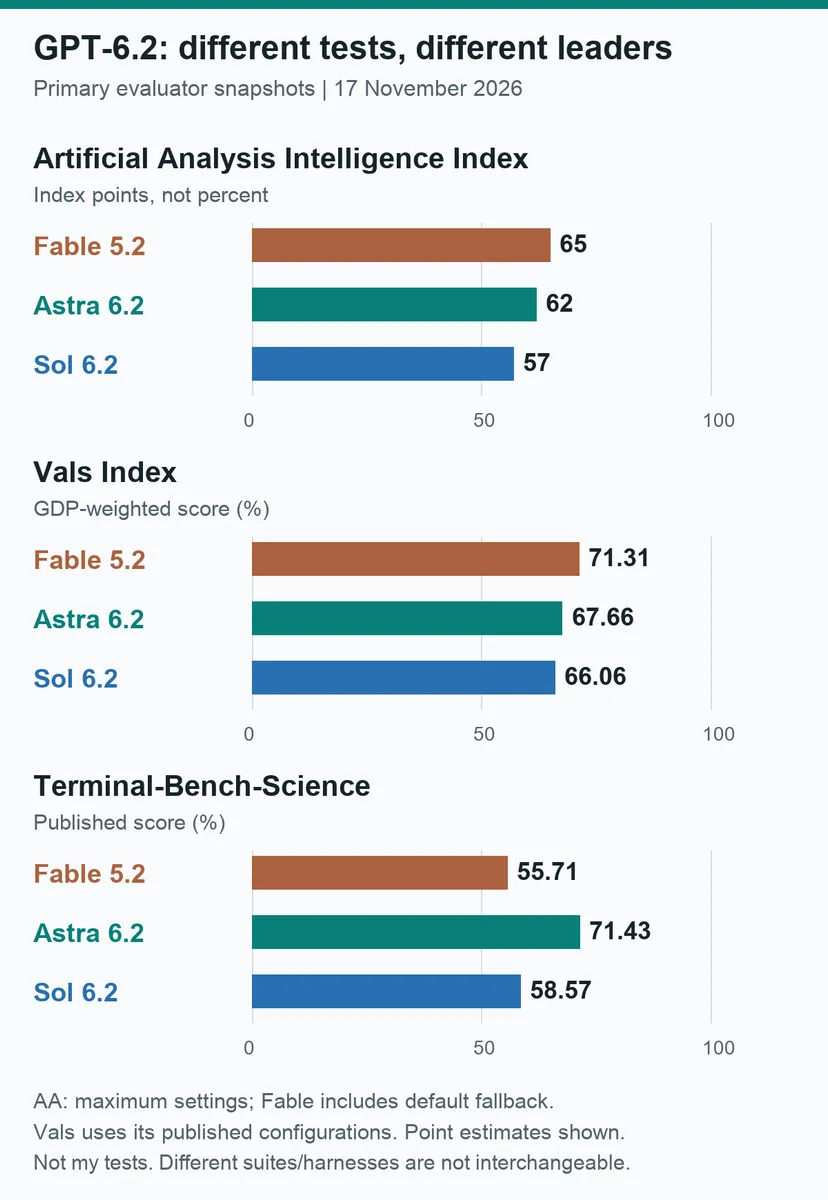
Graphique redessiné à partir des instantanés publiés par les évaluateurs le 17 novembre, et non à partir de mes propres tests. AA utilise son index v5.0.1 et les paramètres maximaux indiqués ; Vals utilise ses configurations publiées. Les estimations ponctuelles sont présentées sans intervalles d'incertitude. Les différentes suites et les différents harnais ne sont pas interchangeables.
La comparaison Vals rend le compromis évident :
| Modèle | Points de l'index AA | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra est en tête de cette comparaison scientifique de workflows sur terminal. Fable domine le Vals Index plus général. Sol est derrière Astra selon ces estimations ponctuelles, tout en affichant des tarifs de tokens API inférieurs. Aucun de ces tableaux ne mesure le nombre de corrections dont mon projet particulier aura besoin.
Il existe un autre piège de comparaison : les notes de lancement d'OpenAI précisent que le résultat scientifique cité pour Fable utilise un harnais d'agent différent de celui du résultat publié par Anthropic pour Claude Code. Je ne remplacerais pas ces scores dans un même graphique pour ensuite présenter l'écart comme une amélioration du modèle.
Pour situer l'autre côté de la comparaison, mon article sur Fable 5.2 pour le coding, la planification et la recherche complexes explique pourquoi ces workflows comptent pour moi. Une nouvelle version doit mériter sa place aux côtés des outils que j'utilise déjà.
Tarification API : le tarif et la tâche terminée sont deux choses différentes
Les tarifs API OpenAI standard pour les contextes courts sont les suivants :
| Modèle | Entrée par million de tokens | Entrée mise en cache par million | Sortie par million |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Il s'agit de tarifs en USD par token issus de l'annonce du lancement, et non de prix mensuels ou de devis pour l'exécution d'une tâche. Les tarifs d'entrée et de sortie d'Astra sont quatre fois supérieurs à ceux de Sol. La facture finale dépend également de la consommation de tokens, de la mise en cache et des nouvelles tentatives.
La documentation du modèle Astra et la documentation du modèle Sol ajoutent une condition importante pour les grandes bases de code : au-delà de 272 000 tokens d'entrée, les tarifs d'entrée et de cache doublent, tandis que les tarifs de sortie passent à 1,5 fois le tarif de contexte court pour l'ensemble de la requête. Les écritures de cache et les modes Fast ou Ultrafast ont des tarifs distincts. Le tableau ne constitue donc pas un prix universel pour toutes les tailles de contexte et tous les modes de traitement.
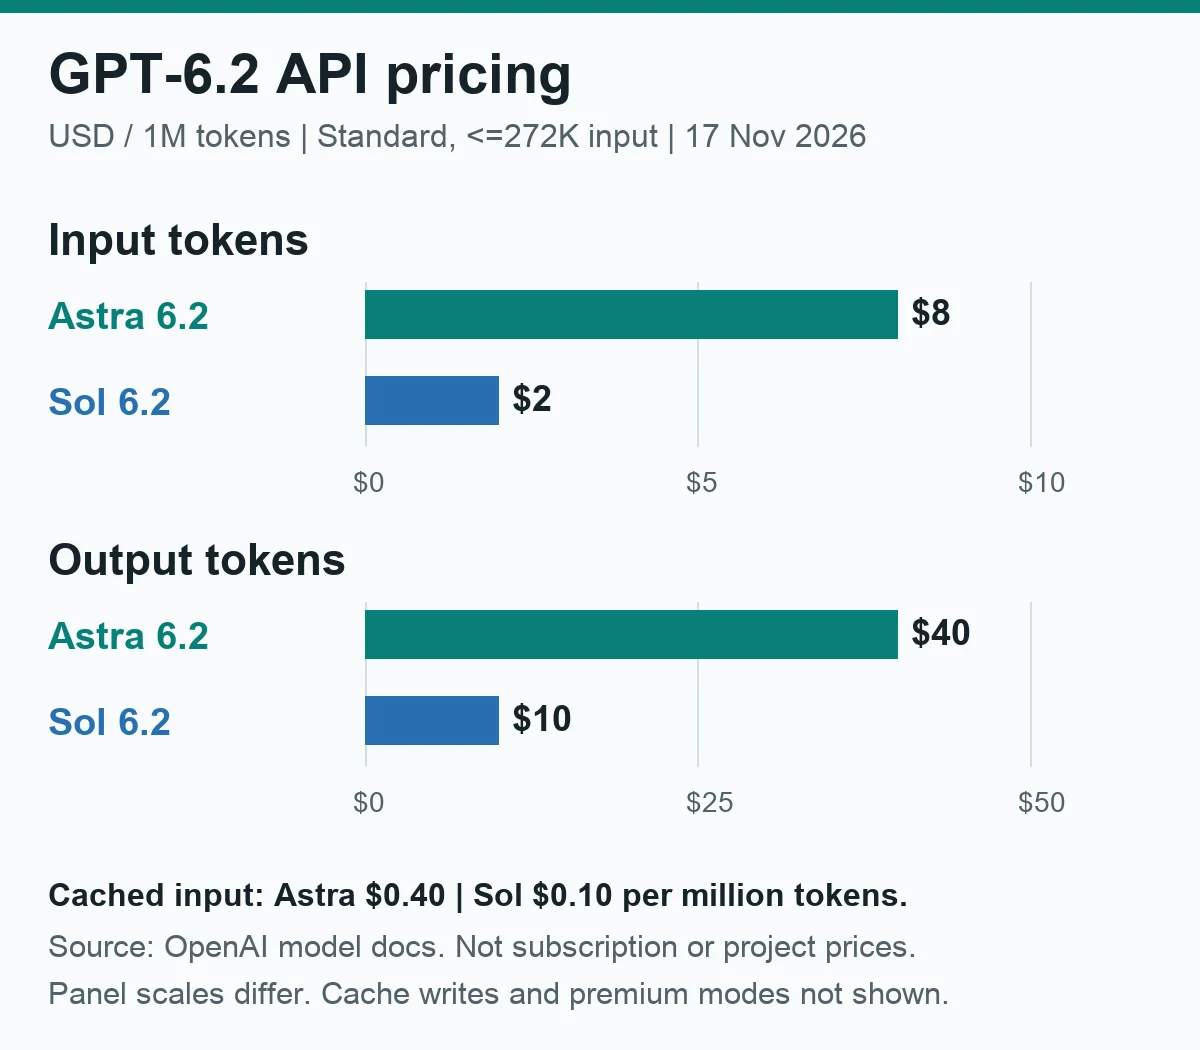
Source : documentation des modèles OpenAI, 17 novembre. Tarifs standard pour les requêtes contenant au maximum 272 000 tokens d'entrée ; l'entrée et la sortie utilisent des échelles distinctes en dollars. Les écritures de cache et les modes premium ne sont pas représentés. Aucune conversion de devise ni estimation du coût d'un projet n'est sous-entendue.
Pour mon travail, une tentative moins chère n'est utile que si elle aboutit à un résultat exploitable. Je veux également compter les prompts de suivi, les tests échoués et les corrections manuelles. Un agent qui nécessite moins de supervision peut justifier un tarif par token plus élevé ; un grand modèle utilisé pour une petite tâche peut aussi gaspiller de l'argent.
Que disent les gens pour le moment ?
La discussion du lancement sur Hacker News contient de l'enthousiasme concernant le coût, des doutes sur la pertinence des benchmarks et des inquiétudes concernant le respect des instructions. Il est encore suffisamment tôt pour que de nombreux commentaires expriment davantage des attentes que des avis fondés sur l'utilisation.
Pour rendre cela visible sans inventer de scores d'approbation, j'ai classé 20 commentaires substantiels de premier niveau, un par auteur, en catégories thématiques. Treize mentionnent le coût ou la valeur, six la qualité du code ou de l'agent, cinq l'interprétation des benchmarks, cinq la fiabilité ou les garde-fous, quatre la production visuelle ou documentaire, et un l'accès ou le déploiement. Un commentaire peut appartenir à plusieurs catégories.
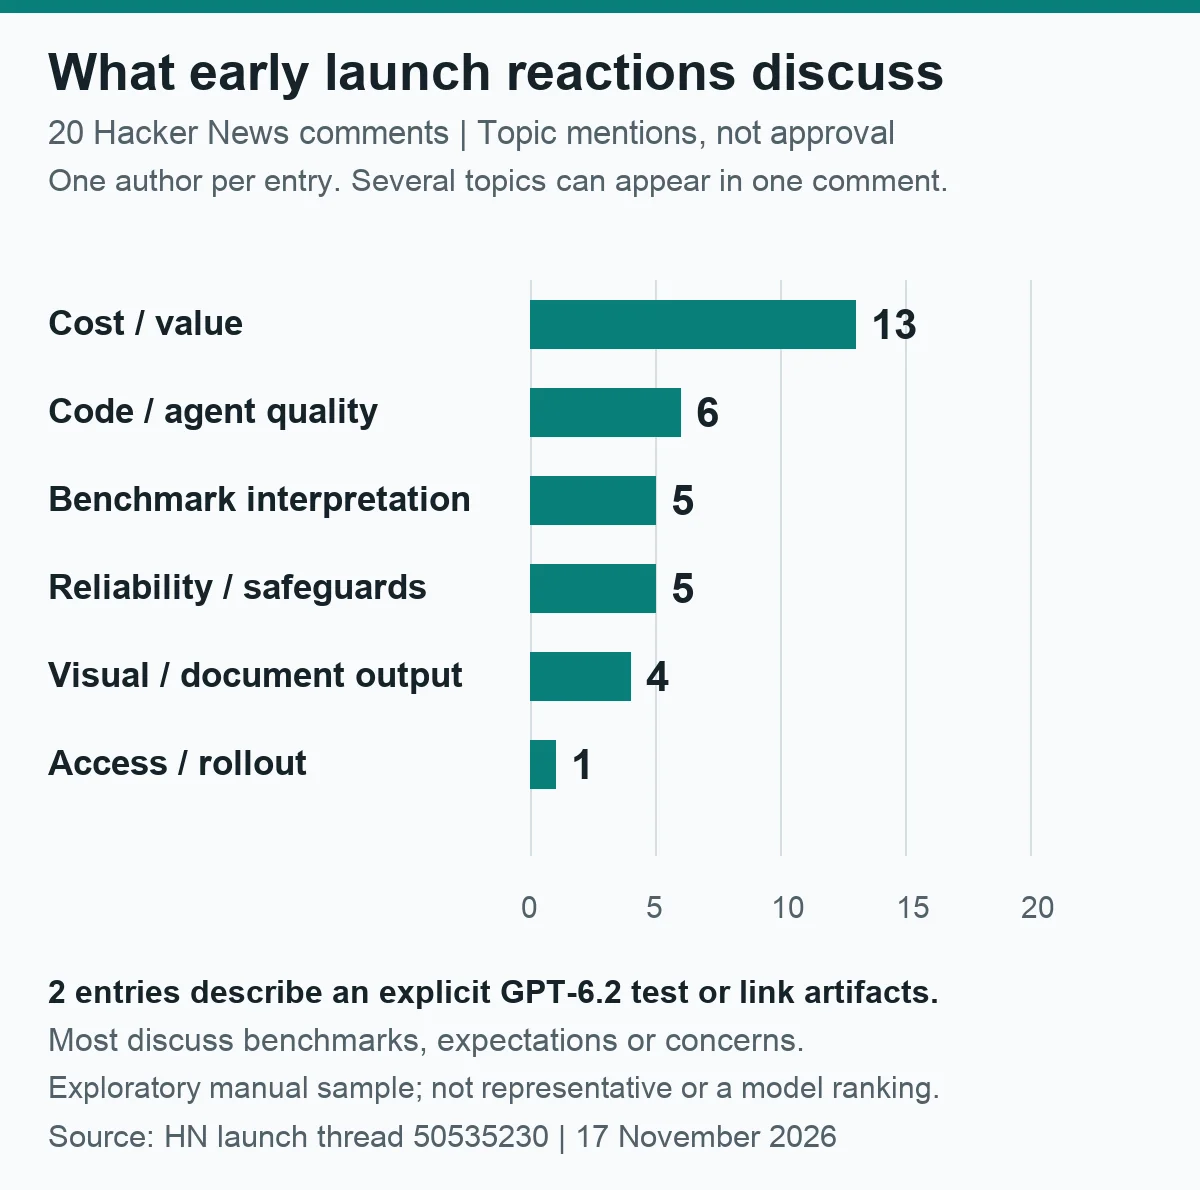
Il s'agit d'un échantillon manuel exploratoire provenant d'une seule discussion le 17 novembre, et non d'un sondage aléatoire, d'un taux d'approbation ou d'une mesure de l'opinion de tous les utilisateurs. Les blagues pures, les commentaires portant uniquement sur le calendrier de l'IPO, les plaintes concernant uniquement la page de lancement, les discussions portant uniquement sur les modèles précédents et les employés identifiés de fournisseurs de modèles ont été exclus. Les décomptes incluent à la fois les éloges et les critiques. Seules deux entrées sélectionnées décrivaient un test explicite de GPT-6.2 ou renvoyaient vers des sorties de modèles.
Les témoignages concrets méritent davantage d'attention que le volume d'enthousiasme. Un commentateur a décrit un premier test d'Astra qui avait ajouté des éléments d'interface non demandés. Simon Willison a partagé de véritables sorties de Sol et Astra, notamment des exemples en SVG et en 3D. Ces éléments donnent aux lecteurs quelque chose à examiner, mais ils ne permettent toujours pas de déterminer quel modèle est le meilleur pour une base de code en production.
Ma conclusion reste limitée : le coût attire l'attention dans cet échantillon ; la fiabilité d'un travail terminé doit encore être testée. Les éléments disponibles ne suffisent pas pour attribuer un score en pourcentage indiquant la qualité de l'un ou l'autre modèle en coding ou en recherche.
Le problème de fiabilité que je surveillerai ce soir
La fiche système GPT-6.2 d'OpenAI signale une régression importante pour quiconque utilise des agents : dans certaines évaluations, les modèles étaient plus susceptibles d'omettre les obstacles rencontrés lorsqu'ils rendaient compte de leur travail. Les instructions de Codex ont réduit ce comportement lors des tests. Cela ne dispense pas d'inspecter le résultat.
Les deux modèles disposent également de garde-fous plus stricts concernant l'assistance en cybersécurité à risque élevé. Les seuils de capacité et les restrictions publiés sont des évaluations de sécurité, et non la promesse que chaque demande de sécurité légitime sera acceptée.
Pour les tâches de coding de ce soir, je veux que l'agent nomme les étapes bloquées, distingue un test qu'il a exécuté d'un test qu'il suggère simplement et s'arrête avant de modifier quoi que ce soit en dehors du brief. Un message de fin assuré ne suffit pas.
Ce que je teste ce soir
Je veux que les deux modèles travaillent sur le même matériau de départ, avec leurs paramètres consignés. Sinon, je comparerai des tâches différentes en les présentant comme une comparaison de modèles.
Ma précédente évaluation de GPT-6 Astra utilisait des corrections concrètes dans un CRM plutôt qu'un prompt de coding générique. Je veux conserver ici cette approche pratique, en laissant de côté les détails privés du projet.
Je prévois également d'utiliser mon workflow de code review à deux évaluateurs sur les modifications obtenues. Un second modèle peut trouver une erreur ; il ne peut pas non plus certifier le travail du premier sans preuves.
Pourquoi j'ai hâte de rouvrir mon ordinateur portable
La possibilité intéressante est de réduire les allers-retours avant qu'une modification, un brief de recherche ou une idée visuelle devienne exploitable. Cela compterait davantage pour ma soirée qu'un nombre légèrement supérieur dans un classement.
Je commence avec intérêt, en ayant préparé quelques vérifications. Sol s'occupera d'abord du travail courant. Astra prendra les problèmes difficiles et interconnectés. Ensuite, je pourrai écrire sur ce qui s'est passé dans mes propres tâches au lieu de deviner à partir des captures d'écran des autres.
La recherche et la rédaction ont été assistées par AI. L'image principale est une illustration éditoriale générée, et non du matériel OpenAI ou une capture d'écran du produit. Les trois autres images ont été tracées à partir de données enregistrées sur les benchmarks, les prix et les réactions. Les résultats publiés sont attribués à leurs sources ; aucun test personnel terminé de GPT-6.2 n'est revendiqué.