J'ai consacré beaucoup moins de temps aux modèles de Google qu'aux autres outils AI de mon workflow. Gemini 4 Argon me donne une raison de changer cela. Les résultats en automatisation métier semblent utiles, et le tarif de lancement annoncé se situe au niveau de GPT-6.1 Sol plutôt que dans la catégorie des modèles exclusivement premium.
Je veux le tester lorsque l'accès sera ouvert. Pour l'instant, il s'agit d'un examen des éléments publiés, des tarifs et des premières réactions, et non d'une évaluation pratique d'Argon.
Vérification des sources : 1er octobre 2026. La couverture est une illustration éditoriale générée par AI. Les graphiques ci-dessous redessinent les résultats numériques cités ; il ne s'agit pas de captures d'écran de mes propres tests.
Qu'est-ce que Gemini 4 Argon, et puis-je déjà l'utiliser ?
Google a annoncé Argon le 30 septembre 2026, d'abord pour les défenseurs de la cybersécurité de confiance via Fairwind. L'accès plus large commencera avec les clients payants de l'API et les abonnés Google AI Ultra ; l'annonce ne donne aucune date ferme de disponibilité publique. Consultez l'annonce de Google concernant Gemini 4 Argon.
J'attendrais d'avoir réellement accès au compte avant d'acheter un abonnement spécifiquement pour Argon. Un déploiement annoncé est différent d'un modèle que je peux sélectionner aujourd'hui, et Google n'a pas promis de date de disponibilité en suédois dans cette annonce.
La principale raison pour laquelle je m'y intéresse est la possibilité de terminer des tâches plus longues avec moins d'intervention. Mon test utile portera sur du code existant, des règles métier complexes et des preuves que le résultat final fonctionne. Une réponse bien présentée ne suffira pas à trancher.
Tarifs de Gemini 4 Argon : le tarif de lancement a un piège
Google annonce 2 $ en entrée et 10 $ en sortie par million de tokens. La note de bas de page de ses tarifs fixe le tarif ultérieur à 4 $/20 $, sans préciser la date de fin de la période de lancement. Les entrées mises en cache bénéficient d'une remise de 95 %, ce qui donne, par calcul, un tarif de lancement de 0,10 $.
| Modèle ou période tarifaire | Entrée / 1 M de tokens | Sortie / 1 M de tokens |
|---|---|---|
| Gemini 4 Argon, lancement | 2 $ | 10 $ |
| Gemini 4 Argon, après le lancement | 4 $ | 20 $ |
| GPT-6.1 Sol, Standard | 2 $ | 10 $ |
| Claude Opus 5.5, Standard | 4 $ | 20 $ |
| GPT-6 Astra, Standard | 10 $ | 50 $ |
Sources : l'annonce de Google et sa note de bas de page tarifaire détaillée, tarifs du modèle GPT-6.1 Sol, tarifs du modèle GPT-6 Astra et tarifs de Claude Platform.
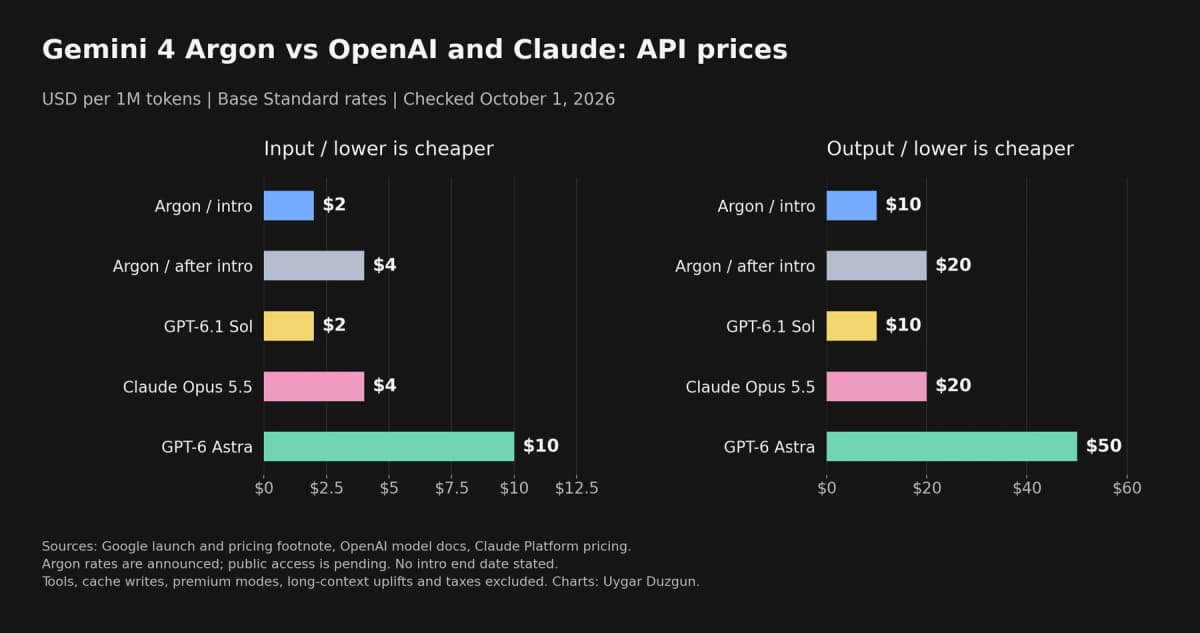
Tarifs de base en USD vérifiés le 1er octobre. Les tarifs d'Argon sont des tarifs annoncés et ne prouvent pas l'existence d'un accès général à l'API. La comparaison exclut les outils, les écritures de cache, les modes premium, les frais régionaux et les taxes.
Pour un exemple de budget simple, un million de tokens d'entrée non mis en cache plus 100 000 tokens de sortie répartis sur plusieurs requêtes à contexte court coûteraient 3 $ avec les tarifs de lancement d'Argon, 6 $ ensuite, 3 $ avec Sol, 6 $ avec Opus et 15 $ avec Astra. Il s'agit d'un calcul fondé sur une répartition fixe des tokens, et non d'une charge de travail mesurée. La même tâche peut consommer un nombre différent de tokens selon les modèles.
OpenAI augmente également les tarifs des requêtes complètes au-delà de 272 000 tokens d'entrée dans un même prompt ; Anthropic indique des tarifs standard pour la fenêtre de contexte d'Opus 5.5. Un tableau de tarifs de base ne peut donc pas vous indiquer le montant d'une session portant sur un immense dépôt. Ma comparaison entre GPT-6.1 Sol et Opus 5.5 couvre ces compromis.
J'établirais le budget d'une intégration en utilisant le tarif ultérieur d'Argon, puis considérerais la promotion comme une économie temporaire. Cela évite de bâtir un dossier commercial autour d'une remise dont je ne peux pas encore planifier l'expiration.
Benchmarks de Gemini 4 Argon : automatisation solide, programmation mitigée
L'automatisation métier est le résultat qui m'intéresse le plus
AutomationBench 1.0.6 de Zapier teste un travail de bout en bout sur 47 outils dans six fonctions métier. Il vérifie l'environnement obtenu à l'aide d'assertions déterministes plutôt que d'évaluer le message final persuasif d'un agent.
Les configurations sélectionnées ci-dessous conservent leurs paramètres d'effort et leur comportement de repli.
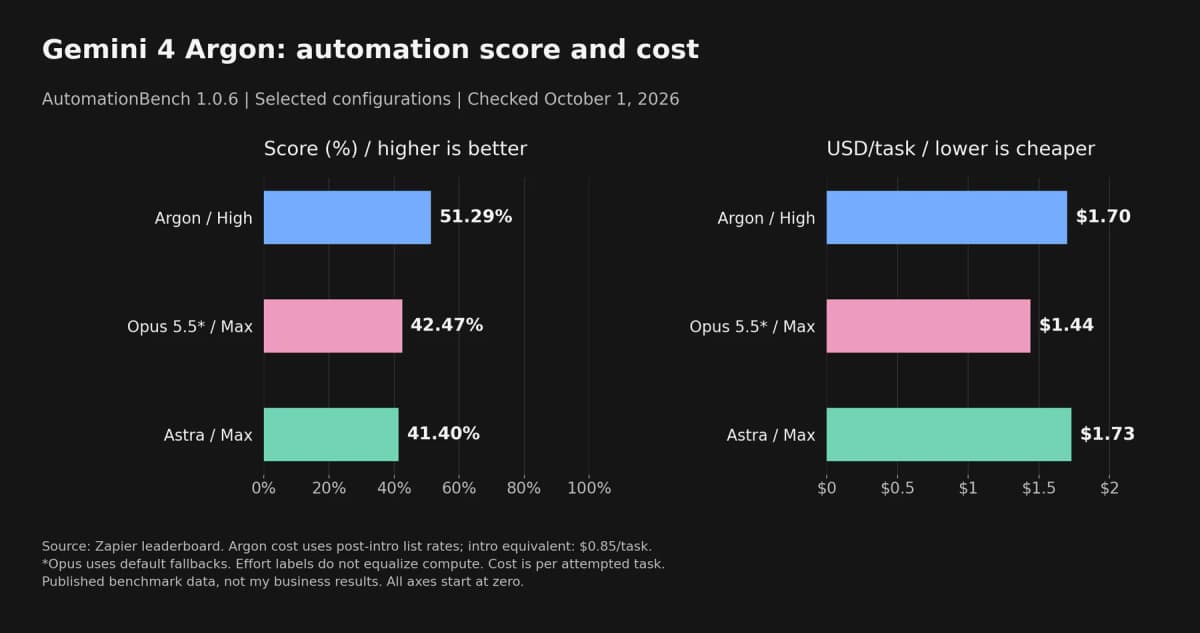
Zapier indique qu'Argon High atteint 51,29 % pour 1,70 $ par tâche tentée en utilisant les tarifs catalogue ultérieurs ; son équivalent au tarif de lancement est de 0,85 $. Opus 5.5 Max avec les replis par défaut obtient 42,47 % pour 1,44 $, et Astra Max obtient 41,40 % pour 1,73 $. Les niveaux d'effort ne correspondent pas aux budgets de calcul entre les fournisseurs.
Argon obtient le meilleur score dans cette comparaison, mais le coût ordinaire de ses tâches n'est pas le plus bas. De même, un score d'environ 51 % à un benchmark ne justifie pas un accès de production sans supervision. Je souhaite toujours une validation pour les actions importantes, des journaux que je peux inspecter et un moyen de récupérer après une exécution partielle.
Cette distinction est importante pour l'automatisation métier. Je veux que le bon enregistrement soit mis à jour et que le bon destinataire reçoive un message. Le fait qu'un agent me dise qu'il a terminé ne peut pas remplacer ces vérifications.
Les résultats de programmation dépendent de la tâche
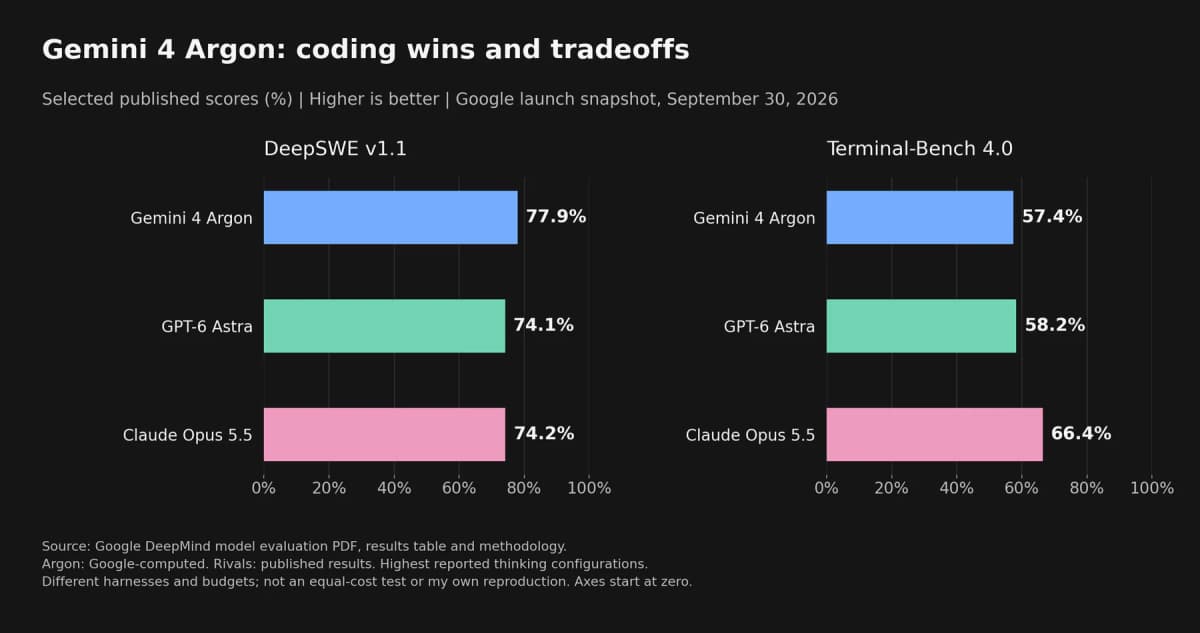
Scores sélectionnés dans le rapport d'évaluation des modèles de Google DeepMind. Ce graphique combine les résultats d'Argon calculés par Google avec les résultats publiés de modèles concurrents ; il ne s'agit pas d'un test comparatif indépendant et uniforme.
Argon atteint 77,9 % sur DeepSWE v1.1, contre 74,1 % pour Astra et 74,2 % pour Opus. Sur Terminal-Bench 4.0, Opus est en tête de ce trio avec 66,4 %, suivi d'Astra à 58,2 % et d'Argon à 57,4 %. Le rapport place également Astra devant sur FrontierSWE v2 : 65,5 % contre 55,0 % pour Argon.
Google indique généralement ses paramètres de réflexion les plus élevés ainsi que les meilleurs résultats ou les résultats maximaux disponibles de ses concurrents. Les harnais et les budgets comptent. Une avance sur un benchmark portant sur un dépôt ne garantit pas une meilleure correction dans ma base de code, surtout lorsque l'écart n'est que de quelques points de pourcentage.
Je testerais séparément une correction de régression limitée et une modification portant sur plusieurs fichiers. Les deux nécessitent des vérifications comportementales et une revue du diff. Un modèle peut réussir le test tout en ajoutant une abstraction que je ne souhaite pas maintenir.
Des éléments indépendants sur le travail intellectuel apportent un contexte supplémentaire
Vals Index 2.1, mis à jour le 30 septembre, classe Argon à 68,90 %, Opus 5.5 à 66,97 %, Astra à 63,13 % et Sol 6.1 à 61,15 %. Vals combine des tâches financières, de programmation, juridiques et fiscales, avec des pondérations sectorielles fondées sur le PIB des États-Unis.
Sa colonne des coûts complique le classement : 15,68 $ par test pour Argon aux tarifs de tokens de 4 $/20 $, contre 3,24 $ pour Sol. Il s'agit de coûts propres au benchmark, et non de devis pour mon travail. Ils montrent pourquoi je conserverais un modèle moins cher dans l'évaluation, même si un autre modèle arrive en tête de la colonne des scores.
Je répartirais les tâches après les avoir mesurées. Les tâches récurrentes faciles et les échecs coûteux ne devraient pas automatiquement utiliser le même modèle.
Que disent les autres utilisateurs d'Argon ?
Les premières discussions sur la sortie de Gemini 4 Argon témoignent de l'enthousiasme, de la frustration face à l'accès restreint et de rappels concernant le tarif ultérieur. Il s'agit de réactions individuelles au lancement, et non d'une enquête représentative ni d'une preuve que ces personnes ont toutes essayé Argon. Les commentaires prédisant plusieurs semaines ou plusieurs mois d'attente relèvent de la spéculation.
Le débat qui m'est le plus utile apparaît dans la discussion de la communauté Rust sur les migrations de bases de code de Google. Un commentateur, nicoburns, estime que la traduction entre langages peut mieux fonctionner parce que la conception originale existe déjà. D'autres décrivent des problèmes de maintenabilité et le temps qu'ils consacrent à corriger le code généré.
Cette discussion concerne l'ingénierie assistée par des agents au sens large. Elle n'établit pas la fiabilité d'Argon dans le monde réel. J'en retiens une leçon pratique : comparer le comportement avec l'original, conserver des modifications faciles à examiner et mesurer le travail humain restant ensuite.
Comment je prévois de tester Gemini 4 Argon
Je suis suffisamment curieux pour donner une vraie chance à Google. Je commencerai par des tâches que je peux vérifier, plutôt que de demander au modèle de tout prendre en charge d'un seul coup.
Je veux consigner le temps écoulé, le coût en tokens, les nouvelles tentatives, l'exactitude et l'effort de revue. La question est de savoir si Argon réduit mon travail total, y compris la vérification et la réparation du résultat.
L'annonce de Google porte également la limite de sortie à un million de tokens. Il s'agit d'un plafond, pas d'un objectif. Je fixerais malgré tout des budgets et des conditions d'arrêt ; une capacité de réflexion accrue doit justifier son coût. Mon article sur les tokens de raisonnement AI et les coûts de calcul explique pourquoi cet arbitrage m'intéresse.
Gemini 4 Argon semble mériter un test. Je n'ai pas suffisamment utilisé Google pour lui accorder une place équitable dans mon workflow. Ces résultats me donnent envie de changer cela lorsque je pourrai accéder au modèle, tout en conservant Sol, Opus et Astra comme alternatives réelles jusqu'à ce que mes propres tests m'en apprennent davantage.