J’utilise Claude Haiku 5.5 pour les traductions, les modifications rapides de texte, les corrections et les tâches légères de déploiement. Ces tâches nécessitent un modèle capable de suivre un brief précis et de terminer le travail sans transformer une petite modification en projet.
Le réglage de l’effort est important, car ces tâches ne sont pas toutes aussi difficiles. Corriger une faute de frappe et traduire une page contenant des termes techniques méritent des points de départ différents.
Ceci est la partie 1 de AI Models in Practice, une série consacrée au choix des modèles pour le travail réel. Les exemples ci-dessous sont des prompts réutilisables et des réglages proposés. Je n’ai pas effectué de comparaison contrôlée de chaque niveau d’effort, et les exemples de traduction sont des exemples éditoriaux, pas des sorties enregistrées de Haiku. Les détails et les prix des modèles ont été vérifiés dans la documentation d’Anthropic le 12 octobre 2026.
Table des matières
Qu’est-ce que Claude Haiku 5.5 ?
Claude Haiku 5.5 est l’option de petit modèle d’Anthropic pour les tâches à fort volume et sensibles au temps. Anthropic l’a lancé le 7 octobre 2026 et le positionne pour les résumés, la classification, l’extraction, le routage et les tâches ciblées de sous-agents. L’identifiant du modèle Claude API est claude-haiku-5-5. Consultez l’annonce de lancement de Claude Haiku 5.5.
La présentation du modèle Haiku 5.5 indique qu’il accepte des entrées textuelles et image, produit du texte, dispose d’une fenêtre de contexte d’un million de tokens et peut générer jusqu’à 128 000 tokens de sortie dans la Messages API. Il utilise par défaut la réflexion adaptative. Une grande fenêtre de contexte décrit une capacité ; elle ne signifie pas qu’il est utile ou économique d’envoyer l’intégralité de votre repository.
Je fournirais à Haiku un paragraphe, un glossaire et une tâche d’édition précise avant de lui demander d’interpréter toute une entreprise. Un brief plus ciblé rend le résultat plus facile à contrôler.
Pour quelles tâches Haiku 5.5 est-il adapté ?
Ma liste pratique commence par les tâches pour lesquelles je l’utilise déjà :
D’autres tâches méritent d’être évaluées, notamment l’extraction de champs à partir d’un document fourni, le classement de messages dans des catégories connues et le résumé d’une courte conversation avec le support. Il s’agit d’utilisations proposées, et non de résultats issus de mon propre benchmark.
Pour les tâches d’ingénierie générales, le choix du modèle mérite un nouvel examen. Le contenu de lancement d’Anthropic recommande Sonnet 5.5 et Opus 5.5 pour le coding agentique plus complexe. Augmenter l’effort de Haiku ne garantit pas les mêmes capacités que celles d’un modèle plus grand.
Que signifient les cinq niveaux d’effort ?
Haiku 5.5 prend en charge low, medium, high, xhigh et max. La valeur par défaut est medium. L’effort oriente la quantité de travail consacrée par le modèle à une réponse ; il ne s’agit ni d’un budget fixe de tokens ni d’une garantie de précision. Il influence la réflexion, le texte de réponse et les appels d’outils. Consultez la documentation d’Anthropic sur l’effort.
| Effort | Indication officielle de départ | Utilisation que je propose |
|---|---|---|
low | Tâches courtes, simples et sensibles à la latence | Une correction de faute de frappe ou une traduction courte et sans ambiguïté |
medium | Valeur par défaut pour la plupart des tâches, y compris le coding ciblé | Une traduction normale ou une petite modification de texte avec contraintes |
high | Travail de connaissance, tâches agentiques plus longues, respect strict des instructions | Une terminologie ambiguë ou une modification devant respecter plusieurs règles |
xhigh | À utiliser lorsque les évaluations démontrent un gain de qualité | Une expérience sur une tâche difficile et délimitée ; comparer avec Sonnet |
max | À utiliser lorsque les évaluations justifient le coût supplémentaire | Un cas de test exceptionnel, après vérification des niveaux inférieurs |
Ma règle de départ serait medium, puis ajuster en fonction des erreurs observées. Pour une correction triviale, essayez low. Pour une traduction sensible au glossaire, comparez medium et high. Gardez le prompt et les entrées identiques afin de déterminer si le réglage a réellement aidé.
Un déploiement peut ne comporter qu’une seule commande tout en ayant des conséquences importantes. Je choisirais ses exigences de vérification et d’approbation indépendamment de l’effort.
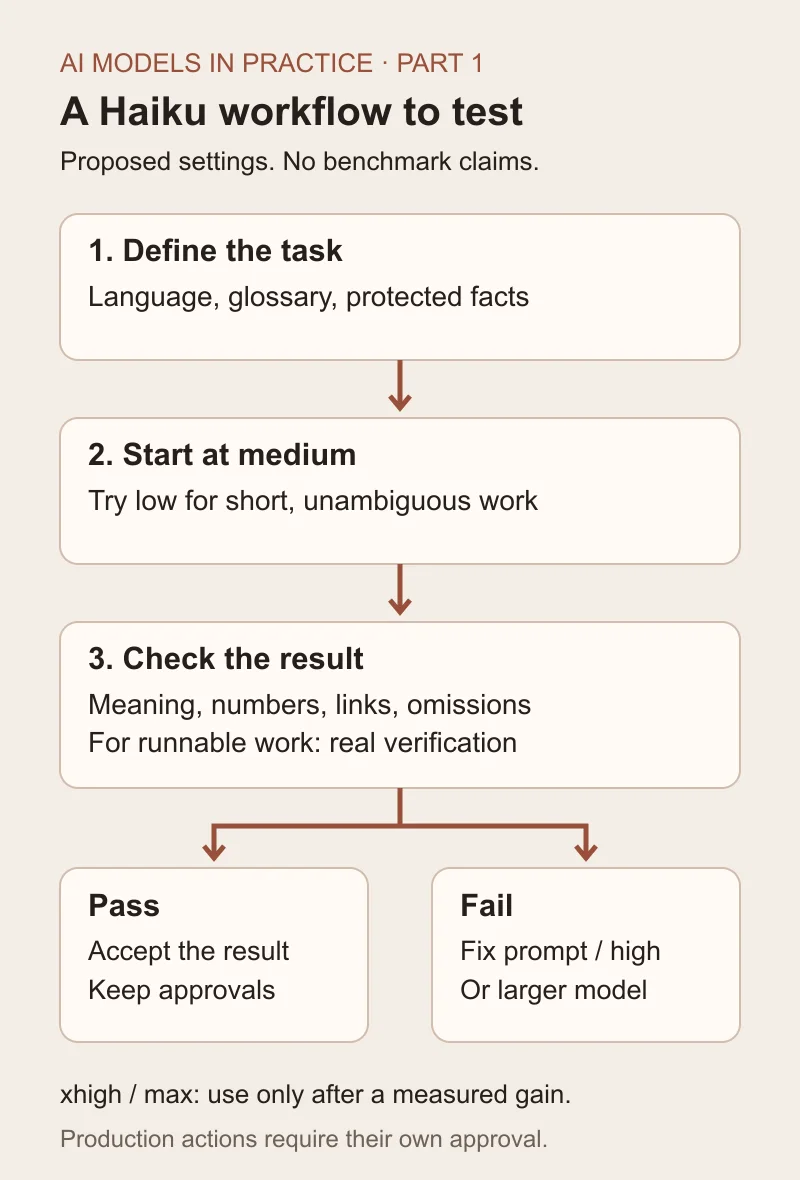
Workflow proposé, et non preuve issue d’un benchmark. L’acceptation signifie que le résultat a passé les contrôles prévus pour cette tâche ; la publication et les actions en production conservent leurs propres étapes d’approbation.
Comment réglerais-je l’effort pour les traductions ?
La traduction est l’exemple le plus clair de la raison pour laquelle une valeur par défaut unique ne peut pas convenir à tout. Ces réglages sont des hypothèses de départ pour l’évaluation, et non des gagnants mesurés.
Low pour un texte court et littéral
Un court message d’état comporte peu d’ambiguïté :
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
Une référence éditoriale acceptable serait : « Your order 1842 was dispatched on 12 October 2026. » Les contrôles importants portent sur le numéro de commande, la date et le sens. Plusieurs formulations anglaises peuvent être acceptées.
J’essaierais low ici, puis j’augmenterais le niveau si un détail disparaît. Ajouter davantage de réflexion à ce prompt devrait être justifié par une amélioration du résultat.
Medium pour un contenu web normal
Pour un paragraphe, je commencerais à medium en indiquant l’audience, la locale, le ton et les termes protégés :
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
Une référence éditoriale pourrait être : « We normally update the page within two working days. It may take longer if we need additional information. » Une version qui promet une mise à jour sous deux jours a modifié l’affirmation.
Le guide d’Anthropic sur la prise en charge multilingue recommande d’indiquer les langues source et cible et de tenir compte du contexte régional. Son tableau des langues publié couvre des modèles plus anciens, notamment Haiku 4.5 ; il ne constitue pas une preuve de la précision de traduction de Haiku 5.5.
High lorsque la terminologie ou l’ambiguïté nécessite une attention particulière
Certains termes dépendent du contexte de l’entreprise. Le mot suédois « reklamation » ne devrait pas automatiquement devenir « advertising ». Selon la phrase, une traduction anglaise appropriée pourrait désigner une réclamation ou une demande concernant un produit défectueux.
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
Je comparerais medium et high pour ce type de tâche. Le critère de réussite est de savoir si la traduction préserve la condition et utilise la terminologie prévue. Une formulation fluide ne suffit pas à elle seule.
Pour le contenu structuré, j’enverrais des chaînes traduisibles avec des identifiants stables. Mon application vérifierait que chaque identifiant est renvoyé une seule fois et que les valeurs protégées sont conservées. Demander à un modèle de préserver un fichier JSON volumineux ne remplace ni l’analyse syntaxique ni la validation.
Modifications rapides et corrections de texte
Un prompt de correction devrait définir les modifications autorisées. Sinon, une demande de correction grammaticale peut se transformer en réécriture.
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
La référence éditoriale est : « We have updated the page, but the payment tests are not finished yet. » Une version affirmant que la page est entièrement testée ne respecte pas le brief.
Low est un réglage raisonnable à évaluer pour une phrase comme celle-ci. Medium est mon point de départ proposé pour plusieurs paragraphes, des liens protégés ou plusieurs contraintes.
Pour une modification de texte, demandez un résultat précis : « Réduis ce texte à 80 mots, préserve les deux limitations et conserve le lien. » Le nombre de mots et la préservation du lien sont des contrôles que vous pouvez effectuer indépendamment du modèle.
Tâches légères de déploiement : définir ce qui signifie “terminé”
J’inclus les tâches simples de déploiement parmi mes utilisations de Haiku, mais le terme « simple » doit correspondre à un périmètre explicite. Une procédure de déploiement connue pour une modification de texte approuvée est une tâche différente du diagnostic d’une release défaillante ou de la décision de migrer une base de données.
Une instruction réutilisable pourrait être :
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
Pour la préparation et les contrôles, je commencerais à medium. Si le travail nécessite d’enquêter sur des défaillances entre plusieurs systèmes, je réévaluerais le modèle et l’effort au lieu de le qualifier de tâche légère.
Le guide de prompting spécifique à Haiku d’Anthropic indique que des agents à faible effort accompagnés de longs prompts peuvent s’arrêter trop tôt ou omettre des contrôles. Il recommande des instructions de vérification explicites. Le guide mentionne également des réponses visibles parfois vides dans les conversations à plusieurs tours avec xhigh, ainsi que des problèmes d’appels d’outils lorsque la réflexion est désactivée en même temps que la sortie structurée. Une intégration doit détecter les résultats incomplets plutôt que les accepter silencieusement.
Comment modifier l’effort dans Claude ou l’API ?
Dans l’application Claude, ouvrez le menu du modèle à côté du bouton d’envoi, sélectionnez Haiku 5.5, puis choisissez Effort. Les choix disponibles peuvent dépendre des réglages du compte ou de l’administrateur. Anthropic indique que la réflexion ne peut pas être désactivée pour Haiku 5.5 dans l’application Claude. Consultez Modifier les réglages du modèle, de l’effort et de la réflexion.
L’API offre un contrôle plus direct. Le corps minimal d’une requête ressemble à ceci :
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
Il s’agit d’une structure de requête illustrative, et non d’une requête que j’ai exécutée. Fournissez le paragraphe dans le message utilisateur. max_tokens est une limite, pas une réservation ni une instruction de produire une réponse longue.
Le guide de migration vers Haiku 5.5 d’Anthropic explique que la réflexion consomme ce budget de sortie ; une limite faible peut donc tronquer la réponse avant l’apparition du texte visible. Sélectionnez les blocs de réponse en fonction de leur type, plutôt que de supposer que le premier bloc contient la réponse.
Pour les nouvelles requêtes API, omettez temperature, top_p et top_k. Remplacez l’ancienne configuration combinant la réflexion activée et budget_tokens par la réflexion adaptative. L’API autorise la réflexion désactivée avec low, medium et high ; xhigh et max nécessitent la réflexion adaptative. Le guide répertorie également les différences entre fournisseurs ; validez donc votre plateforme réelle avant la migration.
Conservez la clé API côté serveur. Le champ d’effort est un paramètre de configuration, pas une raison de placer des identifiants dans le code frontend.
Combien coûte Haiku 5.5 ?
La documentation de tarification de l’API d’Anthropic indique les tarifs standard suivants en USD par million de tokens, vérifiés le 12 octobre 2026 :
| Longueur du prompt | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Jusqu’à 100 000 tokens | $0.10 | $0.50 | $0.01 |
| Plus de 100 000 tokens | $0.50 | $2.50 | $0.05 |
Le tarif supérieur s’applique à la requête, y compris aux entrées comptabilisées comme lectures ou écritures du cache. Il s’agit des prix des tokens de l’API ; un abonnement Claude est un produit distinct. Les écritures du cache, les outils serveur et les modificateurs de plateforme peuvent entraîner des coûts supplémentaires.
Pour une requête illustrative sans cache contenant 2 000 tokens d’entrée et 1 000 tokens de sortie totale facturés :
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
Ce calcul exclut les frais supplémentaires et ne constitue pas un coût de traduction mesuré. La réflexion est incluse dans la sortie facturée. Un effort plus élevé peut modifier l’utilisation des tokens ; le tableau des prix ne suffit donc pas à prédire le coût d’une tâche terminée.
Bonnes pratiques que je conserverais pour ces tâches
Donnez au modèle la plus petite tâche complète possible. Incluez le glossaire ou le texte source approuvé dont il a besoin et évitez les éléments sans rapport.
Définissez le contrat de sortie. Pour une traduction, indiquez les deux langues et la locale. Pour une modification, précisez quels faits et quels éléments de formatage doivent être conservés. Pour un agent, définissez les contrôles et le point d’arrêt.
Traitez le texte source comme du contenu à transformer. Une phrase intégrée dans un document ne doit pas acquérir l’autorité de modifier la tâche, d’accéder à des identifiants ou de publier du contenu.
Validez le résultat par rapport à la tâche. Vérifiez les termes protégés, les chiffres, les liens et les passages manquants. Pour le code ou le déploiement, examinez les preuves réelles issues des tests et de l’exécution.
Augmentez le niveau en vous appuyant sur un échec concret. Un qualificatif manquant suggère un autre prompt ou un autre niveau d’effort. Une tâche qui ne cesse de s’étendre peut nécessiter Sonnet ou Opus. Les échecs répétés doivent déclencher une révision, et non une augmentation sans fin de l’effort.
Comment testerais-je les réglages avant de m’y fier ?
Je constituerais un petit ensemble d’évaluation à partir de 20 exemples approuvés et anonymisés : dix traductions, cinq corrections et cinq modifications de texte contraintes. Ces nombres décrivent un test proposé, et non une recherche terminée.
J’exécuterais low, medium et high avec les mêmes entrées et les mêmes critères d’acceptation. Je répéterais les cas afin de révéler les comportements incohérents. Un réviseur maîtrisant la langue évaluerait les traductions sans connaître le réglage utilisé.
J’enregistrerais le modèle exact, l’effort, la version du prompt, le temps écoulé, les tokens facturés et les défauts. Je compterais les qualificatifs perdus, les chiffres modifiés, les liens cassés, les textes omis et les réécritures inutiles. Je comparerais le coût par résultat accepté, en incluant le travail de correction.
Pour l’assistance au déploiement, j’évaluerais des tâches de préparation distinctes dans un environnement hors production avec un résultat attendu connu. Les actions en production restent soumises à la procédure d’approbation du projet.
Mon guide existant sur le benchmarking des modèles AI pour le travail réel→ présente l’approche d’évaluation plus large. La comparaison entre GPT-6.1 Sol et Opus 5.5→ fournit un contexte pour le choix de modèles plus grands ; il ne s’agit pas d’un test de traduction de Haiku.
La série commence par les petites tâches
Haiku constitue la première partie, car les traductions, les corrections et les modifications courtes rendent les compromis visibles. Vous pouvez vérifier si une phrase a conservé son sens et si un lien a été préservé.
Les prochaines parties proposées porteront sur Sonnet pour le coding et l’analyse quotidiens, sur Opus pour les tâches plus difficiles, puis sur un guide final consacré au routage des tâches entre les modèles. Chaque partie conservera la même distinction : capacités documentées, utilisation réelle de ma part et tests restant à effectuer.