Die Black Box der LLMs ist ein praktisches Problem: Ein Modell kann innerhalb von Sekunden eine schwierige Frage beantworten, ohne dass wir erklären können, welche internen Berechnungen dazu geführt haben. Am 15. Oktober 2026 veröffentlichte Nick Cammarata, Mitautor von OpenAIs Neuronenstudie von 2023, als Goodfire-Forscher Neural Networks Are Already Clean. Er argumentiert, dass diese „Black Box“ möglicherweise leichter zu untersuchen ist, als das Forschungsfeld angenommen hat. Die These verdient Aufmerksamkeit. Sie muss jedoch sorgfältig gelesen werden: Der Essay ist eine Arbeitshypothese, und die begleitende technische Arbeit über Neuronen in Sprachmodellen steht noch aus.
Die nützliche Frage ist, ob Forschende von einer interessanten Beschreibung eines Neurons zu einer zuverlässigen Erklärung des Verhaltens eines Modells gelangen können. Cammarata liefert neue Belege für den ersten Schritt und mehrere kausale Demonstrationen für den zweiten. Beides ergibt noch keine vollständige Karte eines Large Language Models.
Für eine Zusammenfassung in einfacher Sprache springe zur einfachen Version.
Warum besteht die Black Box der LLMs fort?
Forschende kennen die mathematischen Operationen in einem trainierten Netzwerk. Die Schwierigkeit besteht darin zu erklären, wie Millionen gelernter Komponenten zusammenwirken, um eine bestimmte Antwort zu erzeugen. Ein einzelnes künstliches Neuron kann auf Beispiele reagieren, die scheinbar nichts miteinander zu tun haben. Wenn es sowohl auf das Gesicht einer Katze als auch auf die Front eines Autos reagiert, was stellt es dann tatsächlich dar?
Eine einflussreiche Antwort darauf war Superposition: Ein Modell könnte nicht zusammenhängende Merkmale in überlappenden internen Richtungen bündeln, weil ihm nur begrenzter Raum zur Verfügung steht. Forschende trainieren dann ein zweites Modell, häufig einen Sparse Autoencoder, um diese Merkmale zu trennen.
Cammarata argumentiert, dass einige der klassischen Belege für dieses Bild falsch interpretiert wurden. Die scheinbare Mischung könnte stattdessen ein gemeinsames Muster, ein unvollkommenes Mikroskop oder eine Netzwerkarchitektur widerspiegeln, die das Training späterer Schichten erschwert hat. Seine Definition von Superposition bezieht sich ausdrücklich auf das Bündeln nicht zusammenhängender Berechnungen in demselben Mechanismus; andere Forschende verwenden das Wort allgemeiner für die Darstellung von mehr Konzepten, als Dimensionen vorhanden sind. Sein Essay erklärt diese Unterscheidung.
Was hat sich in der neuen Forschung geändert?
Das bekannte Neuronenbeispiel mit Katze und Auto stammte aus einem Vision-Modell, nicht aus einem LLM. Cammarata beschreibt es nun als Reaktion auf ein gemeinsames visuelles V-förmiges Muster. Seiner Darstellung zufolge bündelt das Neuron verwandte visuelle Strukturen, anstatt zwei beliebige Konzepte in einem Slot zu verbergen. Außerdem berichtet er, dass nach architektonischen Änderungen an InceptionV1, einem Vision-Modell, 99–100 % der Neuronen in seiner letzten Schicht leicht interpretierbar wurden, während Modellgröße und Trainingsdaten unverändert blieben. Das ist eine Aussage über eine neu trainierte Schicht eines Vision-Modells. Es ist keine Statistik über moderne Chat-Modelle.
Die Belege für Sprachmodelle sind für LLMs relevanter, aber auch vorläufiger. Das Team von Goodfire schätzt, dass bei einer ersten Untersuchung von Qwen3-32B etwa 90 % der Neuronenpole eine Hauptaufgabe haben, oft mit kleinen verwandten Ausläufern. Weitere ungefähr 7 % haben zwei verwandte Aufgaben, und etwa 2–4 % bleiben ungeklärt.
Ein „Pol“ bezeichnet eine Seite der positiven oder negativen Reaktion eines Neurons; der Prozentsatz bedeutet nicht, dass 90 % des Verhaltens eines LLMs erklärt wurden. Cammarata sagt, dass sich die Klassifizierung mit dem Schwellenwert für schwache Aktivierungen, der Modelltiefe, der Schaltungsdichte und der Frage ändert, was als eine Aufgabe gilt. Diese Einschränkungen stehen neben der Schätzung.
Das Team liefert mehr als nur Bezeichnungen für Aktivierungen. Sein interaktiver Essay enthält 1.000 zufällig ausgewählte Fallstudien zu Neuronen aus Qwen3-32B und Qwen3.6-35B-A3B. In einem Test nutzte ein Agent schriftliche Erklärungen, um Beispiele zu erfinden, die ein Neuron aktivieren sollten, sowie Beinahe-Treffer, die dies nicht tun sollten. Unter 183 Neuronen mit Erklärungen für ihre positive Seite aktivierten die neuen Beispiele in 76 % der Fälle stark, gegenüber 11 % bei den Beinahe-Treffern. Das ist innerhalb des Versuchsaufbaus des Teams ein nützlicher Vorhersagetest. Er belegt nicht, dass die Beschreibungen jede wichtige Aktivierung oder jeden nachgelagerten Effekt erfassen.
Können die Forschenden die Antwort eines LLMs durch Eingriffe verändern?
Ja, in ausgewählten Beispielen. Goodfire verfolgt Gruppen von Neuronen in Qwen3-32B und entfernt sie anschließend, um zu sehen, was sich verändert. In einem Prompt, dessen Hinweise auf den Weihnachtsmann hindeuten, senkte das Entfernen von acht ausgewählten, mit der Antwort verbundenen Neuronen die vom Modell angegebene Wahrscheinlichkeit für „Santa“ auf 0,059; das Entfernen derselben Anzahl zufälliger Neuronen aus passenden Schichten ließ sie bei 0,997. Das ist ein Beleg dafür, dass diese ausgewählten Neuronen für diesen Prompt und die Vorhersage des nächsten Wortes relevant waren. Es ist keine gemessene Erfolgsquote über beliebige Prompts oder Modelle hinweg. Der Eingriff und die Kontrollbedingung werden im ursprünglichen Essay gezeigt.
Cammarata zeigt außerdem einen auf Neuronen basierenden Attributionsgraphen für Kimi K3, ein Modell mit mehreren Billionen Parametern. Das Wallet-Beispiel verfolgt einige Pfade vom Prompt zu einer Antwort über die Rückgabe verlorenen Eigentums. Der Essay bezeichnet die dargestellten Gruppen als einen von Hand ausgewählten Ausschnitt und sagt, dass vollständige Untersuchungen in dieser Größenordnung noch nicht begonnen haben. Ein lesbarer Ausschnitt eines sehr großen Modells ist vielversprechend, kann uns aber nicht sagen, was jeder ausgelassene Pfad bewirkt hat.
Wie reagieren andere Forschende?
Am 17. Oktober veröffentlichte der Forscher Leo Gao Neural networks are not already clean. Er stimmt zu, dass frühere Arbeiten Neuronen möglicherweise zu schnell als polysemantisch bezeichnet haben.
Sein Einwand lautet, dass eine ordentliche Beschreibung der stärksten Beispiele dennoch Eingaben übersehen kann, die das Neuron aktivieren sollten, schwache Reaktionen, die relevant sind, oder die Bedeutung der Aktivierungsstärke. Gao schlägt einen strengeren Test vor: Die Werte des Neurons sollen durch Werte ersetzt werden, die aus der Erklärung vorhergesagt wurden; anschließend soll gemessen werden, ob sich das restliche Modell weiterhin gleich verhält. Wenn sich das Verhalten verschlechtert, hat die Erklärung etwas Wichtiges übersehen.
Neel Nandas direkte Antwort macht eine verwandte Unterscheidung. Er sieht praktischen Nutzen darin, native Neuronen und Attributionsgraphen zu verwenden, um ein bestimmtes verdächtiges Verhalten zu untersuchen. Er bleibt jedoch nicht überzeugt, dass dies beweist, dass ambitioniertes Reverse Engineering kurz bevorsteht, und verweist besonders auf schwache Aktivierungen in LLMs sowie auf Informationen im Residual Stream. Cammarata selbst sagt, dass Attention in dieser Arbeit weniger gut verstanden ist und dass riesige Sprachmodelle noch weit von einer vollständigen Kartierung entfernt sind.
Die Uneinigkeit ist produktiv. Goodfire fragt, ob die eigenen Komponenten des Netzwerks der Ausgangspunkt für Interpretierbarkeit sein können. Gao und Nanda fragen, wie viel eine Erklärung vorhersagen muss, bevor wir ihr vertrauen können. Ein Neuron kann verständlich wirken, kausal an einer Antwort beteiligt sein und dennoch wichtiges Verhalten zeigen, das wir nicht erfasst haben.
Zwei weitere Reaktionen verschärfen die Beweislast. In derselben öffentlichen Diskussion bittet John Wentworth um eine Erklärung des vorgestellten ConvNeXt-Vision-Modells Neuron für Neuron, einschließlich der Belege für jede Interpretation. Er sagt, dass ihm das öffentliche Mikroskop allein die Bedeutung dieser Neuronen nicht unmittelbar verständlich gemacht habe. Das ist eine Forderung nach einem überprüfbaren Artefakt, kein Test, der die LLM-Ergebnisse widerlegt. Alex Gibson weist auf eine andere Lücke hin: Der Essay bezeichnet seine größte Schlussfolgerung als hochspekulativ, während einige kurze Beiträge in sozialen Medien sicherer klingen. Dies sind frühe Einzelreaktionen, kein feldweiter Konsens.
Macht das ein AI-System sicher oder transparent?
Aus diesen Ergebnissen folgt kein Sicherheitszertifikat. Eine Erklärung für ein einzelnes Neuron ist eine lokale Aussage. Ein Attributionsgraph ist eine unvollständige Darstellung einer einzelnen Berechnung. Eine Aussage über die Sicherheit auf Systemebene würde eine Abdeckung wichtiger Schaltkreise, zuverlässige Tests auf übersehenes Verhalten und Belege dafür erfordern, dass die Methode über die zur Untersuchung ausgewählten Beispiele hinaus funktioniert. Für ein System mit Tools müssen Berechtigungen von AI-Agenten→ weiterhin begrenzen, was das Modell tun kann, unabhängig davon, wie lesbar seine internen Schaltkreise werden.
Die technische Arbeit von Goodfire zu Sprachmodellen und eine unabhängige Replikation werden hier von Bedeutung sein.
Es gibt außerdem eine Zugangsgrenze. Diese Experimente untersuchen interne Aktivierungen und greifen in Komponenten ein. Wenn dein Produkt lediglich eine gehostete Chat-API aufruft, kannst du dieselben Tests an diesem Modell nicht über gewöhnliche Prompts durchführen.
Die einfache Version
Eine Frage geht in ein AI-Modell hinein, und eine Antwort kommt heraus. Der schwierige Teil besteht darin zu wissen, was im Inneren passiert ist.
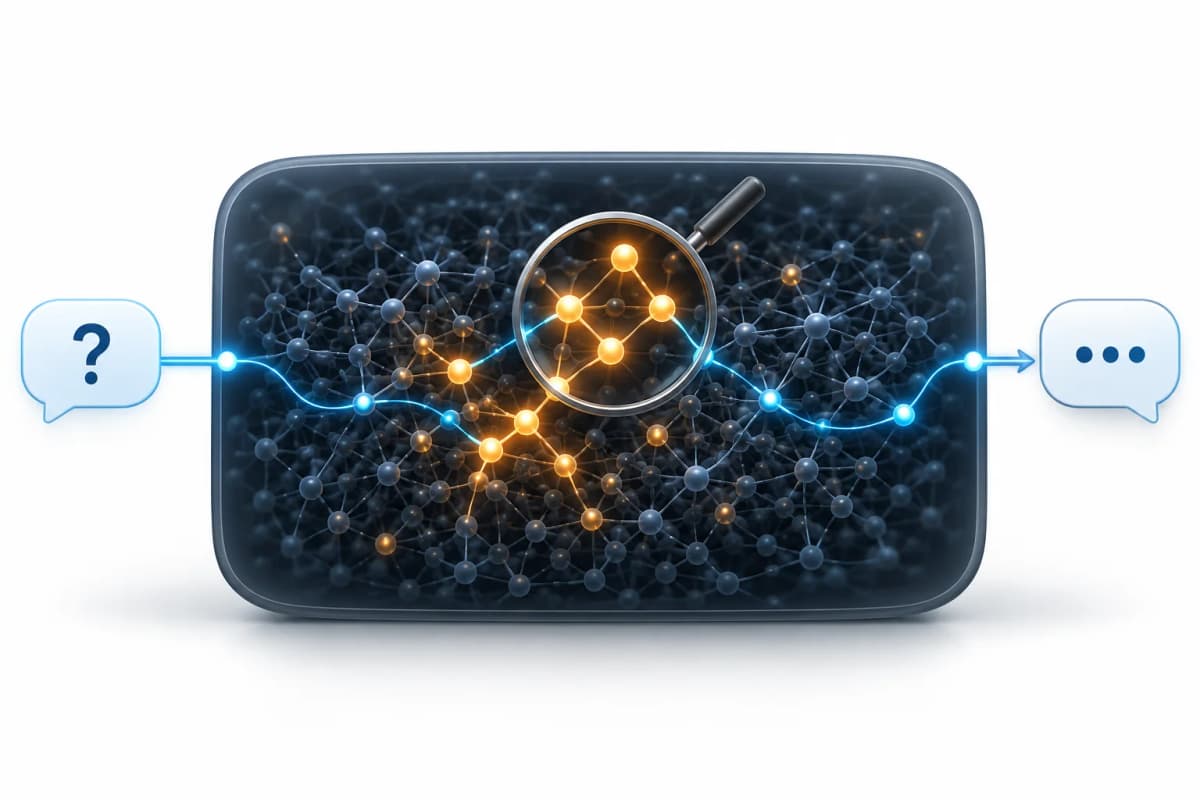
Was passiert ist: Goodfire untersuchte kleine Teile eines Sprachmodells, die als Neuronen bezeichnet werden. In ausgewählten Tests konnten Forschende beschreiben, was einige von ihnen tun, und eine Antwort verändern, indem sie diese entfernten.
Warum das wichtig ist: Die inneren Abläufe des Modells könnten leichter zu untersuchen sein, als viele Forschende erwartet hatten.
Was das nicht bedeutet: Wir können noch nicht jede Antwort erklären oder das Modell als sicher bezeichnen. Wenn du mit gewöhnlichen AI-APIs arbeitest, solltest du weiterhin Ausgaben testen und die Handlungsmöglichkeiten der AI begrenzen. Spätere Studien könnten zu besseren Tools für das Debugging und Monitoring von Modellen führen.
Was bedeutet das heute für AI-Produkte?
Für die Agenten- und Content-Workflows, die ich entwickle, liefert dieses Ergebnis keinen neuen Schalter, den wir umlegen können. Die unmittelbare Arbeit besteht darin, die Aufgaben zu testen, die Nutzer tatsächlich ausführen, Quellen und faktische Aussagen zu prüfen, das Verhalten von Modell und Tools zu protokollieren, Tool-Berechtigungen einzuschränken und vor folgenreichen externen Aktionen eine menschliche Genehmigung zu verlangen. Diese Kontrollen adressieren beobachtbare Fehler, unabhängig davon, ob die Neuronen des Modells verständlich sind.
Du kannst das externe Verhalten eines gehosteten Modells weiterhin bewerten. Mein früherer Leitfaden zur Kalibrierung von LLM-Konfidenzwerten→ behandelt eine solche Aufgabe: zu prüfen, ob ein Wert die Korrektheit in deiner eigenen Arbeit widerspiegelt. Das misst eine andere Frage als mechanistische Interpretierbarkeit, und für beides sind klare Grenzen erforderlich.
Bevor ich einen internen Monitor einsetzen würde, würde ich fragen, welches Verhalten er bei zurückgehaltenen Daten erkennt, wie oft er schädliche Fälle übersieht oder harmlose Fälle unterbricht, ob er vor einem Tool-Aufruf handelt und ob der Anbieter die erforderlichen Aktivierungen tatsächlich bereitstellt. Gewöhnliche API-Ausgaben beantworten diese Fragen nicht.
Was könnte sich langfristig ändern?
Wenn andere Teams die Ergebnisse zu den Neuronen reproduzieren und die wichtigen Pfade zwischen Neuronen verfolgen können, könnten Modellentwickler Fehler auf der Ebene der Mechanismen diagnostizieren, statt nur Ausgaben zu untersuchen. Cammarata skizziert außerdem automatisierte Forschungsagenten und die vorsichtige Veränderung einer Trainingsumgebung, die sich als schädlich erweist, als mögliche zukünftige Schritte. Das sind Vorschläge, die getestet werden müssen, keine durch diesen Essay etablierten Fähigkeiten.
Eine verwandte Richtung hat bereits ein konkretes Beispiel. In einer separaten Goodfire-Studie zu Kimi K3 speist eine Aktivierungssonde ein zweites Modell, das beurteilt, ob eine riskante Interaktion eines Agenten unterbrochen werden soll. Goodfire berichtet in seinen eigenen Bewertungen von vielversprechenden Ergebnissen. Dieser Monitor benötigt Zugriff auf interne Aktivierungen, und die Studie validiert Cammaratas Erklärungen der Neuronen nicht. Sie zeigt, was Signale auf Modellebene einem Anbieter oder einer Bereitstellung mit offenen Gewichten künftig möglicherweise bieten könnten; ein API-Kunde würde einen zugänglichen Dienst und eine eigene aufgabenspezifische Bewertung benötigen.
Eine bessere interne Sichtbarkeit könnte Sicherheitsprüfungen unterstützen und zugleich die Modellentwicklung beschleunigen. Das Gleichgewicht ist unbekannt. Ein nützlicher zukünftiger Standard würde von Anbietern verlangen zu zeigen, welche Verhaltensweisen ihre internen Erklärungen abdecken, wo sie versagen und ob ein Monitor in realistischen Workflows besser ist als Prüfungen, die nur Ausgaben betrachten.
Worauf sollten wir als Nächstes achten?
Ich würde in der angekündigten technischen Arbeit und in Folgestudien nach fünf Beweisstücken suchen:
Meine Einschätzung ist, dass Goodfire überzeugend dafür argumentiert hat, die nativen Neuronen eines Modells genauer zu untersuchen. Das Unternehmen hat Forschenden außerdem bessere Experimente geliefert, über die sie diskutieren können. Am 17. Oktober 2026 lautet die stärkste Schlussfolgerung enger als „Die Black Box der LLMs ist gelöst“: Einige Teile könnten verständlicher sein als erwartet, und der Weg von verständlichen Teilen zu zuverlässigen Erklärungen des gesamten Modells ist weiterhin offen. Für Teams, die auf gehosteten APIs aufbauen, bleiben Verhaltenstests und Berechtigungsgrenzen der praktische Ausgangspunkt.
Primärquellen: Cammaratas Forschungsessay, Gaos Antwort, die direkte Diskussion der Forschenden und Goodfires separate Studie zu Aktivierungsmonitoren.