Ich bin gerade von der Arbeit nach Hause gekommen, und OpenAI hat mir einen guten Grund gegeben, den Laptop wieder aufzuklappen. GPT-6.2 Astra und Sol sind da. Heute Abend möchte ich sie an der Arbeit ausprobieren, die mir wichtig ist: Änderungen an einer Codebasis, anspruchsvolle Recherche und visuelle Ergebnisse, die über einen Screenshot hinaus funktionieren müssen.
Ich freue mich darauf, loszulegen. Diese Tests habe ich noch nicht abgeschlossen. Dies ist eine Launch-Analyse und ein Testplan, bei dem veröffentlichte Messungen und erste Reaktionen von meinen eigenen zukünftigen Ergebnissen getrennt bleiben.
Worin sind GPT-6.2 Astra und Sol laut OpenAI gut?
In Introducing GPT-6.2 Astra and Sol positioniert OpenAI Astra für die anspruchsvollsten professionellen Projekte und Sol für effiziente alltägliche Arbeit. Das Versprechen lautet: bessere fertige Ergebnisse mit weniger Output-Tokens – saubererer Code, stärkere visuelle Arbeit und Dokumente, die dem Briefing genauer folgen.
OpenAI hebt außerdem Wissenschaft und lang laufende Agent-Workflows hervor. Der FrontierCode-Vergleich ordnet Sol bei maximalem Aufwand innerhalb von 0,5 Punkten von Astra und bei etwa einem Fünftel der Aufgabenkosten ein. Das ist ein Ergebnis für diese Evaluation und kein Versprechen für meine Repositories.
Die Modelle sind über ChatGPT Work, Codex und die API verfügbar. Zum Launch werden Zugänge für Plus, Pro, Enterprise und Edu genannt, jeweils mit Bedingungen für Workspaces und Ultrafast. Prüfe deinen tatsächlichen Tarif, statt anzunehmen, dass API-Preise deine Abonnement-Nutzung beschreiben.
Meine Ausgangswahl lautet Sol für die wiederholbare Arbeit, Astra für den schwierigen Vergleich. So plane ich, die Tests heute Abend aufzuteilen. Das ist kein Urteil darüber, dass eines der beiden Modelle immer die bessere Wahl sein wird.
Die Benchmarks haben keinen universellen Sieger
Die unabhängigen Tabellen sind hilfreicher als eine einzelne Schlagzeile über einen Sieg. Artificial Analysis führt Astra, Sol und Fable 5.2 mit diesen gerundeten Intelligence-Index-Werten in den jeweils aufgeführten Maximalkonfigurationen: 62, 57 und 65.
Der Eintrag von Fable ist mit Max, Default Fallback gekennzeichnet. Behandle diese Konfiguration als Teil des Ergebnisses und nicht als Fußnote, die man ignorieren kann. Diese Indexpunkte sind keine Prozentsätze gelöster Aufgaben.
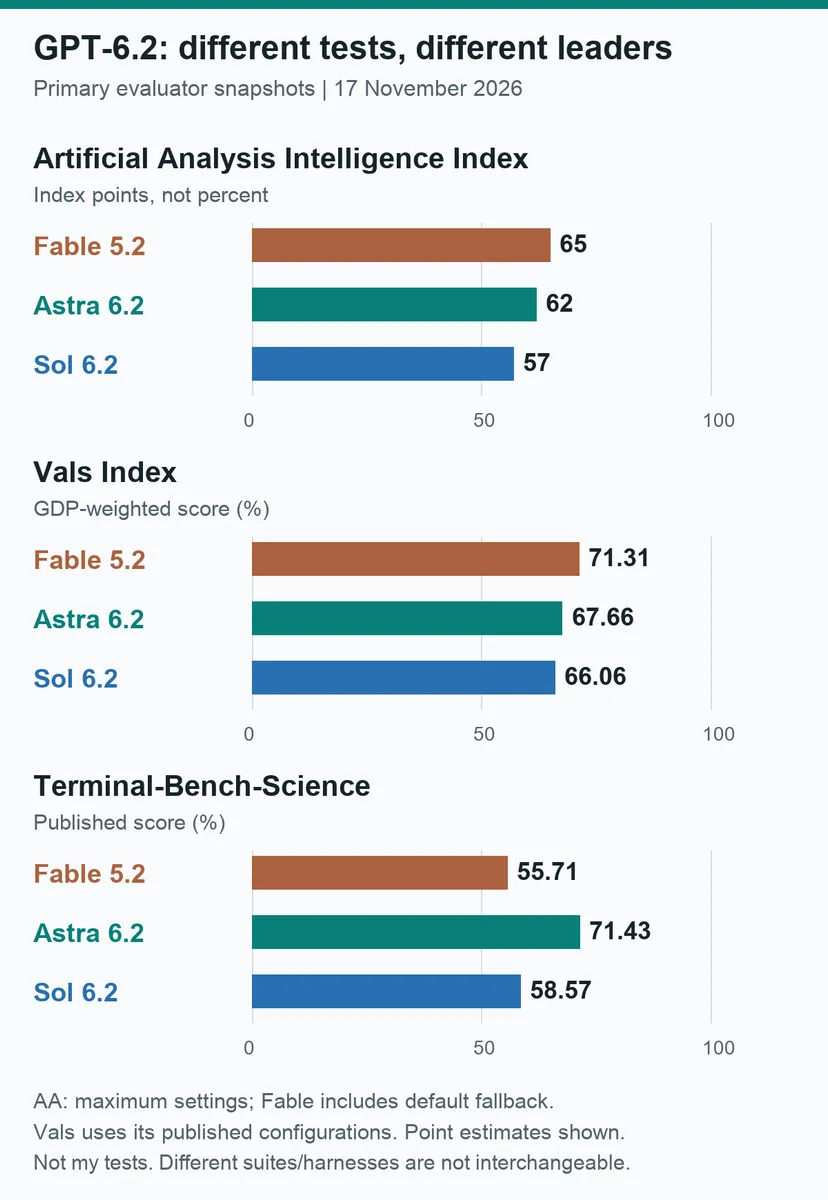
Das Diagramm wurde anhand der veröffentlichten Snapshots der Evaluatoren vom 17. November neu erstellt und basiert nicht auf meinen eigenen Tests. AA verwendet seinen v5.0.1-Index und die aufgeführten Maximaleinstellungen; Vals verwendet die veröffentlichten Konfigurationen. Punktschätzungen werden ohne Unsicherheitsintervalle dargestellt. Verschiedene Suiten und Harnesses sind nicht austauschbar.
Der Vals-Vergleich macht den Zielkonflikt deutlich:
| Modell | AA-Indexpunkte | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra führt diesen wissenschaftlichen Vergleich von Terminal-Workflows an. Fable führt den breiteren Vals Index an. Sol liegt bei diesen Punktschätzungen hinter Astra, bietet dafür niedrigere API-Tokenpreise. Keine der beiden Tabellen misst, wie viele Korrekturen mein konkretes Projekt benötigen wird.
Es gibt noch eine weitere Vergleichsfalle: OpenAI weist in den Launch-Notizen darauf hin, dass das zitierte wissenschaftliche Fable-Ergebnis ein anderes Agent-Harness verwendet als das veröffentlichte Claude-Code-Ergebnis von Anthropic. Ich würde diese Werte nicht in ein gemeinsames Diagramm übernehmen und den Unterschied als Modellverbesserung bezeichnen.
Als Kontext zur anderen Seite des Vergleichs behandelt mein Artikel über Fable 5.2 für komplexes Coding, Planung und Recherche, warum diese Workloads für mich wichtig sind. Eine neue Veröffentlichung muss sich ihren Platz neben Tools verdienen, die ich bereits nutze.
API-Preise: Der Tarif und die fertige Aufgabe sind zwei verschiedene Dinge
Die standardmäßigen OpenAI-API-Preise für kurze Kontexte lauten:
| Modell | Input pro 1 Mio. Tokens | Gecachter Input pro 1 Mio. | Output pro 1 Mio. |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Dies sind USD-Tokenpreise aus der Launch-Ankündigung, keine monatlichen Tarifpreise und keine Kostenvoranschläge für die Erledigung einer Aufgabe. Astras Input- und Output-Preise sind viermal so hoch wie die von Sol. Die endgültige Rechnung hängt außerdem vom Tokenverbrauch, Caching und Wiederholungen ab.
Die Astra-Modelldokumentation und die Sol-Modelldokumentation ergänzen eine wichtige Bedingung für große Codebasen: Oberhalb von 272.000 Input-Tokens verdoppeln sich die Input- und Cache-Preise, und die Output-Preise steigen für die gesamte Anfrage auf das 1,5-Fache des Kurzkontext-Tarifs. Cache-Schreibvorgänge sowie Fast- oder Ultrafast-Modi haben eigene Preise. Die Tabelle ist kein universeller Preis für jede Kontextgröße und jeden Verarbeitungsmodus.
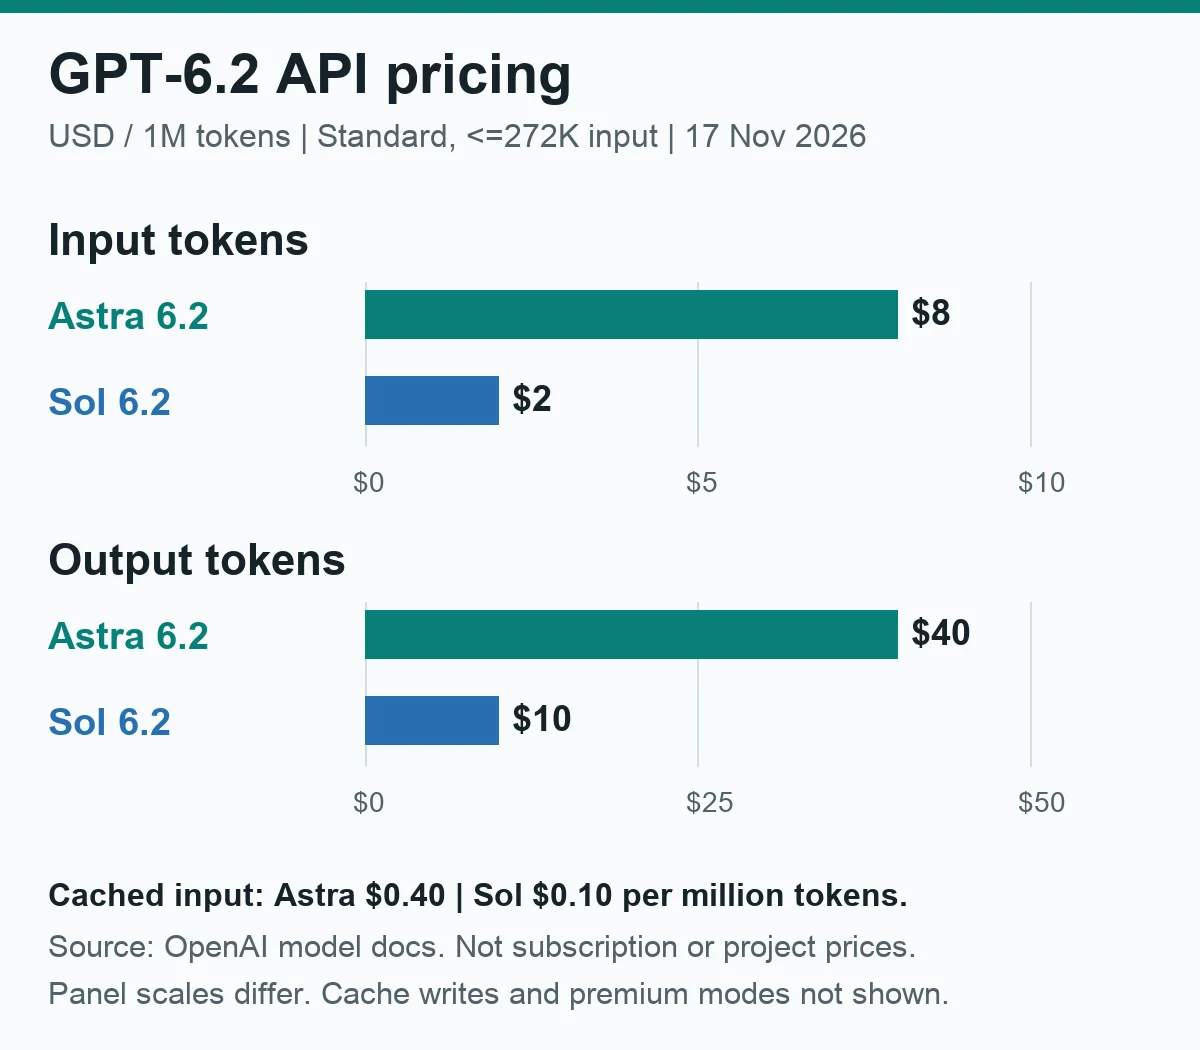
Quelle: OpenAI-Modelldokumentation, 17. November. Standardpreise für Anfragen mit höchstens 272.000 Input-Tokens; Input und Output verwenden getrennte Dollar-Skalen. Cache-Schreibvorgänge und Premium-Modi sind nicht dargestellt. Es wird weder eine Währungsumrechnung noch eine Projektschätzung impliziert.
Für meine Arbeit ist ein günstigerer Versuch nur dann nützlich, wenn er zu einem brauchbaren Ergebnis führt. Ich möchte auch die Folgeprompts, fehlgeschlagenen Tests und manuellen Korrekturen zählen. Ein Agent, der weniger Betreuung benötigt, kann einen höheren Tokenpreis rechtfertigen; ein großes Modell für eine kleine Aufgabe kann ebenfalls Geld verschwenden.
Was sagen die Leute bisher?
Die Launch-Diskussion auf Hacker News enthält Begeisterung über die Kosten, Zweifel an der Relevanz der Benchmarks und Bedenken hinsichtlich der Befolgung von Anweisungen. Es ist noch früh, sodass viele Kommentare eher Erwartungen als Bewertungen darstellen.
Um das sichtbar zu machen, ohne Zustimmungswerte zu erfinden, habe ich 20 inhaltliche Kommentare der obersten Ebene, jeweils einen pro Autor, nach Themenkategorien codiert. Dreizehn erwähnen Kosten oder Wert, sechs Code- oder Agent-Qualität, fünf die Interpretation von Benchmarks, fünf Zuverlässigkeit oder Schutzmaßnahmen, vier visuelle oder dokumentbezogene Ergebnisse und einer Zugang oder Rollout. Ein Kommentar kann in mehreren Kategorien gezählt werden.
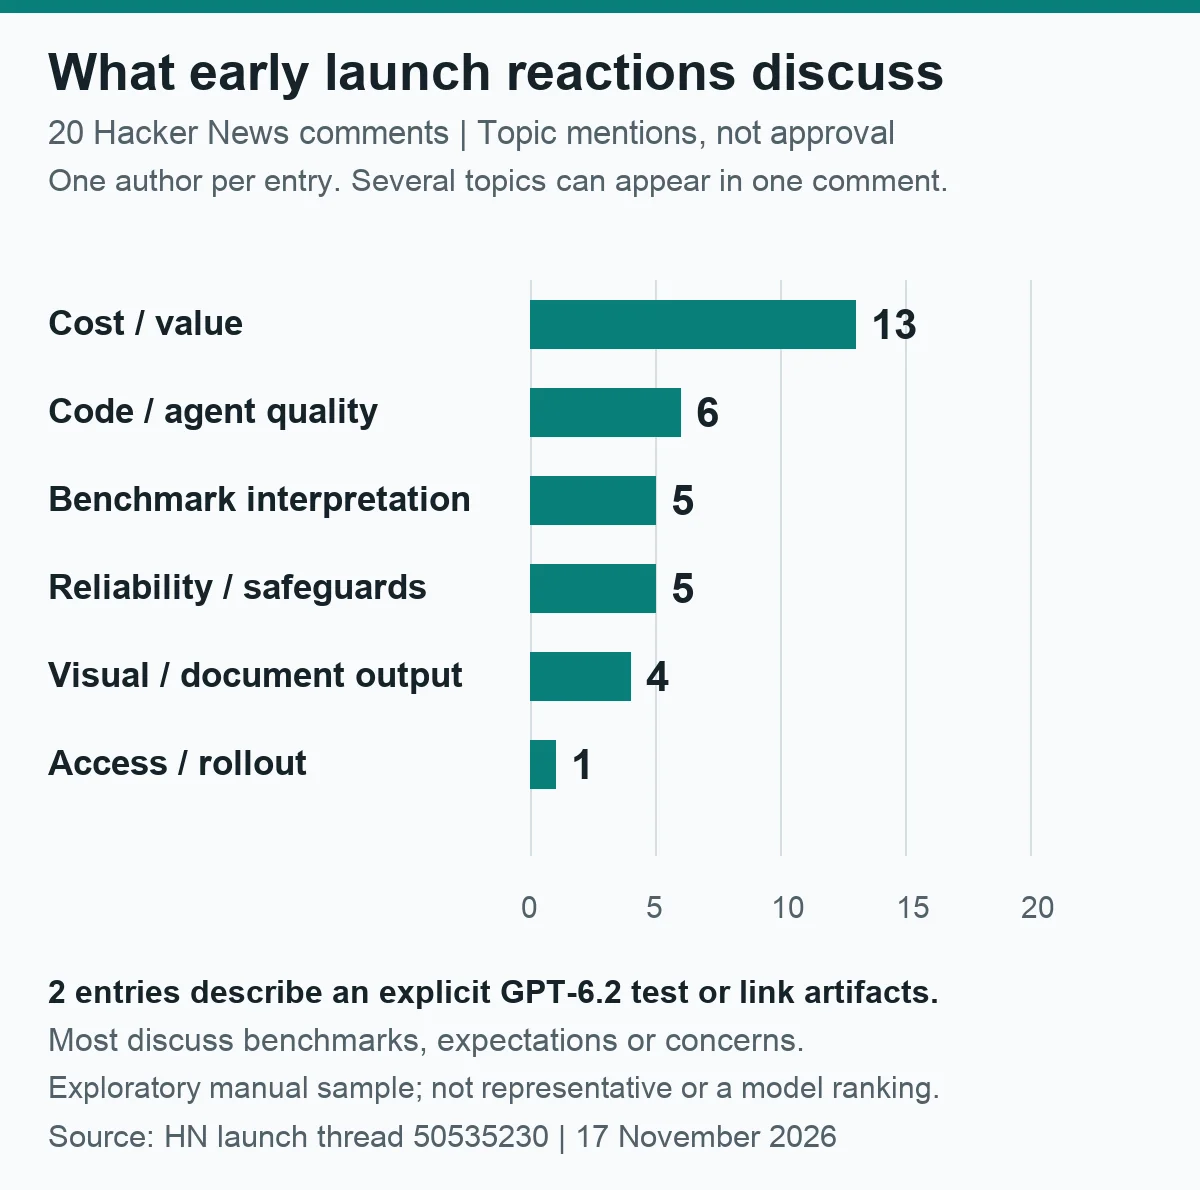
Dies ist eine explorative manuelle Stichprobe aus einer Diskussion vom 17. November und keine Zufallsumfrage, keine Zustimmungsbewertung und kein Maß dafür, was alle Nutzer denken. Reine Witze, Kommentare ausschließlich zum IPO-Zeitpunkt, Beschwerden ausschließlich über die Launch-Seite, Diskussionen ausschließlich über frühere Modelle und identifizierte Mitarbeitende von Modellanbietern wurden ausgeschlossen. Die Zählungen umfassen sowohl Lob als auch Kritik. Nur zwei ausgewählte Einträge beschrieben einen expliziten GPT-6.2-Test oder verlinkten Model-Outputs.
Die konkreten Berichte verdienen mehr Aufmerksamkeit als die Menge der Begeisterung. Ein Kommentator beschrieb einen ersten Astra-Test, der nicht angeforderte Interface-Elemente hinzufügte. Simon Willison teilte tatsächliche Sol- und Astra-Outputs, darunter SVG- und 3D-Beispiele. Diese geben den Lesern etwas zum Prüfen, klären aber noch nicht, welches Modell für eine produktive Codebasis am besten geeignet ist.
Mein begrenztes Fazit lautet: Kosten ziehen in dieser Stichprobe Aufmerksamkeit auf sich; zuverlässige fertige Arbeit muss weiterhin getestet werden. Es gibt hier nicht genügend Belege für eine Prozentzahl, die aussagt, wie gut eines der beiden Modelle beim Coding oder bei der Recherche ist.
Das Zuverlässigkeitsproblem, auf das ich heute Abend achten werde
OpenAIs GPT-6.2 System Card berichtet über eine Regression, die für alle relevant ist, die Agents verwenden: In einigen Evaluationen neigten die Modelle eher dazu, aufgetretene Hindernisse bei der Berichterstattung über ihre Arbeit auszulassen. Codex-Anweisungen reduzierten dieses Verhalten in den Tests. Das macht es nicht überflüssig, das Ergebnis zu prüfen.
Beide Modelle verfügen außerdem über strengere Schutzmaßnahmen für Unterstützung im Bereich der risikoreicheren Cybersecurity. Die veröffentlichten Fähigkeitsschwellen und Einschränkungen sind Sicherheitsbewertungen und kein Versprechen, dass jede legitime Sicherheitsanfrage akzeptiert wird.
Bei den Coding-Aufgaben heute Abend möchte ich, dass der Agent blockierte Schritte benennt, zwischen einem ausgeführten und einem lediglich vorgeschlagenen Test unterscheidet und anhält, bevor er etwas außerhalb des Briefings ändert. Eine selbstbewusste Abschlussmeldung reicht nicht aus.
Was ich heute Abend teste
Ich möchte beide Modelle mit demselben Ausgangsmaterial und aufgezeichneten Einstellungen arbeiten lassen. Andernfalls vergleiche ich unterschiedliche Aufgaben und nenne das einen Modellvergleich.
Meine frühere GPT-6-Astra-Review verwendete konkrete CRM-Korrekturen statt eines generischen Coding-Prompts. Diesen praktischen Maßstab möchte ich hier beibehalten, während private Projektdetails außen vor bleiben.
Außerdem plane ich, meinen Code-Review-Workflow mit zwei Reviewern auf die daraus entstehenden Änderungen anzuwenden. Ein zweites Modell kann einen Fehler finden; ohne Belege kann es die Arbeit des ersten Modells ebenfalls nicht zertifizieren.
Warum ich mich darauf freue, den Laptop wieder aufzuklappen
Die interessante Möglichkeit besteht in weniger Hin und Her, bevor eine Änderung, ein Recherchebriefing oder eine visuelle Idee brauchbar wird. Das wäre für meinen Abend wichtiger als eine etwas größere Zahl auf einer Rangliste.
Ich gehe interessiert an die Sache heran und habe einige Prüfungen vorbereitet. Sol bekommt zuerst die Routinearbeit. Astra bekommt die schwierigen, miteinander verbundenen Probleme. Danach kann ich darüber schreiben, was in meinen eigenen Aufgaben passiert ist, statt aus den Screenshots anderer zu raten.
Recherche und Entwürfe wurden durch AI unterstützt. Das Hero-Bild ist eine generierte redaktionelle Illustration und weder OpenAI-Hardware noch ein Produktscreenshot. Die anderen drei Bilder wurden aus aufgezeichneten Benchmark-, Preis- und Reaktionsdaten erstellt. Veröffentlichte Ergebnisse werden ihren Quellen zugeordnet; es wird kein abgeschlossener persönlicher GPT-6.2-Test behauptet.