Ich habe deutlich weniger Zeit mit Googles Modellen verbracht als mit den anderen AI-Tools in meinem Workflow. Gemini 4 Argon gibt mir einen Grund, das zu ändern. Die Ergebnisse bei der Geschäftsautomatisierung wirken nützlich, und der angekündigte Einführungspreis liegt neben GPT-6.1 Sol statt bei einem reinen Premium-Modell.
Ich möchte es testen, sobald der Zugang geöffnet wird. Vorerst ist dies ein Blick auf veröffentlichte Belege, Preise und erste Reaktionen – keine praktische Argon-Bewertung.
Quellenprüfung: 1. Oktober 2026. Das Titelbild ist ein AI-generiertes redaktionelles Artwork. Die folgenden Diagramme stellen zitierte numerische Ergebnisse neu dar; sie sind keine Screenshots meiner eigenen Tests.
Was ist Gemini 4 Argon, und kann ich es bereits nutzen?
Google kündigte Argon am 30. September 2026 zunächst für vertrauenswürdige Cyberabwehr-Experten über Fairwind an. Der breitere Zugang soll mit kostenpflichtigen API-Kunden und Google AI Ultra-Abonnenten beginnen; die Ankündigung nennt kein verbindliches öffentliches Veröffentlichungsdatum. Siehe Googles Ankündigung von Gemini 4 Argon.
Ich würde mit dem Kauf eines Abonnements speziell für Argon warten, bis tatsächlich Kontozugang besteht. Ein angekündigter Rollout ist etwas anderes als ein Modell, das ich heute auswählen kann, und Google hat in dieser Ankündigung kein Datum für die Verfügbarkeit in Schweden versprochen.
Der wichtigste Grund für meine Aufmerksamkeit ist die Möglichkeit, längere Aufgaben mit weniger Eingriffen abzuschließen. Mein sinnvoller Test wird bestehenden Code, schwierige Geschäftsregeln und Belege dafür umfassen, dass das Endergebnis funktioniert. Eine überzeugende Antwort allein wird die Frage nicht klären.
Gemini 4 Argon-Preise: Der Einführungspreis hat einen Haken
Google kündigt $2 für Eingaben und $10 für Ausgaben pro einer Million Tokens an. Die Fußnote zur Preisgestaltung legt den späteren Preis auf $4/$20 fest, nennt aber kein Enddatum für den Einführungszeitraum. Für gecachte Eingaben gibt es einen Rabatt von 95 %, was rechnerisch einem Einführungspreis von $0.10 entspricht.
| Modell oder Preiszeitraum | Eingabe / 1M Tokens | Ausgabe / 1M Tokens |
|---|---|---|
| Gemini 4 Argon, Einführung | $2 | $10 |
| Gemini 4 Argon, nach der Einführung | $4 | $20 |
| GPT-6.1 Sol, Standard | $2 | $10 |
| Claude Opus 5.5, Standard | $4 | $20 |
| GPT-6 Astra, Standard | $10 | $50 |
Quellen: Googles Ankündigung und erweiterte Preisfußnote, GPT-6.1 Sol model pricing, GPT-6 Astra model pricing und Claude Platform pricing.
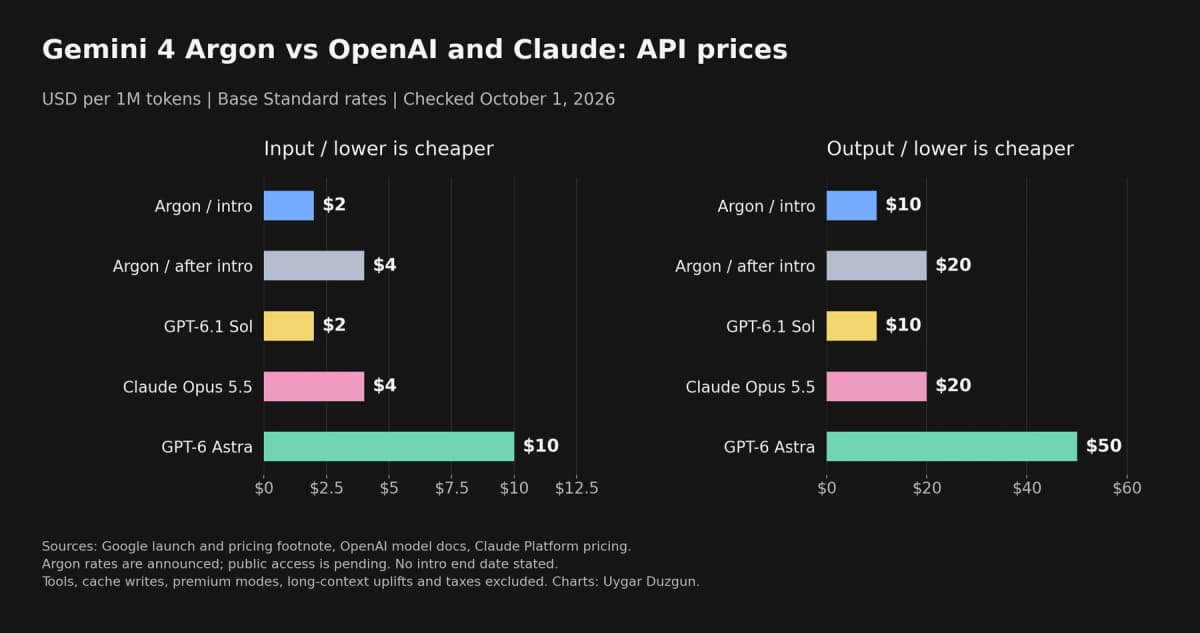
Grundpreise in USD, geprüft am 1. Oktober. Argons Preise sind angekündigte Preise und kein Beleg für einen allgemeinen API-Zugang. Der Vergleich schließt Tools, Cache-Schreibvorgänge, Premium-Modi, regionale Gebühren und Steuern aus.
Für ein einfaches Budgetbeispiel würden eine Million nicht gecachter Eingabe-Tokens plus 100.000 Ausgabe-Tokens über mehrere Anfragen mit kurzem Kontext zu Argons Einführungspreisen $3 kosten, danach $6, mit Sol $3, mit Opus $6 und mit Astra $15. Das ist eine Berechnung mit einer festen Token-Mischung und kein gemessener Workload. Dieselbe Aufgabe kann bei verschiedenen Modellen unterschiedlich viele Tokens verbrauchen.
OpenAI erhöht außerdem die Preise für vollständige Anfragen, wenn eine Eingabe in einem Prompt mehr als 272.000 Tokens umfasst; Anthropic führt Standardpreise über das Kontextfenster von Opus 5.5 hinweg auf. Eine Tabelle mit Grundpreisen kann dir daher nicht sagen, wie hoch die Rechnung für eine riesige Repository-Sitzung ausfällt. Mein GPT-6.1 Sol vs Opus 5.5 comparison behandelt diese Abwägungen.
Ich würde eine Integration mit Argons späterem Preis kalkulieren und die Aktion als vorübergehende Ersparnis betrachten. So vermeide ich, einen Business Case auf einem Rabatt aufzubauen, dessen Ablauf ich noch nicht terminieren kann.
Gemini 4 Argon-Benchmarks: starke Automatisierung, gemischte Coding-Ergebnisse
Geschäftsautomatisierung ist das Ergebnis, das mir am wichtigsten ist
Zapier's AutomationBench 1.0.6 testet End-to-End-Arbeit über 47 Tools in sechs Geschäftsbereichen. Die resultierende Umgebung wird mit deterministischen Assertions geprüft, statt die überzeugende Abschlussnachricht eines Agents zu bewerten.
Die unten ausgewählten Konfigurationen behalten ihre Aufwandsstufen und ihr Fallback-Verhalten bei.
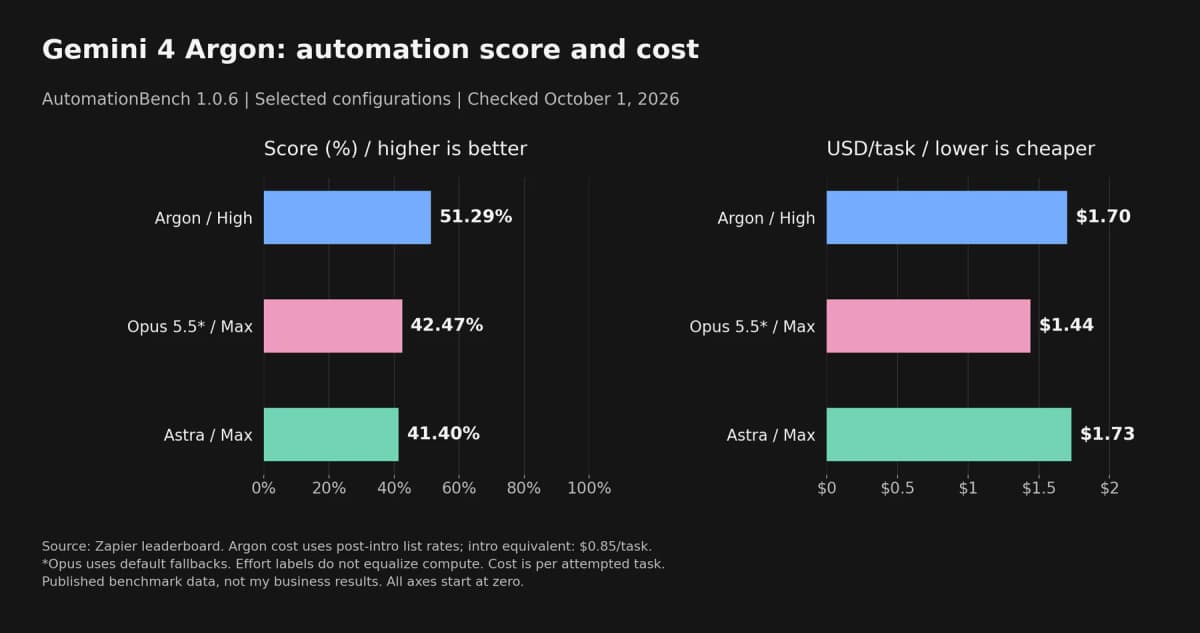
Zapier berichtet für Argon High einen Wert von 51,29 % und $1.70 pro versuchter Aufgabe unter Verwendung der späteren Listenpreise; das entsprechende Einführungsangebot kostet $0.85. Opus 5.5 Max mit standardmäßigen Fallbacks erreicht 42,47 % bei $1.44, und Astra Max erreicht 41,40 % bei $1.73. Die Aufwandsbezeichnungen entsprechen zwischen den Anbietern nicht denselben Compute-Budgets.
Argon erzielt in diesem Vergleich den höheren Wert, aber seine regulären Aufgabenkosten sind nicht die niedrigsten. Ebenso rechtfertigt ein Benchmark-Wert von ungefähr 51 % keinen unbeaufsichtigten Zugriff in der Produktion. Ich möchte weiterhin Freigaben für folgenreiche Aktionen, überprüfbare Logs und eine Möglichkeit, unvollständige Ausführungen wiederherzustellen.
Diese Unterscheidung ist für die Geschäftsautomatisierung wichtig. Mir ist wichtig, dass der richtige Datensatz aktualisiert wird und die richtige empfangende Person eine Nachricht erhält. Ein Agent, der mir sagt, er sei fertig, kann diese Prüfungen nicht ersetzen.
Coding-Ergebnisse hängen von der Aufgabe ab
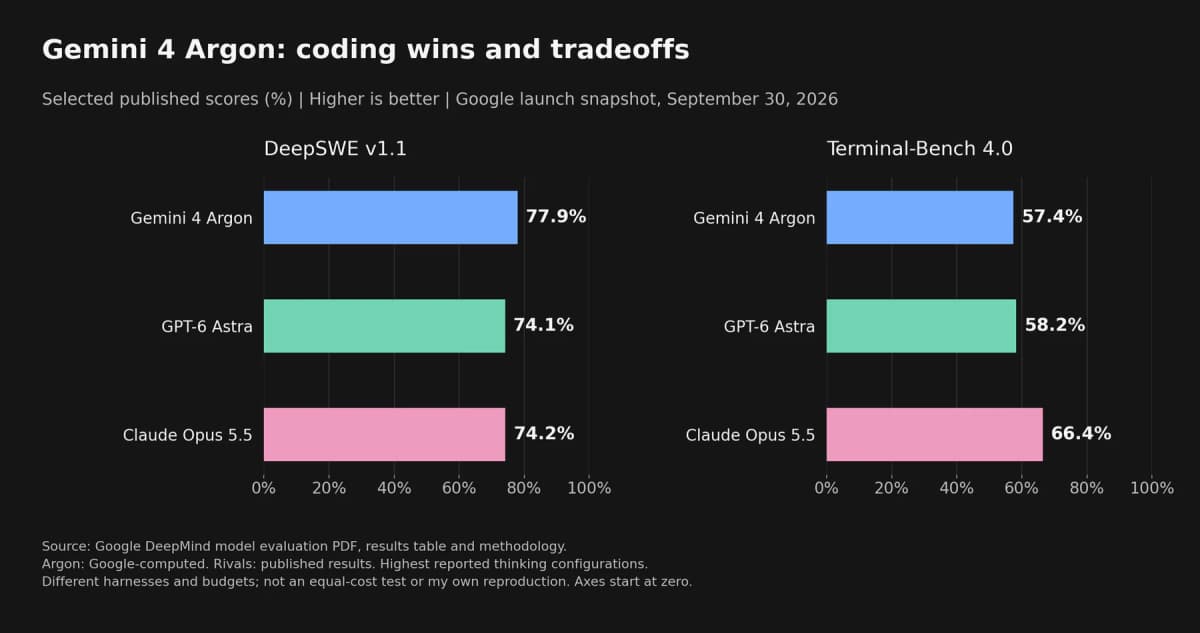
Ausgewählte Werte aus Google DeepMinds model evaluation report. Dies kombiniert von Google berechnete Argon-Ergebnisse mit veröffentlichten Ergebnissen anderer Modelle und ist kein einheitlicher unabhängiger Head-to-Head-Lauf.
Argon erreicht 77,9 % auf DeepSWE v1.1, gegenüber 74,1 % für Astra und 74,2 % für Opus. Auf Terminal-Bench 4.0 führt Opus dieses Trio mit 66,4 % an, gefolgt von Astra mit 58,2 % und Argon mit 57,4 %. Der Bericht setzt Astra außerdem auf FrontierSWE v2 vor Argon: 65,5 % gegenüber 55,0 %.
Google berichtet im Allgemeinen mit seinen höchsten Thinking-Einstellungen sowie den maximalen oder besten verfügbaren Ergebnissen der Konkurrenz. Harnesses und Budgets sind relevant. Ein Vorsprung bei einem Repository-Benchmark garantiert keine bessere Lösung in meiner Codebasis, insbesondere wenn der Unterschied nur wenige Prozentpunkte beträgt.
Ich würde eine begrenzte Regression-Reparatur und eine Änderung über mehrere Dateien getrennt testen. Beide benötigen Verhaltensprüfungen und eine Überprüfung des Diffs. Ein Modell könnte den Test bestehen und gleichzeitig eine Abstraktion hinzufügen, die ich nicht warten möchte.
Unabhängige Belege für Wissensarbeit liefern zusätzlichen Kontext
Vals Index 2.1, aktualisiert am 30. September, führt Argon mit 68,90 %, Opus 5.5 mit 66,97 %, Astra mit 63,13 % und Sol 6.1 mit 61,15 %. Vals kombiniert Aufgaben aus den Bereichen Finanzen, Coding, Recht und Steuern mit nach Sektoren gewichteten Anteilen auf Grundlage des US-BIP.
Die Kostenspalte macht die Rangfolge komplizierter: $15.68 pro Test für Argon bei Tokenpreisen von $4/$20 gegenüber $3.24 für Sol. Das sind benchmark-spezifische Kosten und keine Angebote für meine Arbeit. Sie zeigen, warum ich ein günstigeres Modell in der Bewertung behalten würde, selbst wenn ein anderes Modell die Punktespalte anführt.
Ich würde Aufgaben nach ihrer Messung weiterleiten. Einfache wiederkehrende Arbeit und teure Fehler sollten nicht automatisch dasselbe Modell verwenden.
Was sagen andere über Argon?
Die frühe Gemini 4 Argon release discussion enthält Begeisterung, Frustration über den eingeschränkten Zugang und Hinweise auf den späteren Preis. Dies sind Reaktionen einzelner Nutzer zum Start, keine repräsentative Umfrage und kein Beleg dafür, dass sie Argon alle ausprobiert haben. Kommentare, die wochen- oder monatelange Wartezeiten vorhersagen, sind Spekulation.
Die für mich nützlichere Debatte findet sich in der Rust community discussion of Google's codebase migrations. Ein Kommentator namens nicoburns argumentiert, dass die Übersetzung zwischen Sprachen besser funktionieren kann, weil das ursprüngliche Design bereits existiert. Andere beschreiben Wartbarkeitsprobleme und den Aufwand, den sie für die Korrektur generierten Codes betreiben.
Diese Diskussion betrifft die Entwicklung mit Agent-Unterstützung im Allgemeinen. Sie belegt nicht Argons Zuverlässigkeit in der Praxis. Ich nehme die praktische Lehre ernst: Vergleiche das Verhalten mit dem Original, halte Änderungen überprüfbar und messe, wie viel menschliche Arbeit danach noch übrig bleibt.
Wie ich Gemini 4 Argon testen möchte
Ich bin neugierig genug, Google eine faire Chance zu geben. Ich werde mit Aufgaben beginnen, die ich überprüfen kann, statt das Modell sofort alles übernehmen zu lassen.
Ich möchte verstrichene Zeit, Tokenkosten, Wiederholungen, Korrektheit und Prüfaufwand erfassen. Die Frage ist, ob Argon meinen Gesamtaufwand reduziert – einschließlich der Kontrolle und Reparatur des Ergebnisses.
Googles Ankündigung erhöht außerdem das Ausgabelimit auf eine Million Tokens. Das ist eine Obergrenze und kein Ziel. Ich würde weiterhin Budgets und Abbruchbedingungen festlegen; zusätzlich verfügbares Reasoning sollte seine Kosten rechtfertigen. Mein Artikel über AI reasoning tokens and compute costs erklärt, warum mir diese Abwägung wichtig ist.
Gemini 4 Argon wirkt testenswert. Ich habe Google bisher nicht ausreichend genutzt, um dem Modell einen fairen Platz in meinem Workflow zu geben. Diese Ergebnisse machen mich neugierig darauf, das zu ändern, sobald ich auf das Modell zugreifen kann – während Sol, Opus und Astra echte Alternativen bleiben, bis mir meine eigenen Tests mehr sagen.