Ich verwende Claude Haiku 5.5 für Übersetzungen, schnelle Textänderungen, Korrekturen und einfache Deployment-Aufgaben. Für diese Arbeiten braucht man ein Modell, das eine eng gefasste Aufgabe befolgt und sie abschließt, ohne aus einer kleinen Änderung ein Projekt zu machen.
Die Einstellung für den Aufwand ist wichtig, weil diese Aufgaben unterschiedlich schwierig sind. Einen Tippfehler zu korrigieren und eine Seite mit technischer Terminologie zu übersetzen, erfordern unterschiedliche Ausgangspunkte.
Dies ist Teil 1 von AI Models in Practice, einer Serie über die Auswahl von Modellen für die tatsächliche Arbeit. Die folgenden Beispiele sind wiederverwendbare Prompts und vorgeschlagene Einstellungen. Ich habe keinen kontrollierten Vergleich aller Aufwandsstufen durchgeführt, und die Beispielübersetzungen sind redaktionelle Beispiele, keine aufgezeichneten Haiku-Ausgaben. Modelldetails und Preise wurden am 12. Oktober 2026 anhand der Dokumentation von Anthropic überprüft.
Inhaltsverzeichnis
Was ist Claude Haiku 5.5?
Claude Haiku 5.5 ist die Small-Model-Option von Anthropic für umfangreiche, zeitkritische Aufgaben. Anthropic hat es am 7. Oktober 2026 veröffentlicht und positioniert es für Zusammenfassungen, Klassifizierung, Extraktion, Routing und klar abgegrenzte Subagent-Aufgaben. Die Claude API model ID lautet claude-haiku-5-5. Siehe die Ankündigung zur Einführung von Claude Haiku 5.5.
Die Übersicht zum Modell Haiku 5.5 nennt Text- und Bildeingaben, Textausgaben, ein Kontextfenster von einer Million Tokens und bis zu 128.000 Ausgabetokens in der Messages API. Standardmäßig verwendet es adaptives Denken. Ein großes Kontextfenster beschreibt die Kapazität; es bedeutet nicht, dass das Senden deines gesamten Repositorys sinnvoll oder wirtschaftlich ist.
Ich würde Haiku zunächst einen bereitgestellten Absatz, ein Glossar und eine präzise Bearbeitungsaufgabe geben, bevor ich es auffordere, ein gesamtes Unternehmen zu interpretieren. Eine engere Aufgabenbeschreibung macht das Ergebnis leichter überprüfbar.
Wofür eignet sich Haiku 5.5?
Meine praktische Auswahlliste beginnt mit den Aufgaben, für die ich es bereits einsetze:
Weitere Aufgaben, die sich zu evaluieren lohnen, sind das Extrahieren von Feldern aus einem bereitgestellten Dokument, das Sortieren von Nachrichten in bekannte Kategorien und das Zusammenfassen eines kurzen Supportgesprächs. Dies sind vorgeschlagene Einsatzmöglichkeiten, keine Ergebnisse meines eigenen Benchmarks.
Für umfassende Engineering-Arbeiten sollte die Modellwahl erneut geprüft werden. Das Einführungsmaterial von Anthropic empfiehlt Sonnet 5.5 und Opus 5.5 für komplexere agentische Programmieraufgaben. Eine Erhöhung des Aufwands von Haiku garantiert nicht dieselben Fähigkeiten wie ein größeres Modell.
Was bedeuten die fünf Aufwandsstufen?
Haiku 5.5 unterstützt low, medium, high, xhigh und max. Der Standardwert ist medium. Der Aufwand steuert, wie viel Arbeit das Modell in eine Antwort investiert; er ist weder ein festes Token-Budget noch eine Genauigkeitsgarantie. Er beeinflusst das Denken, den Antworttext und Tool-Aufrufe. Siehe die Dokumentation zum Aufwand von Anthropic.
| Aufwand | Offizielle Ausgangsempfehlung | Mein vorgeschlagener Einsatz |
|---|---|---|
low | Kurze, einfache und latenzsensitive Aufgaben | Eine Tippfehlerkorrektur oder eine kurze, eindeutige Übersetzung |
medium | Standard für die meisten Aufgaben, einschließlich klar abgegrenzter Programmieraufgaben | Eine normale Übersetzung oder eine kleine Textänderung mit Vorgaben |
high | Wissensarbeit, längere Agent-Aufgaben, strikte Befolgung von Anweisungen | Mehrdeutige Terminologie oder eine Änderung, die mehrere Regeln erfüllen muss |
xhigh | Verwenden, wenn Evaluierungen einen Qualitätsgewinn zeigen | Ein Experiment mit einer schwierigen, begrenzten Aufgabe; mit Sonnet vergleichen |
max | Verwenden, wenn Evaluierungen die zusätzlichen Kosten rechtfertigen | Ein außergewöhnlicher Testfall nach der Prüfung niedrigerer Stufen |
Meine Ausgangsregel wäre medium, dann anhand der beobachteten Fehler anpassen. Für eine triviale Korrektur würde ich low ausprobieren. Für eine glossarsensible Übersetzung würde ich medium mit high vergleichen. Halte Prompt und Eingaben gleich, damit du erkennen kannst, ob die Einstellung geholfen hat.
Ein Deployment kann nur einen einzigen Befehl umfassen und dennoch erhebliche Konsequenzen haben. Die Anforderungen an Verifizierung und Genehmigung würde ich unabhängig vom Aufwand festlegen.
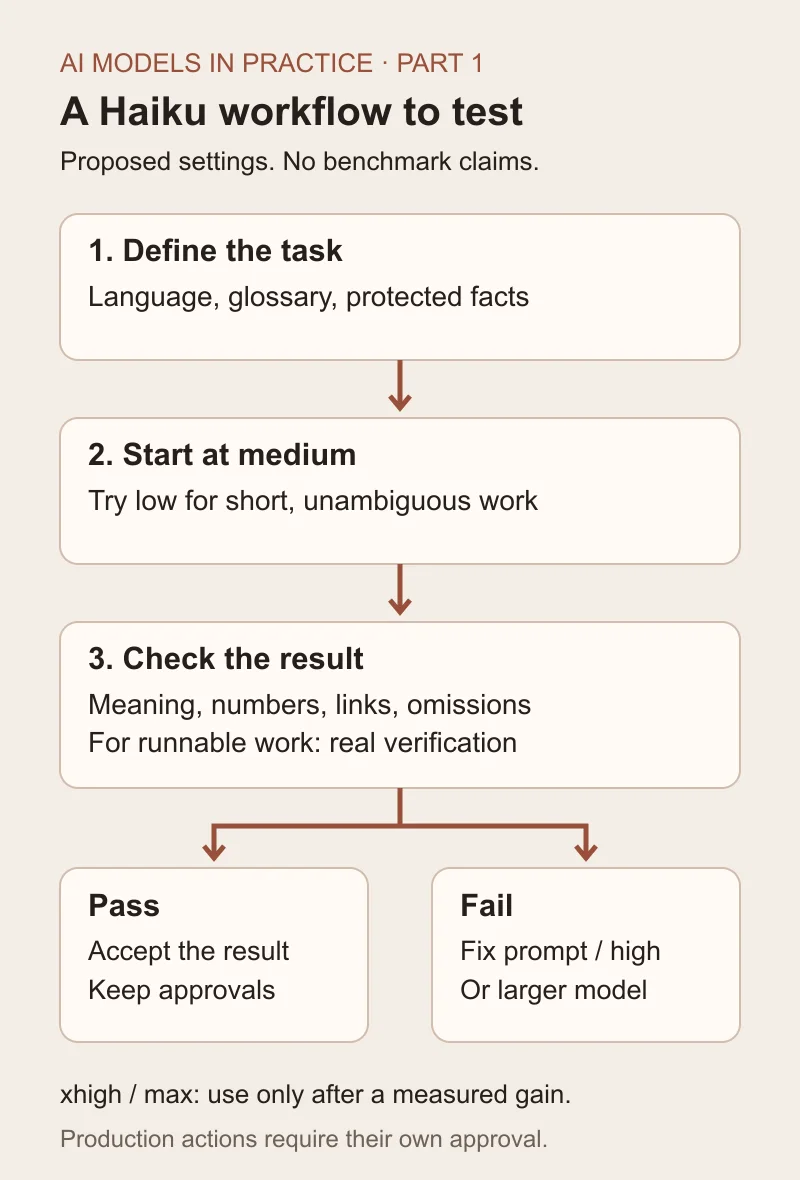
Vorgeschlagener Workflow, kein Benchmark-Nachweis. Akzeptanz bedeutet, dass das Ergebnis die Prüfungen für diese Aufgabe bestanden hat; Veröffentlichungs- und Produktionsaktionen behalten ihre eigenen Genehmigungsschritte.
Wie ich den Aufwand für Übersetzungen festlegen würde
Übersetzungen sind das deutlichste Beispiel dafür, warum ein einziger Standardwert nicht alles abdecken kann. Diese Einstellungen sind Ausgangshypothesen für eine Evaluation, keine gemessenen Gewinner.
Low für kurze, wörtliche Texte
Eine kurze Statusmeldung lässt wenig Raum für Mehrdeutigkeit:
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
Eine akzeptable redaktionelle Referenz lautet: „Your order 1842 was dispatched on 12 October 2026.“ Wichtig sind die Bestellnummer, das Datum und die Bedeutung. Mehrere englische Formulierungen können akzeptabel sein.
Hier würde ich low ausprobieren und erst dann erhöhen, wenn ein Detail verloren geht. Zusätzliche Überlegungen in diesem Prompt sollten sich durch ein besseres Ergebnis rechtfertigen.
Medium für normale Website-Texte
Bei einem Absatz würde ich mit medium beginnen und Zielgruppe, Region, Ton und geschützte Begriffe angeben:
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
Eine redaktionelle Referenz könnte lauten: „We normally update the page within two working days. It may take longer if we need additional information.“ Eine Version, die ein Update innerhalb von zwei Tagen verspricht, hat die Aussage verändert.
Der Leitfaden zur mehrsprachigen Unterstützung von Anthropic empfiehlt, Quell- und Zielsprache anzugeben und den regionalen Kontext zu berücksichtigen. Die veröffentlichte Sprachentabelle deckt ältere Modelle ab, darunter Haiku 4.5; sie ist kein Beleg für die Übersetzungsgenauigkeit von Haiku 5.5.
High, wenn Terminologie oder Mehrdeutigkeit Aufmerksamkeit erfordern
Einige Begriffe hängen vom Geschäftskontext ab. Das schwedische Wort „reklamation“ sollte nicht automatisch mit „advertising“ übersetzt werden. Je nach Satz könnte eine passende englische Wiedergabe eine Beschwerde oder eine Reklamation wegen eines fehlerhaften Produkts sein.
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
Für diese Art von Aufgabe würde ich medium und high vergleichen. Das Erfolgskriterium ist, ob die Übersetzung die Bedingung bewahrt und die beabsichtigte Terminologie verwendet. Flüssige Formulierungen allein reichen nicht aus.
Bei strukturierten Inhalten würde ich übersetzbare Zeichenfolgen mit stabilen IDs senden. Meine Anwendung würde prüfen, dass jede ID genau einmal zurückgegeben wird und geschützte Werte erhalten bleiben. Ein Modell aufzufordern, eine große JSON-Datei zu bewahren, ersetzt weder Parsing noch Validierung.
Schnelle Textänderungen und Korrekturen
Ein Korrektur-Prompt sollte die zulässige Änderung definieren. Andernfalls kann eine Aufforderung zur Grammatikprüfung in eine Neufassung ausarten.
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
Die redaktionelle Referenz lautet: „We have updated the page, but the payment tests are not finished yet.“ Eine Version, die sagt, die Seite sei vollständig getestet, verfehlt die Vorgabe.
Für einen solchen Satz ist low eine sinnvolle Einstellung zur Evaluation. Für mehrere Absätze, geschützte Links oder mehrere Einschränkungen ist medium mein vorgeschlagener Ausgangspunkt.
Bei einer Textänderung solltest du nach dem konkreten Ergebnis fragen: „Kürze dies auf 80 Wörter, bewahre die beiden Einschränkungen und erhalte den Link.“ Wortanzahl und Link-Erhalt kannst du unabhängig vom Modell prüfen.
Einfache Deployment-Aufgaben: Definiere, was als erledigt gilt
Ich zähle einfache Deployment-Arbeiten zu meinen Haiku-Einsatzmöglichkeiten, aber „einfach“ braucht einen klar definierten Umfang. Ein bekanntes Deployment-Verfahren für eine genehmigte Textänderung ist eine andere Aufgabe als die Diagnose eines fehlerhaften Releases oder die Entscheidung, wie eine Datenbank migriert werden soll.
Eine wiederverwendbare Anweisung könnte lauten:
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
Für Vorbereitung und Prüfungen würde ich mit medium beginnen. Wenn die Arbeit die Untersuchung von Fehlern über mehrere Systeme hinweg erfordert, würde ich Modell und Aufwand neu bewerten, statt sie als einfache Aufgabe zu bezeichnen.
Der Haiku-spezifische Prompting-Leitfaden von Anthropic weist darauf hin, dass Agenten mit niedrigem Aufwand bei langen Prompts vorzeitig stoppen oder Prüfungen auslassen können. Er empfiehlt ausdrückliche Anweisungen zur Verifizierung. Der Leitfaden erwähnt außerdem gelegentliche leere sichtbare Antworten in Multi-Turn-Konversationen bei xhigh sowie Probleme mit Tool-Aufrufen, wenn Denken zusammen mit strukturierten Ausgaben deaktiviert ist. Eine Integration sollte unvollständige Ergebnisse erkennen, statt sie stillschweigend zu akzeptieren.
Wie ändere ich den Aufwand in Claude oder der API?
Öffne in der Claude-App das Modellmenü neben der Senden-Schaltfläche, wähle Haiku 5.5 und anschließend Effort. Die verfügbaren Optionen können von den Konto- oder Administratoreinstellungen abhängen. Anthropic zufolge kann das Denken für Haiku 5.5 in der Claude-App nicht deaktiviert werden. Siehe Modell-, Aufwands- und Denkeinstellungen ändern.
Die API bietet eine direktere Steuerung. Ein minimaler Request-Body sieht so aus:
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
Dies ist eine beispielhafte Request-Struktur, keine von mir ausgeführte Anfrage. Füge den Absatz in die User-Nachricht ein. max_tokens ist eine Obergrenze, keine Reservierung und keine Anweisung, eine lange Antwort zu erzeugen.
Der Migrationsleitfaden für Haiku 5.5 von Anthropic erklärt, dass Denken dieses Ausgabebudget verbraucht. Ein kleines Limit kann daher die Antwort abschneiden, bevor sichtbarer Text erscheint. Wähle Antwortblöcke anhand ihres type aus, statt anzunehmen, dass der erste Block die Antwort enthält.
Bei neuen API-Anfragen solltest du temperature, top_p und top_k weglassen. Ersetze die ältere Konfiguration mit aktiviertem Denken und budget_tokens durch adaptives Denken. Die API erlaubt deaktiviertes Denken bei low, medium und high; xhigh und max erfordern adaptives Denken. Der Leitfaden nennt außerdem Unterschiede zwischen Providern. Prüfe daher deine tatsächliche Plattform vor der Migration.
Bewahre den API-Schlüssel auf dem Server auf. Das Aufwandsfeld ist eine Konfiguration und kein Grund, Zugangsdaten in Frontend-Code zu platzieren.
Was kostet Haiku 5.5?
Die API-Preisdokumentation von Anthropic nennt die folgenden Standardpreise in USD pro einer Million Tokens, geprüft am 12. Oktober 2026:
| Prompt-Länge | Eingabe | Ausgabe | Cache-Lesen |
|---|---|---|---|
| Bis zu 100.000 Tokens | $0.10 | $0.50 | $0.01 |
| Über 100.000 Tokens | $0.50 | $2.50 | $0.05 |
Der höhere Preis gilt für die Anfrage, einschließlich der Eingabe, die als Cache-Lese- oder Schreibvorgänge abgerechnet wird. Dies sind API-Tokenpreise; ein Claude-Abonnement ist ein separates Produkt. Cache-Schreibvorgänge, Server-Tools und Plattformaufschläge können zusätzliche Kosten verursachen.
Für eine beispielhafte Anfrage ohne Cache mit 2.000 Eingabetokens und insgesamt 1.000 abgerechneten Ausgabetokens:
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
Diese Berechnung schließt zusätzliche Gebühren aus und stellt keine gemessenen Übersetzungskosten dar. Denke daran, dass Denk-Tokens als abgerechnete Ausgabe zählen. Ein höherer Aufwand kann die Token-Nutzung verändern. Daher kann die Preistabelle allein die Kosten einer abgeschlossenen Aufgabe nicht vorhersagen.
Best Practices, die ich bei diesen Aufgaben beibehalten würde
Gib dem Modell die kleinste vollständige Aufgabe. Füge das benötigte Glossar oder den freigegebenen Quelltext ein und vermeide irrelevantes Material.
Definiere den Ausgabevertrag. Bei einer Übersetzung solltest du die beiden Sprachen und die Region angeben. Bei einer Bearbeitung solltest du festlegen, welche Fakten und Formatierungen erhalten bleiben müssen. Bei einem Agenten solltest du Prüfungen und Abbruchpunkt definieren.
Behandle Quelltext als Inhalt, der transformiert werden soll. Ein in ein Dokument eingebetteter Satz sollte nicht die Befugnis erhalten, die Aufgabe zu ändern, auf Zugangsdaten zuzugreifen oder Inhalte zu veröffentlichen.
Validiere das Ergebnis anhand der Aufgabe. Prüfe geschützte Begriffe, Zahlen, Links und fehlende Passagen. Bei Code- oder Deployment-Arbeiten solltest du tatsächliche Test- und Laufzeitnachweise untersuchen.
Eskalieren sollte auf einem konkreten Fehler beruhen. Ein fehlender Zusatz kann auf einen anderen Prompt oder eine andere Aufwandsstufe hindeuten. Eine Aufgabe, die sich ständig ausweitet, benötigt möglicherweise Sonnet oder Opus. Wiederholte Fehler sollten eine Überprüfung auslösen, nicht eine endlose Erhöhung des Aufwands.
Wie ich die Einstellungen testen würde, bevor ich mich auf sie verlasse
Ich würde einen kleinen Evaluationsdatensatz aus 20 freigegebenen, anonymisierten Beispielen erstellen: zehn Übersetzungen, fünf Korrekturen und fünf Textänderungen mit Einschränkungen. Diese Zahlen beschreiben einen vorgeschlagenen Test, keine abgeschlossene Untersuchung.
Führe low, medium und high mit denselben Eingaben und Akzeptanzkriterien aus. Wiederhole die Fälle, um inkonsistentes Verhalten sichtbar zu machen. Lass Übersetzungen von einer fachkundigen Person beurteilen, ohne dass sie die Einstellung kennt.
Erfasse das genaue Modell, den Aufwand, die Prompt-Version, die verstrichene Zeit, die abgerechneten Tokens und die Fehler. Zähle verlorene Einschränkungen, veränderte Zahlen, beschädigte Links, ausgelassenen Text und unnötige Neufassungen. Vergleiche die Kosten pro akzeptiertem Ergebnis einschließlich des Aufwands für Nachbesserungen.
Bei Deployment-Unterstützung solltest du separate Vorbereitungstasks in einer Nicht-Produktionsumgebung mit einem bekannten erwarteten Ergebnis evaluieren. Produktionsaktionen unterliegen weiterhin dem Genehmigungsverfahren des Projekts.
Mein bestehender Leitfaden zum Benchmarking von AI-Modellen für die tatsächliche Arbeit→ behandelt den umfassenderen Evaluationsansatz. Der Vergleich von GPT-6.1 Sol und Opus 5.5→ bietet Kontext für die Auswahl größerer Modelle; er ist kein Haiku-Übersetzungstest.
Die Serie beginnt mit den kleinen Aufgaben
Haiku ist der erste Teil, weil Übersetzungen, Korrekturen und kurze Änderungen die Abwägungen sichtbar machen. Du kannst prüfen, ob ein Satz seine Bedeutung behalten hat und ob ein Link erhalten geblieben ist.
Die nächsten vorgeschlagenen Teile behandeln Sonnet für tägliche Programmier- und Analyseaufgaben, Opus für schwierigere Arbeiten und abschließend einen Leitfaden zum Routing von Aufgaben zwischen Modellen. Jeder Teil verwendet dieselbe Unterscheidung: dokumentierte Fähigkeiten, meine tatsächliche Nutzung und noch durchzuführende Tests.