我刚下班回到家,而 OpenAI 又给了我一个再次打开笔记本电脑的好理由。GPT-6.2 Astra 和 Sol 已经发布。今晚我想用它们处理我真正关心的工作:跨代码库的修改、困难的研究任务,以及不能只停留在截图层面的视觉输出。
我很期待开始测试。但这些测试还没有完成。这是一篇发布分析和测试计划,其中会将已发布的测量结果与早期反应,同我未来亲自测试的结果分开讨论。
OpenAI 认为 GPT-6.2 Astra 和 Sol 擅长什么?
在 Introducing GPT-6.2 Astra and Sol 中,OpenAI 将 Astra 定位为处理最困难的专业项目,将 Sol 定位为高效的日常工作。它们的承诺是用更少的输出 token 交付更好的成品:更整洁的代码、更强的视觉工作,以及更贴合需求文档的文档。
OpenAI 还强调了科学任务和长时间运行的 agent 工作流。其 FrontierCode 对比显示,在最高工作强度下,Sol 的得分距离 Astra 仅 0.5 分,但任务成本约为五分之一。这是该项评估中的结果,并不代表我的代码库一定会得到同样的结果。
这些模型可通过 ChatGPT Work、Codex 和 API 使用。发布信息列出了 Plus、Pro、Enterprise 和 Edu 的访问权限,以及 workspace 和 Ultrafast 条件。请查看你实际使用的方案,不要想当然地认为 API 价格代表你的订阅额度。
我的初步选择是:可重复的工作交给 Sol,困难的对比任务交给 Astra。这就是我计划如何分配今晚测试的方式。这并不意味着我认为其中一个模型永远是更好的选择。
基准测试没有一个放之四海而皆准的赢家
独立数据表比单一的胜负标题更有参考价值。Artificial Analysis 列出了 Astra、Sol 和 Fable 5.2 在其所列最高配置下的四舍五入 Intelligence Index 得分,分别为 62、57 和 65。
Fable 的条目标注为 Max, Default Fallback。应当把这一配置视为结果的一部分,而不是可以忽略的脚注。这些指数分数并不是任务解决率的百分比。
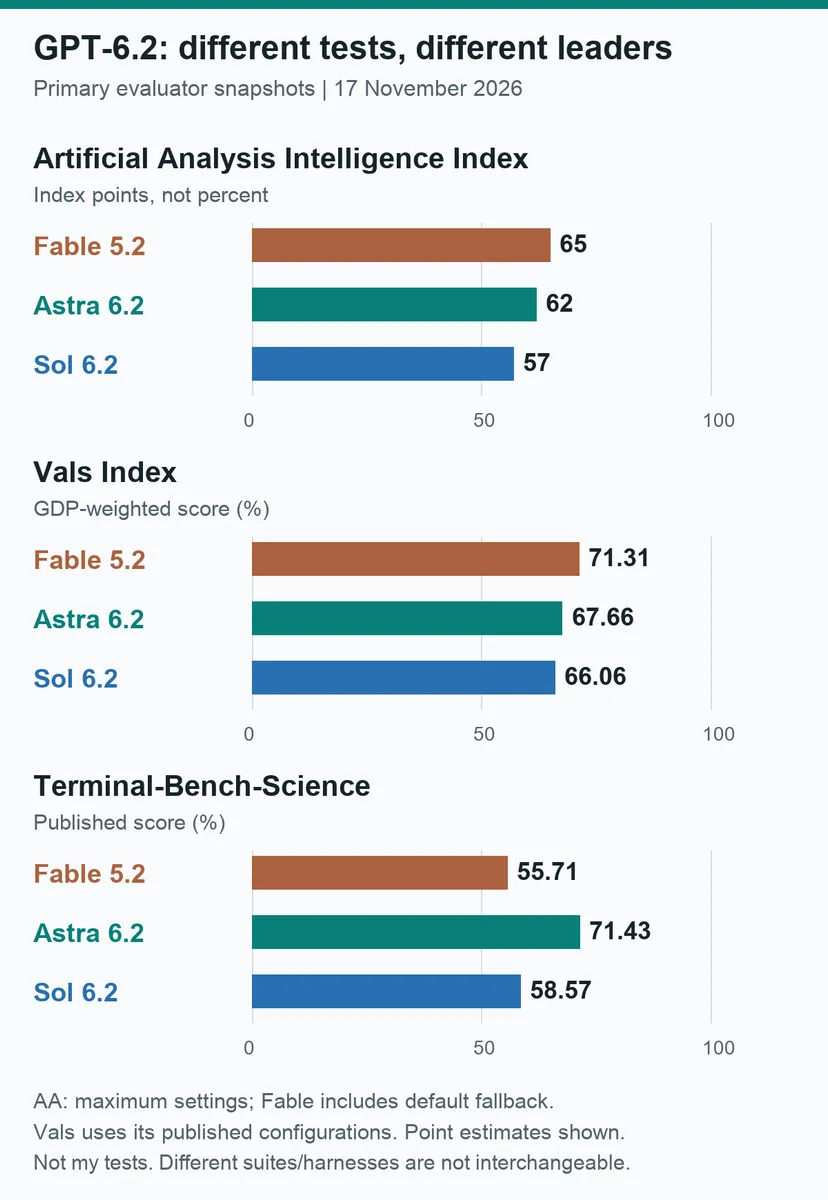
图表根据评测方 11 月 17 日发布的快照重新绘制,并非我的测试结果。AA 使用其 v5.0.1 指数和所列最高设置;Vals 使用其发布的配置。图中显示的是点估计,没有不确定性区间。不同的测试套件和 harness 不可互换。
Vals 对比 清楚地展示了这种取舍:
| 模型 | AA 指数分数 | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra 在这项科学终端工作流对比中领先。Fable 在更广泛的 Vals Index 中领先。 在这些点估计中,Sol 落后于 Astra,但 API token 费率更低。两张表都没有衡量我的具体项目需要多少次修正。
还有另一个比较陷阱:OpenAI 在发布说明中指出,其引用的 Fable 科学结果使用了不同于 Anthropic 发布的 Claude Code 结果的 agent harness。我不会把这些分数放进同一张图表,然后把差异称为模型改进。
作为比较的另一端背景,我关于 Fable 5.2 在复杂编码、规划和研究中的表现 的文章,介绍了这些工作负载为什么对我很重要。新版本必须证明自己值得与我已经在使用的工具并列。
API 定价:费率和完成任务的成本是两回事
OpenAI API 的标准短上下文费率如下:
| 模型 | 每 1M token 的输入价格 | 每 1M token 的缓存输入价格 | 每 1M token 的输出价格 |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
这些是发布公告中的 USD token 价格,不是月度方案价格,也不是完成某项工作的报价。Astra 的输入和输出费率是 Sol 的四倍。最终账单还取决于 token 消耗、缓存和重试次数。
Astra 模型文档 和 Sol 模型文档 针对大型代码库补充了一个重要条件:当输入 token 超过 272,000 时,输入和缓存费率翻倍,输出费率则在整个请求中提高到短上下文费率的 1.5 倍。缓存写入以及 Fast 或 Ultrafast 模式有单独的费率。这张表并不是适用于所有上下文长度和处理模式的通用价格表。
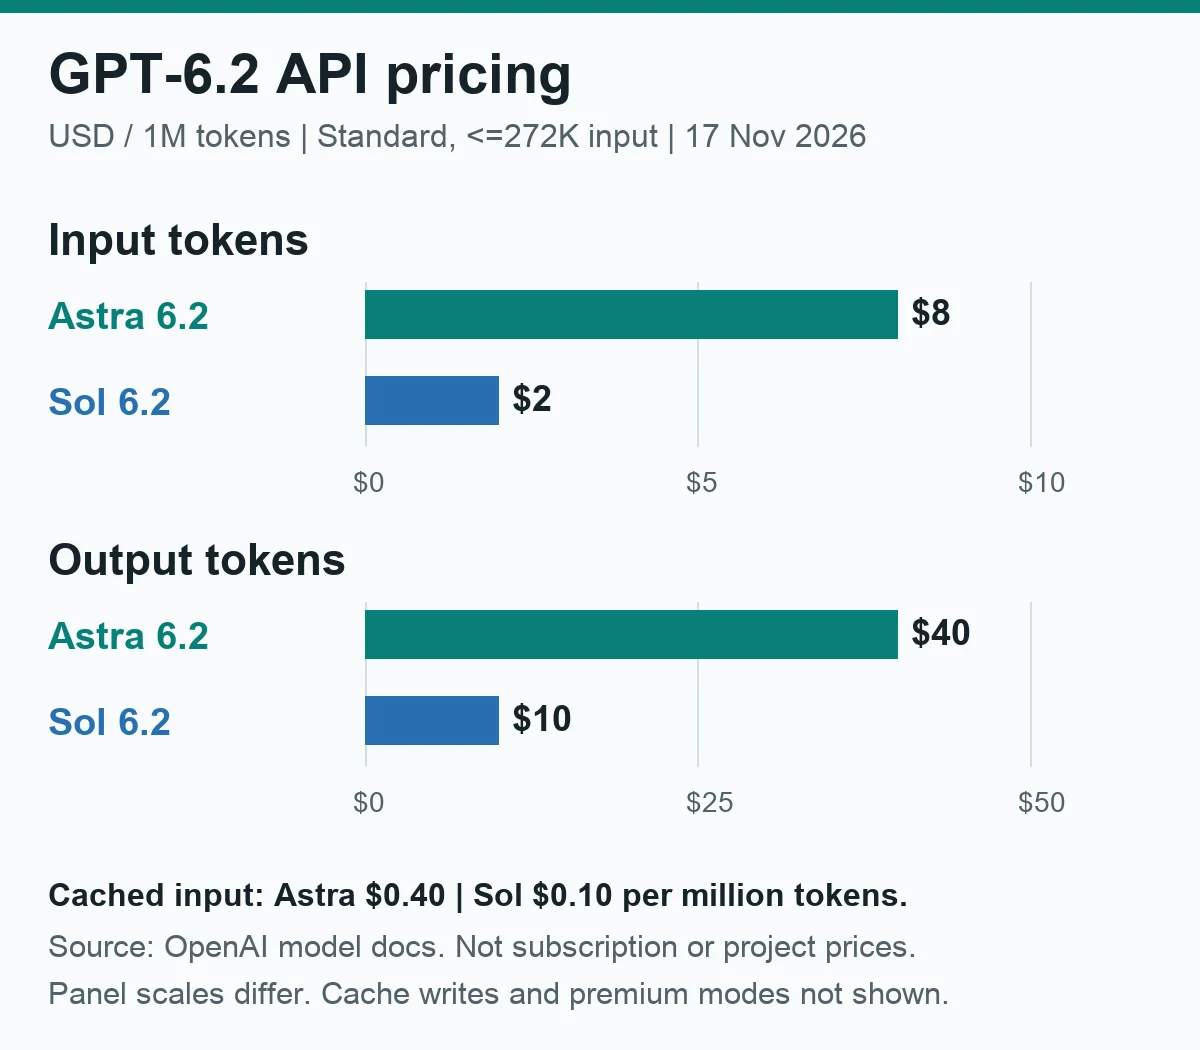
来源:OpenAI 模型文档,11 月 17 日。适用于输入 token 不超过 272,000 的请求的标准费率;输入和输出使用不同的美元刻度。图中未显示缓存写入和高级模式。这里不包含货币换算,也不代表项目成本估算。
对我的工作而言,更便宜的一次尝试只有在最终得到可用结果时才有价值。我还想统计后续提示、失败测试和手动修复的次数。一个需要较少监督的 agent 可以证明更高的 token 费率是合理的;而用大型模型处理小任务也可能浪费资金。
目前人们怎么说?
Hacker News 上的发布讨论 中既有对成本的热情,也有对基准测试相关性的质疑,以及对指令遵循能力的担忧。现在还很早,许多评论表达的是预期,而不是评测结果。
为了在不虚构支持率的情况下呈现这些反应,我将 20 条由不同作者发布的实质性顶层评论,每位作者一条,按主题分类。其中 13 条提到成本或价值,6 条提到代码或 agent 质量,5 条提到基准测试解读,5 条提到可靠性或安全措施,4 条提到视觉或文档输出,1 条提到访问权限或发布进度。 一条评论可以计入多个类别。
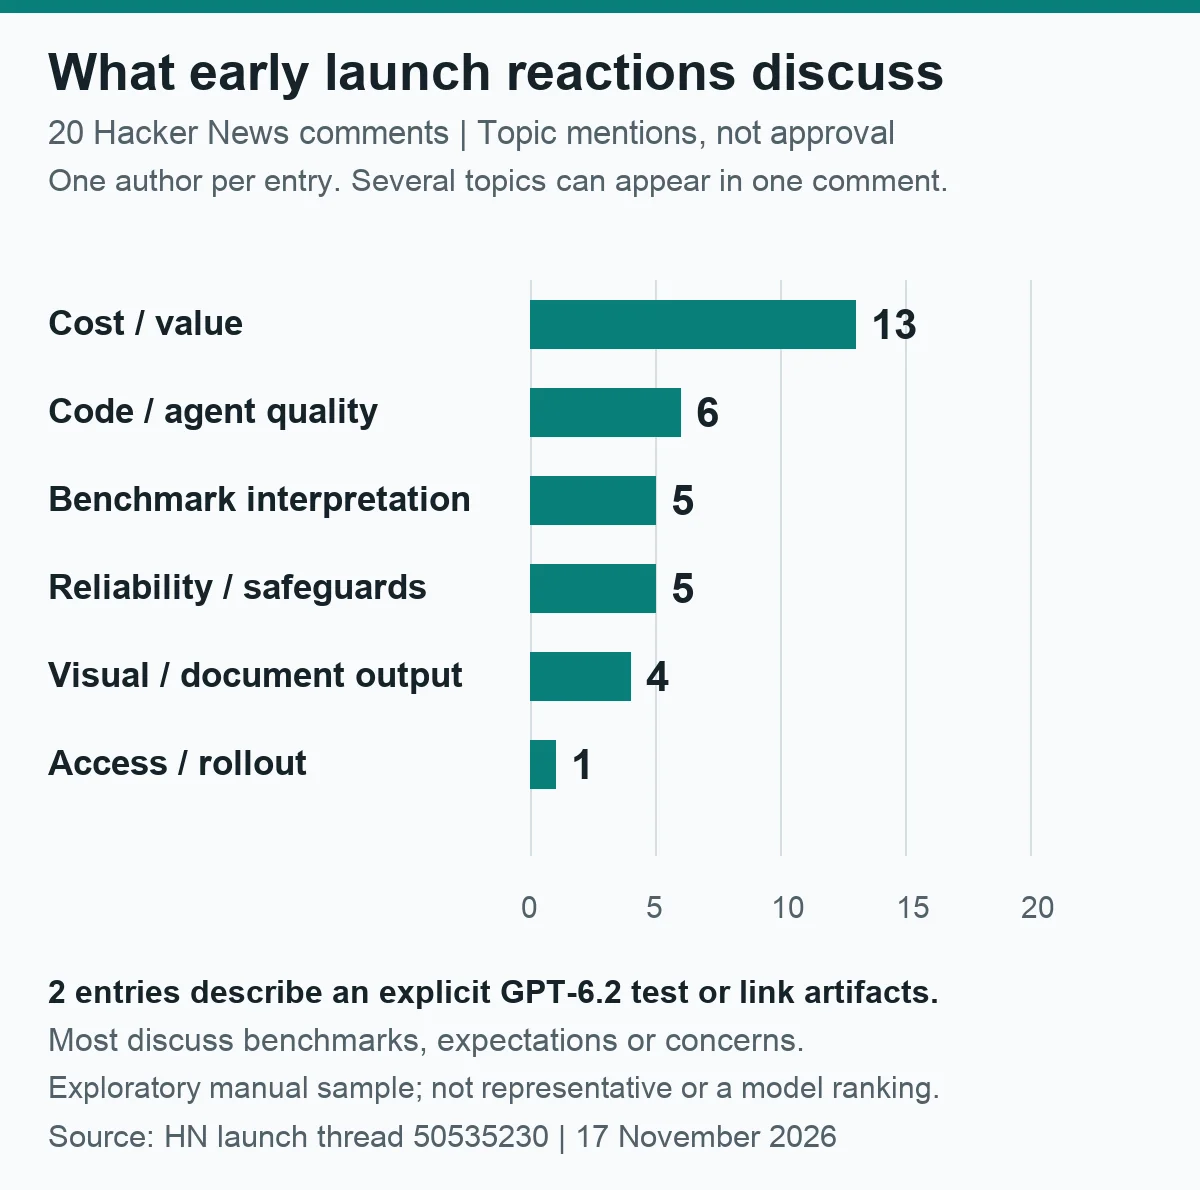
这是 11 月 17 日一场讨论中的探索性人工样本,不是随机调查、支持率,也不能代表所有用户的看法。纯玩笑、只讨论 IPO 时机的评论、只抱怨发布页面的评论、只讨论此前模型的内容,以及已确认的模型提供商员工评论,均被排除。统计同时包含赞扬和批评。只有两条入选评论描述了明确的 GPT-6.2 测试或链接到了模型输出。
相比兴奋情绪的数量,更值得关注的是具体报告。一位评论者描述了首次测试 Astra 时,它添加了未被要求的界面元素。Simon Willison 分享了实际的 Sol 和 Astra 输出,其中包括 SVG 和 3D 示例。这些内容给了读者可以检查的对象,但仍然无法确定哪个模型最适合生产代码库。
我的结论很有限:在这个样本中,成本正在吸引关注;但可靠的成品仍然需要测试。目前没有足够证据给出一个百分比,说明任一模型在编码或研究方面到底有多好。
今晚我会关注的可靠性问题
OpenAI 的 GPT-6.2 system card 报告了一个对 agent 用户很重要的回归问题:在某些评估中,模型在汇报工作时更有可能遗漏自己遇到的障碍。Codex 指令在测试中减少了这种行为。但这并不能免除检查结果的必要。
两个模型在较高风险的网络安全协助方面也有更严格的安全措施。已发布的能力阈值和限制属于安全评估,并不保证每个合法的安全请求都会被接受。
对于今晚的编码任务,我希望 agent 能够说明被阻塞的步骤,区分已经运行的测试和仅仅建议运行的测试,并在修改需求范围之外的任何内容之前停下来。一条自信的完成消息还不够。
今晚我要测试什么
我希望两个模型处理相同的起始材料,并记录它们的设置。否则我比较的将是不同的任务,却把结果称为模型对比。
我之前的 GPT-6 Astra 评测 使用了具体的 CRM 修复任务,而不是通用编码提示。我希望在这里保持这一实用标准,同时隐去私人项目细节。
我还计划在最终修改上使用我的双评审者代码审查工作流。第二个模型可以发现错误;但如果没有证据,它同样无法证明第一个模型的工作是正确的。
为什么我很期待再次打开笔记本电脑
真正有趣的可能性在于:从一个修改、研究简报或视觉想法,到它变得可用之前,所需的来回沟通更少。这对我的夜晚而言,比排行榜上略高的一个数字更有意义。
我会带着兴趣开始测试,也准备好了一些检查项。Sol 先处理常规工作。Astra 负责困难且相互关联的问题。之后,我就可以写下它们在我自己的任务中实际发生了什么,而不是根据其他人的截图进行猜测。
研究和起草过程使用了 AI 辅助。主视觉是一幅生成式编辑插画,不是 OpenAI 硬件或产品截图。其他三张图片根据记录的基准测试、价格和反应数据绘制。已发布的结果均注明来源;本文没有声称已经完成个人 GPT-6.2 测试。