我花在 Google 模型上的时间,远少于工作流程中其他 AI 工具。Gemini 4 Argon 给了我改变这一点的理由。业务自动化结果看起来很有用,而且公布的初始价格与 GPT-6.1 Sol 处于同一档,而不是只有高价模型才能提供的方案。
我想在开放访问后进行测试。目前,这篇文章关注的是已发布的证据、定价和早期反馈,而不是亲自使用 Argon 后撰写的评测。
来源核查日期:2026 年 10 月 1 日。封面是 AI 生成的编辑插图。下方图表重新绘制了文中引用的数值结果,并非我个人测试的截图。
Gemini 4 Argon 是什么?现在可以使用吗?
Google 于 2026 年 9 月 30 日宣布了 Argon,最初将通过 Fairwind 面向受信任的网络防御人员开放。更广泛的访问将从付费 API 客户和 Google AI Ultra 订阅者开始;公告没有给出明确的公开发布日期。请参阅 Google 的 Gemini 4 Argon 公告。
在实际获得账户访问权限之前,我不会为了 Argon 专门购买订阅。已经宣布的发布计划,与我今天就能选择使用的模型并不是一回事,而且 Google 在该公告中也没有承诺瑞典的可用日期。
对我来说,最值得关注的理由,是它有可能让我以更少的干预完成更长的任务。我的有效测试将涉及现有代码、棘手的业务规则,以及能够证明最终结果确实有效的证据。仅凭一个经过润色的答案无法说明问题。
Gemini 4 Argon 定价:初始价格有一个限制
Google 公布的价格是每百万 tokens 输入 $2、输出 $10。其定价脚注将后续价格设为 $4/$20,但没有说明初始价格的结束日期。缓存输入可享受 95% 的折扣,按此计算,初始价格为 $0.10。
| 模型或定价阶段 | 输入 / 1M tokens | 输出 / 1M tokens |
|---|---|---|
| Gemini 4 Argon,初始价格 | $2 | $10 |
| Gemini 4 Argon,初始阶段结束后 | $4 | $20 |
| GPT-6.1 Sol,Standard | $2 | $10 |
| Claude Opus 5.5,Standard | $4 | $20 |
| GPT-6 Astra,Standard | $10 | $50 |
来源:Google 的公告及扩展定价脚注、GPT-6.1 Sol 模型定价、GPT-6 Astra 模型定价 和 Claude Platform 定价。
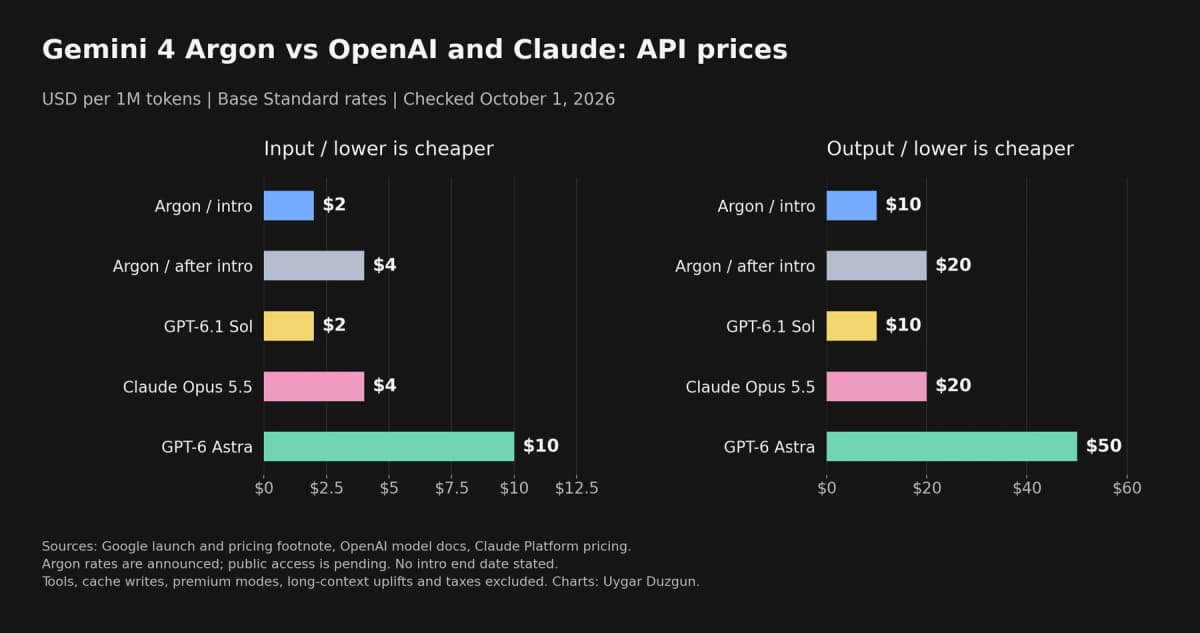
基础美元价格核查日期为 10 月 1 日。Argon 的价格是已公布的费率,并不能证明 API 已普遍开放。比较不包括工具、缓存写入、高级模式、地区费用和税费。
举一个简单的预算例子:在多次短上下文请求中,使用 100 万个未缓存输入 tokens 和 10 万个输出 tokens,按 Argon 的初始价格计算为 $3,初始阶段结束后为 $6,使用 Sol 为 $3,Opus 为 $6,Astra 为 $15。这只是基于固定 token 组合的算术计算,并不是经过测量的工作负载。同一任务在不同模型上可能消耗不同数量的 tokens。
OpenAI 还会对单个提示中超过 272,000 个输入 tokens 的完整请求提高价格;Anthropic 则针对 Opus 5.5 的上下文窗口列出标准价格。因此,基础价格表无法告诉你一次超大型代码仓库会话的实际账单。我的 GPT-6.1 Sol 与 Opus 5.5 对比介绍了这些取舍。
我会按照 Argon 的后续价格为集成项目做预算,然后把促销优惠视为临时节省。这样可以避免围绕一个尚无法安排结束日期的折扣来构建商业论证。
Gemini 4 Argon 基准测试:自动化表现强劲,编码结果不一
业务自动化是我最关注的结果
Zapier 的 AutomationBench 1.0.6 测试六个业务职能中、跨越 47 个工具的端到端工作。它通过确定性断言检查最终环境,而不是根据 agent 具有说服力的最终消息进行评分。
下方选定的配置保留了各自的工作量设置和回退行为。
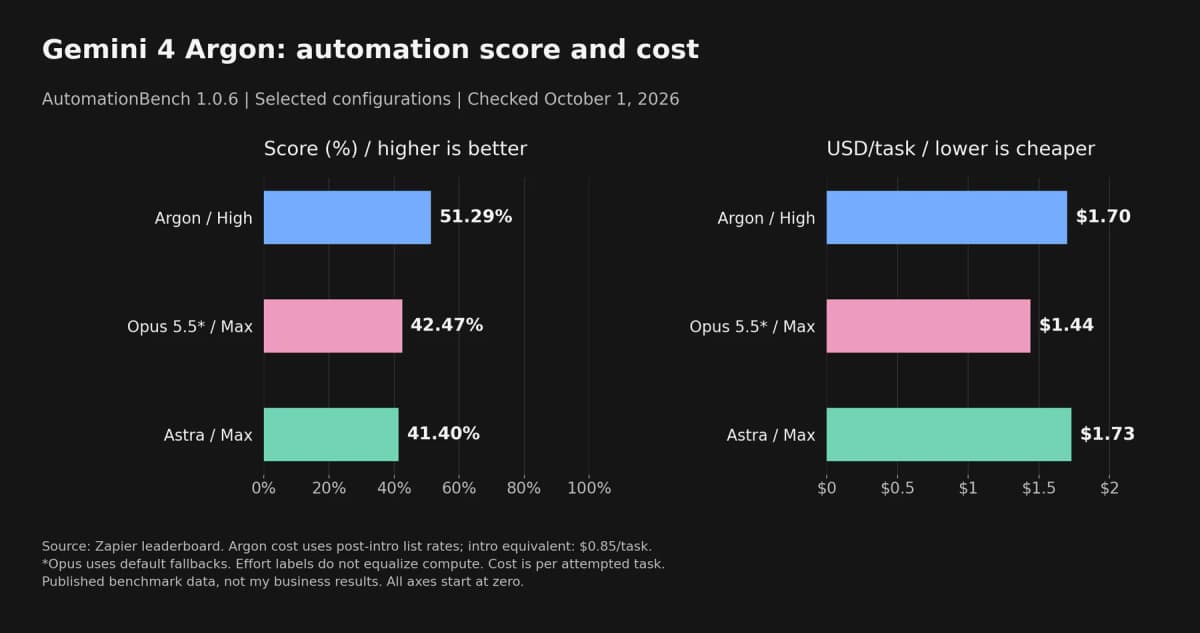
Zapier 报告称,Argon High 的得分为 51.29%,按后续列表价格计算,每次尝试任务的成本为 $1.70;按初始价格计算则为 $0.85。启用默认回退的 Opus 5.5 Max 得分为 42.47%,成本为 $1.44;Astra Max 得分为 41.40%,成本为 $1.73。不同提供商之间的工作量标签并不对应相同的计算预算。
在这项比较中,Argon 的得分更高,但其普通任务成本并不是最低的。大约 51% 的基准测试得分,也不足以证明可以在无人监管的生产环境中使用。我仍然希望对重要操作设置审批机制,保留可检查的日志,并提供从部分完成状态中恢复的方法。
这一点对业务自动化很重要。我关心的是正确的记录是否被更新,以及正确的收件人是否收到了消息。agent 告诉我它已经完成,不能替代这些检查。
编码结果取决于任务
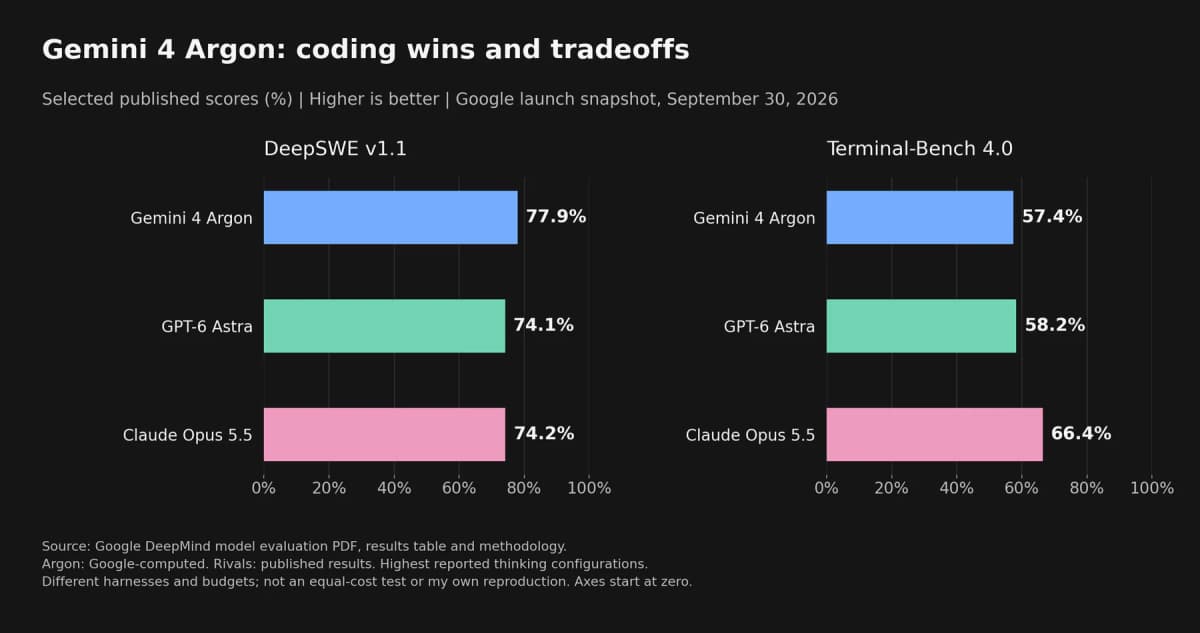
选定得分来自 Google DeepMind 的模型评估报告。这里将 Google 计算的 Argon 结果与已发布的竞争模型结果结合起来,并不是统一条件下的独立正面对比测试。
Argon 在 DeepSWE v1.1 上达到 77.9%,Astra 为 74.1%,Opus 为 74.2%。在 Terminal-Bench 4.0 上,Opus 以 66.4% 领先这三者,其次是 Astra 的 58.2% 和 Argon 的 57.4%。报告还显示,在 FrontierSWE v2 上 Astra 领先:65.5%,而 Argon 为 55.0%。
Google 通常报告其最高思考设置,以及竞争模型已发布的最高或最佳可用结果。测试框架和预算都很重要。在某个代码仓库基准测试上领先,并不能保证在我的代码库中修复效果更好,尤其是在差距只有几个百分点时。
我会分别测试一个范围明确的回归修复和一个多文件变更。两者都需要行为检查和 diff 审查。模型可能通过测试,却添加一个我不想维护的抽象层。
独立的知识工作证据提供了更多背景
Vals Index 2.1 于 9 月 30 日更新,其中 Argon 为 68.90%,Opus 5.5 为 66.97%,Astra 为 63.13%,Sol 6.1 为 61.15%。Vals 将金融、编码、法律和税务任务结合起来,并根据美国 GDP 设置行业权重。
其成本列让排名变得更加复杂:按 $4/$20 的 token 价格计算,Argon 每项测试的成本为 $15.68,而 Sol 为 $3.24。这些是特定于基准测试的成本,并不是我的工作报价。它们说明,即使另一个模型在得分列中排名第一,我仍会在评估中保留更便宜的模型。
我会在测量任务后再进行路由。简单的重复性工作和代价高昂的失败,不应自动使用同一个模型。
其他人如何评价 Argon?
早期的 Gemini 4 Argon 发布讨论中既有兴奋,也有对访问受限的沮丧,以及对后续价格的提醒。这些是个别用户在发布初期的反应,并不代表具有代表性的调查结果,也不能证明他们都实际试用过 Argon。关于可能需要等待数周或数月的评论属于推测。
对我来说,更有用的讨论出现在 Rust 社区关于 Google 代码库迁移的讨论中。一位名为 nicoburns 的评论者认为,由于原始设计已经存在,语言之间的转换可能会更有效。其他人则描述了可维护性问题,以及他们花费在修正生成代码上的精力。
这场讨论涉及 agent 辅助的软件工程这一更广泛的领域。它并不能证明 Argon 在现实世界中的可靠性。我认真看待其中的实际启示:将行为与原始实现进行比较,让变更保持可审查,并衡量之后还剩下多少人工工作。
我计划如何测试 Gemini 4 Argon
我已经足够好奇,愿意给 Google 一个公平的机会。我会从可以验证的任务开始,而不是一开始就让模型接管所有事情。
我希望记录耗时、token 成本、重试次数、正确性和审查工作量。问题在于,Argon 是否能减少我的总工作量,包括检查和修复结果所需的工作。
Google 的公告还将输出上限提高到了 100 万 tokens。这是上限,而不是目标。我仍会设置预算和停止条件;更多可用的推理应该值得其成本。我关于 AI 推理 tokens 与计算成本的文章解释了我为何关注这种取舍。
Gemini 4 Argon 看起来值得测试。我还没有充分使用 Google 的模型,因此无法公平地将它纳入我的工作流程。这些结果让我希望在能够访问该模型后改变这一点,同时在我自己的测试提供更多信息之前,继续把 Sol、Opus 和 Astra 作为真正的替代方案。