我使用 Claude Haiku 5.5 进行翻译、快速文本修改、校正和轻量部署工作。这些任务需要一个能够遵循明确要求,并在不把小修改变成大型项目的情况下完成工作的模型。
努力设置很重要,因为这些任务的难度并不相同。修正一个拼写错误和翻译一篇包含技术术语的页面,应该有不同的起始设置。
这是 AI Models in Practice 系列的第 1 部分,该系列讨论如何为实际工作选择模型。下面的示例是可复用的提示词和建议设置。我没有对每个努力级别进行受控比较,示例翻译是编辑参考示例,并非记录下来的 Haiku 输出。模型详情和价格已根据 Anthropic 的文档于 2026 年 10 月 12 日核对。
目录
什么是 Claude Haiku 5.5?
Claude Haiku 5.5 是 Anthropic 面向高吞吐量、时间敏感型工作的轻量模型选项。Anthropic 于 2026 年 10 月 7 日发布了它,并将其定位用于摘要、分类、提取、路由和范围明确的子代理任务。Claude API 模型 ID 是 claude-haiku-5-5。请参阅 Claude Haiku 5.5 发布公告。
Haiku 5.5 模型概览 列出了文本和图像输入、文本输出、100 万 token 的上下文窗口,以及 Messages API 中最高 128,000 个输出 token。它默认使用自适应思考。较大的上下文窗口说明的是容量;这并不意味着发送整个代码仓库就是有用或经济的做法。
在要求 Haiku 解读整个业务之前,我会先给它一段文字、一个术语表和明确的编辑任务。范围更窄的要求更容易检查结果。
Haiku 5.5 适合做什么?
我的实际候选清单从我已经使用它完成的工作开始:
其他值得评估的任务包括从给定文档中提取字段、将消息归入已知类别,以及总结一段简短的支持对话。这些是建议用途,并非来自我个人基准测试的结果。
对于广泛的工程工作,模型选择值得重新考虑。Anthropic 的发布材料建议在更复杂的代理式编码任务中使用 Sonnet 5.5 和 Opus 5.5。提高 Haiku 的努力级别,并不能保证它具备与更大型号相同的能力。
五个努力级别分别意味着什么?
Haiku 5.5 支持 low、medium、high、xhigh 和 max。默认值是 medium。努力级别会引导模型在响应上投入多少工作;它不是固定的 token 预算,也不是准确性保证。它会影响思考、回答文本和工具调用。请参阅 Anthropic 的努力级别文档。
| 努力级别 | 官方起始建议 | 我建议的用途 |
|---|---|---|
low | 简短、简单且对延迟敏感的任务 | 修正拼写错误或进行简短、明确的翻译 |
medium | 大多数工作的默认设置,包括范围明确的编码任务 | 普通翻译或带有约束条件的小型文本编辑 |
high | 知识型工作、较长的代理任务、严格遵循指令 | 术语含义模糊,或必须满足多项规则的编辑 |
xhigh | 在评估显示质量有所提升时使用 | 对困难但范围明确的任务进行实验;与 Sonnet 比较 |
max | 在评估证明额外成本合理时使用 | 特殊测试案例,在检查较低级别之后使用 |
我的起始规则是:先使用 medium,再根据你看到的错误进行调整。对于非常简单的校正,可以尝试 low。对于依赖术语表的翻译,可以比较 medium 和 high。保持提示词和输入不变,这样才能判断设置是否确实有所帮助。
一次部署可能只涉及一条命令,但仍然会带来重大后果。我会独立决定其验证和审批要求,而不是由努力级别决定。
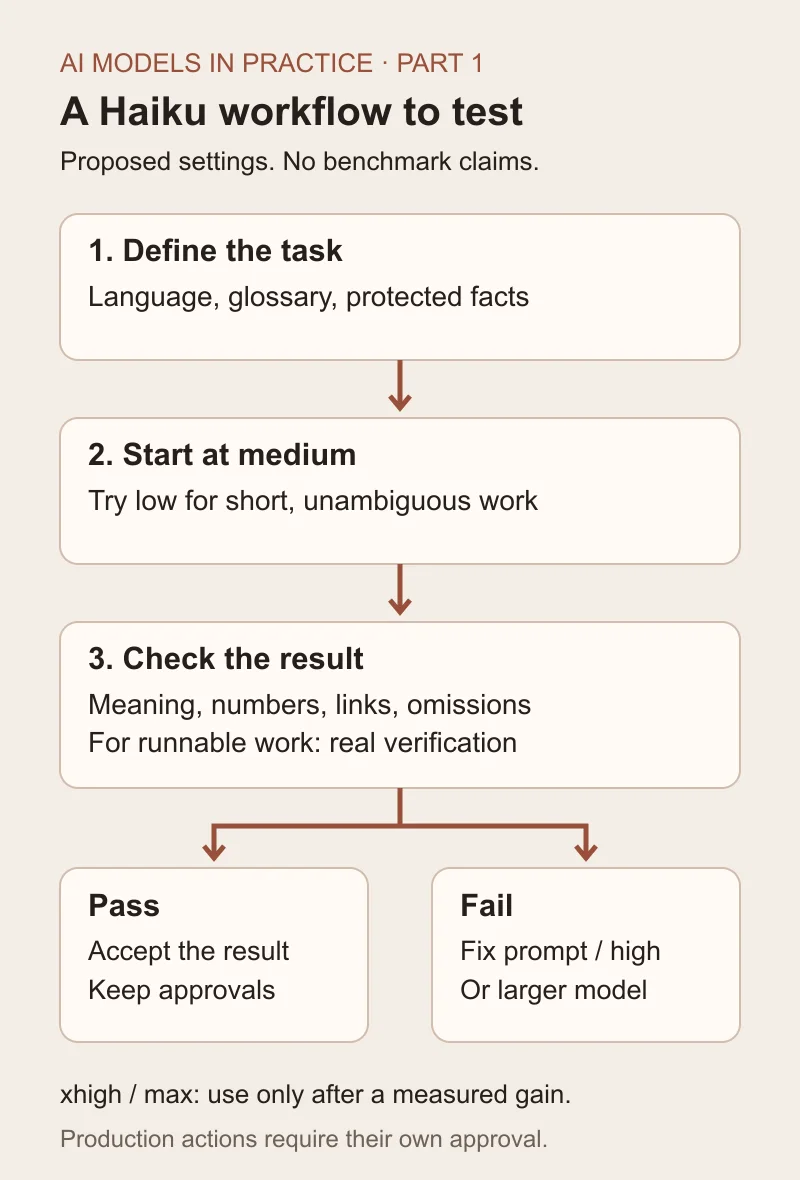
这是建议的工作流程,而非基准测试证据。“接受”意味着结果通过了该任务所需的检查;发布和生产环境操作仍保留各自独立的审批步骤。
我会如何为翻译设置努力级别
翻译最能说明为什么一个默认设置无法适用于所有情况。这些设置是用于评估的起始假设,而不是经过测量得出的最佳选择。
简短直译文本使用 Low
简短的状态消息几乎没有歧义:
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
一个可接受的编辑参考译文是:“Your order 1842 was dispatched on 12 October 2026.” 重要的检查项是订单号、日期和含义。多种英文表达都可能合格。
这里我会尝试使用 low,如果它遗漏了某个细节,再提高级别。为这个提示词添加额外推理,应该通过更好的结果来证明其价值。
普通网站文案使用 Medium
对于一个段落,我会从 medium 开始,并明确受众、地区、语气和受保护术语:
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
一个编辑参考译文可以是:“We normally update the page within two working days. It may take longer if we need additional information.” 如果译文承诺会在两天内完成更新,就改变了原文的陈述。
Anthropic 的多语言支持指南建议明确说明源语言和目标语言,并考虑地区语境。其发布的语言表涵盖较旧的模型,包括 Haiku 4.5;它不能作为 Haiku 5.5 翻译准确性的证据。
术语或歧义需要特别关注时使用 High
有些术语取决于业务语境。瑞典语单词“reklamation”不应自动翻译成“advertising”。根据句子,它可能应译为对产品故障的投诉或索赔。
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
对于这类任务,我会比较 medium 和 high。成功标准是译文是否保留了条件,并使用了预期术语。仅仅表达流畅是不够的。
对于结构化内容,我会发送带有稳定标识符的可翻译字符串。应用程序会检查每个标识符是否恰好返回一次,以及受保护的值是否保留。要求模型保留大型 JSON 文件,并不能替代解析和验证。
快速文本修改与校正
校正提示词应该定义允许进行的编辑。否则,“修正语法”的请求可能变成重写。
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
编辑参考结果是:“We have updated the page, but the payment tests are not finished yet.” 如果译文说页面已经完成全面测试,就不符合要求。
对于这样的句子,low 是一个合理的评估设置。对于多个段落、受保护链接或多项约束,我建议从 medium 开始。
对于文本修改,要明确要求具体结果:“将这段文字缩减到 80 个单词,保留两个限制条件,并保留链接。” 字数和链接保留情况都可以独立于模型进行检查。
轻量部署工作:定义什么才算完成
我将简单的部署工作也列为 Haiku 的用途之一,但“简单”需要明确范围。针对已批准的文本变更执行已知部署流程,与诊断失败的发布或决定如何迁移数据库,是不同的任务。
一个可复用的指令可以是:
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
对于准备工作和检查,我会从 medium 开始。如果工作需要跨系统调查故障,我会重新评估模型和努力级别,而不是继续把它称为轻量任务。
Anthropic 的 Haiku 专用提示词指南指出,使用较低努力级别的代理处理较长提示词时,可能会提前停止或遗漏检查。该指南建议明确写出验证指令。指南还指出,在 xhigh 下的多轮对话中,偶尔可能出现可见回复为空的情况;当思考功能与结构化输出同时禁用时,也可能出现工具调用问题。集成系统应检测不完整结果,而不是默默接受它们。
如何在 Claude 或 API 中更改努力级别?
在 Claude 应用中,打开发送按钮旁边的模型菜单,选择 Haiku 5.5,然后选择 Effort。可用选项可能取决于账户或管理员设置。Anthropic 表示,在 Claude 应用中无法关闭 Haiku 5.5 的思考功能。请参阅更改模型、努力级别和思考设置。
API 提供了更直接的控制方式。最小请求体如下:
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
这是示意性的请求结构,并非我实际执行过的请求。请将段落放入 user 消息中。max_tokens 是上限,不是预留额度,也不是要求生成长答案。
Anthropic 的 Haiku 5.5 迁移指南解释说,思考会消耗该输出预算,因此较小的限制可能会在可见文本出现之前截断响应。应根据区块的 type 选择响应区块,而不要假设第一个区块包含答案。
对于新的 API 请求,请省略 temperature、top_p 和 top_k。将旧的启用思考加 budget_tokens 配置替换为自适应思考。API 允许在 low、medium 和 high 下禁用思考;xhigh 和 max 则要求使用自适应思考。该指南还列出了不同提供商之间的差异,因此迁移前应验证实际使用的平台。
将 API 密钥保存在服务器端。努力级别字段是配置项,不是将凭据放入前端代码的理由。
Haiku 5.5 的价格是多少?
Anthropic 的 API 定价文档列出了以下以美元计价的每百万 token 标准费率,已于 2026 年 10 月 12 日核对:
| 提示词长度 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| 不超过 100,000 个 token | $0.10 | $0.50 | $0.01 |
| 超过 100,000 个 token | $0.50 | $2.50 | $0.05 |
较高费率适用于整个请求,包括作为缓存读取或写入计算的输入。这些是 API token 价格;Claude 订阅是独立的产品。缓存写入、服务器工具和平台调整项可能会增加成本。
以一个未缓存的示例请求为例,其中包含 2,000 个输入 token 和总计计费的 1,000 个输出 token:
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
该计算不包括额外费用,也不是经过测量的翻译成本。思考 token 会计入计费输出。更高的努力级别可能会改变 token 使用量,因此仅凭价格表无法预测完成一项任务的成本。
我会在这些任务中始终遵循的最佳实践
给模型最小但完整的任务。提供它所需的术语表或已批准的源文本,并避免无关材料。
说明输出要求。对于翻译,明确两种语言和地区。对于编辑,指定哪些事实和格式必须保留。对于代理,定义检查项目和停止点。
将源文本视为待转换的内容。嵌入文档中的句子不应因此获得更改任务、访问凭据或发布内容的权限。
根据任务验证结果。检查受保护术语、数字、链接和遗漏段落。对于代码或部署工作,检查实际的测试和运行时证据。
根据具体失败进行升级。遗漏限定条件说明可能需要更换提示词或努力级别。不断扩大的任务可能需要 Sonnet 或 Opus。反复失败应触发复查,而不是无限提高努力级别。
在依赖这些设置之前,我会如何测试它们
我会从 20 个经过批准且匿名化的示例中建立一个小型评估集:十个翻译、五个校正和五个受约束的文本编辑。这些数量描述的是拟议测试,而不是已经完成的研究。
使用相同的输入和验收标准运行 low、medium 和 high。重复测试案例,以暴露不一致的行为。让熟练的审阅者在不知道设置的情况下评判翻译。
记录确切的模型、努力级别、提示词版本、耗时、计费 token 和缺陷。统计遗漏限定条件、改动数字、损坏链接、遗漏文本和不必要重写的次数。比较每个合格结果的成本,包括修复工作。
对于部署辅助,在非生产环境中评估独立的准备任务,并使用已知的预期结果。生产操作仍须遵循项目的审批流程。
我现有的实际工作中的 AI 模型基准测试指南→介绍了更广泛的评估方法。GPT-6.1 Sol 与 Opus 5.5 对比→为大型号选择提供了背景;它不是 Haiku 翻译测试。
系列从小任务开始
Haiku 是本系列的第一部分,因为翻译、校正和短文本编辑能让取舍变得清晰。你可以检查句子是否保留了原意,以及链接是否仍然有效。
接下来的部分将介绍用于日常编码和分析的 Sonnet、用于更困难工作的 Opus,以及最后一篇关于如何在模型之间路由任务的指南。每一部分都会采用相同的区分方式:已记录的能力、我的实际使用情况,以及仍待执行的测试。