Чорна скринька LLM — це практична проблема: модель може відповісти на складне запитання за лічені секунди, водночас залишаючи нас нездатними пояснити, які внутрішні обчислення до цього призвели. 15 жовтня 2026 року Нік Каммарата, співавтор дослідження нейронів OpenAI 2023 року, опублікував Neural Networks Are Already Clean як дослідник Goodfire. Він стверджує, що цю «чорну скриньку» може бути легше досліджувати, ніж вважалося в галузі. Це твердження заслуговує на увагу. Але його також потрібно уважно прочитати: есе є робочою гіпотезою, а супровідна технічна стаття про нейрони мовних моделей ще не опублікована.
Корисне запитання полягає в тому, чи можуть дослідники перейти від цікавого опису нейрона до надійного пояснення поведінки моделі. Каммарата наводить нові докази для першого кроку та кілька причинно-наслідкових демонстрацій другого. Жодне з цього не є повною картою великої мовної моделі.
Для пояснення простою мовою перейдіть до простої версії.
Чому чорна скринька LLM досі існує?
Дослідники знають математичні операції в навченій мережі. Складність полягає в поясненні того, як мільйони навчених компонентів поєднуються, щоб створити конкретну відповідь. Один штучний нейрон може активуватися на прикладах, які здаються непов’язаними. Якщо він реагує і на морду кота, і на передню частину автомобіля, що саме він представляє?
Однією з впливових відповідей була суперпозиція: модель може упаковувати непов’язані ознаки в перекривні внутрішні напрямки, оскільки має обмежений простір. Потім дослідники навчають другу модель, часто розріджений автокодувальник, щоб розділити ці ознаки.
Каммарата стверджує, що деякі класичні докази на користь цієї картини було неправильно витлумачено. Уявна суміш натомість може відображати спільний шаблон, недосконалий мікроскоп або архітектуру мережі, яка ускладнювала навчання наступних шарів. Його визначення суперпозиції конкретно стосується упаковування непов’язаних обчислень в один механізм; інші дослідники використовують це слово ширше — для позначення представлення більшої кількості понять, ніж існує вимірів. У своєму есе він пояснює цю відмінність.
Що змінилося в новому дослідженні?
Знайомий нейрон кота й автомобіля походив із моделі комп’ютерного зору, а не з LLM. Тепер Каммарата описує його як такий, що реагує на спільний візуальний шаблон у формі літери V. За його поясненням, нейрон групує споріднену візуальну структуру, а не приховує два довільні поняття в одному слоті. Він також повідомляє, що після архітектурних змін в InceptionV1, моделі комп’ютерного зору, 99–100% нейронів її фінального шару стали легкими для інтерпретації, тоді як розмір моделі та навчальні дані залишилися незмінними. Це твердження стосується перенавченого шару моделі комп’ютерного зору. Це не статистика про сучасні чат-моделі.
Докази щодо мовної моделі більш релевантні для LLM і більш попередні. Команда Goodfire оцінює, що під час початкового аудиту Qwen3-32B приблизно 90% полюсів нейронів мають одну основну функцію, часто з невеликими спорідненими відгалуженнями. Ще приблизно 7% мають дві споріднені функції, а близько 2–4% залишаються нез’ясованими.
«Полюс» означає одну сторону позитивної або негативної реакції нейрона; цей відсоток не означає, що пояснено 90% поведінки LLM. Каммарата зазначає, що класифікація змінюється залежно від порога слабких активацій, глибини моделі, щільності схем і того, що вважати однією функцією. Ці застереження наведено поруч з оцінкою.
Команда пропонує не лише мітки для активацій. Її інтерактивне есе містить 1 000 випадково вибраних прикладів дослідження нейронів із Qwen3-32B і Qwen3.6-35B-A3B. В одному тесті агент використовував письмові пояснення, щоб вигадати приклади, які мали активувати нейрон, і близькі випадки, які не мали цього робити. Серед 183 нейронів із поясненнями їхньої позитивної сторони нові приклади викликали сильну активацію у 76% випадків, тоді як близькі випадки — у 11%. Це корисний тест прогнозування в межах підходу команди. Він не доводить, що описи охоплюють кожну важливу активацію або подальший ефект.
Чи можуть дослідники змінити відповідь LLM шляхом втручання?
Так, у вибраних прикладах. Goodfire відстежує групи нейронів Qwen3-32B, а потім видаляє їх, щоб побачити, що зміниться. У запиті, підказки якого вказують на Санта-Клауса, видалення восьми вибраних нейронів, пов’язаних із відповіддю, знизило заявлену моделлю ймовірність слова «Santa» до 0,059; видалення такої самої кількості випадкових нейронів із відповідних шарів залишило її на рівні 0,997. Це свідчить, що вибрані нейрони мали значення для цього запиту та передбачення наступного слова. Це не виміряний показник успішності для довільних запитів або моделей. Втручання та контроль показано в оригінальному есе.
Каммарата також показує граф атрибуції на основі нейронів для Kimi K3 — моделі з кількома трильйонами параметрів. Приклад із гаманцем простежує деякі шляхи від запиту до відповіді про повернення загубленого майна. В есе показані групи названо вибраним фрагментом, а також зазначено, що повні аудити в такому масштабі ще не розпочалися. Читабельний фрагмент дуже великої моделі є перспективним, але він не може сказати нам, що робив кожен пропущений шлях.
Як реагують інші дослідники?
17 жовтня дослідник Лео Гао опублікував Neural networks are not already clean. Він погоджується, що попередні дослідження могли надто швидко називати нейрони поліcемантичними.
Його заперечення полягає в тому, що акуратний опис найяскравіших прикладів усе ще може пропустити входи, які мали б активувати нейрон, слабкі реакції, що мають значення, або важливість сили активації. Гао пропонує суворіший тест: замінити значення нейрона значеннями, передбаченими на основі пояснення, а потім виміряти, чи поводиться решта моделі так само. Якщо поведінка погіршується, пояснення пропустило щось важливе.
Пряма відповідь Ніла Нанди проводить споріднену відмінність. Він бачить практичну цінність у використанні власних нейронів і графів атрибуції для дослідження конкретної підозрілої поведінки. Водночас він не переконаний, що це доводить близькість масштабного зворотного проєктування, і особливо вказує на слабкі активації в LLM та інформацію в залишковому потоці. Сам Каммарата зазначає, що увага в цій роботі вивчена меншою мірою, а величезні мовні моделі ще далекі від повного картографування.
Ця суперечка є продуктивною. Goodfire запитує, чи можуть власні компоненти мережі бути відправною точкою для інтерпретації. Гао та Нанда запитують, наскільки багато має передбачати пояснення, перш ніж ми зможемо йому довіряти. Нейрон може здаватися зрозумілим, причинно брати участь в одній відповіді й водночас мати важливу поведінку, яку ми ще не охопили.
Ще дві реакції чіткіше окреслюють тягар доказування. У тій самій публічній дискусії Джон Вентворт просить пояснення для кожного нейрона представленої моделі комп’ютерного зору ConvNeXt із доказами на користь кожної інтерпретації. Він каже, що сам публічний мікроскоп не зробив значення цих нейронів одразу зрозумілими для нього. Це запит на артефакт, який можна перевірити, а не тест, що спростовує результати щодо LLM. Алекс Гібсон вказує на іншу прогалину: есе називає свій найбільший висновок дуже спекулятивним, тоді як деякі короткі дописи в соціальних мережах звучать більш упевнено. Це ранні індивідуальні реакції, а не загальногалузевий вердикт.
Чи робить це AI-систему безпечною або прозорою?
Із цих результатів не випливає жодного сертифіката безпеки. Пояснення одного нейрона є локальним твердженням. Граф атрибуції є частковим описом одного обчислення. Системне твердження про надійність потребувало б охоплення важливих схем, надійних тестів на пропущену поведінку та доказів того, що метод працює не лише на прикладах, вибраних для перевірки. Для систем, які використовують інструменти, дозволи AI-агентів→ усе одно мають обмежувати те, що може робити модель, незалежно від того, наскільки читабельними стають її внутрішні схеми.
Тут матимуть значення технічна стаття Goodfire про мовні моделі та незалежне відтворення результатів.
Існує також межа доступу. Ці експерименти перевіряють внутрішні активації та втручаються в компоненти. Якщо ваш продукт лише викликає розміщений чат API, ви не можете проводити такі самі тести над цією моделлю за допомогою звичайних запитів.
Проста версія
Запит надходить до AI-моделі, а назовні виходить відповідь. Складність полягає в тому, щоб зрозуміти, що відбулося всередині.
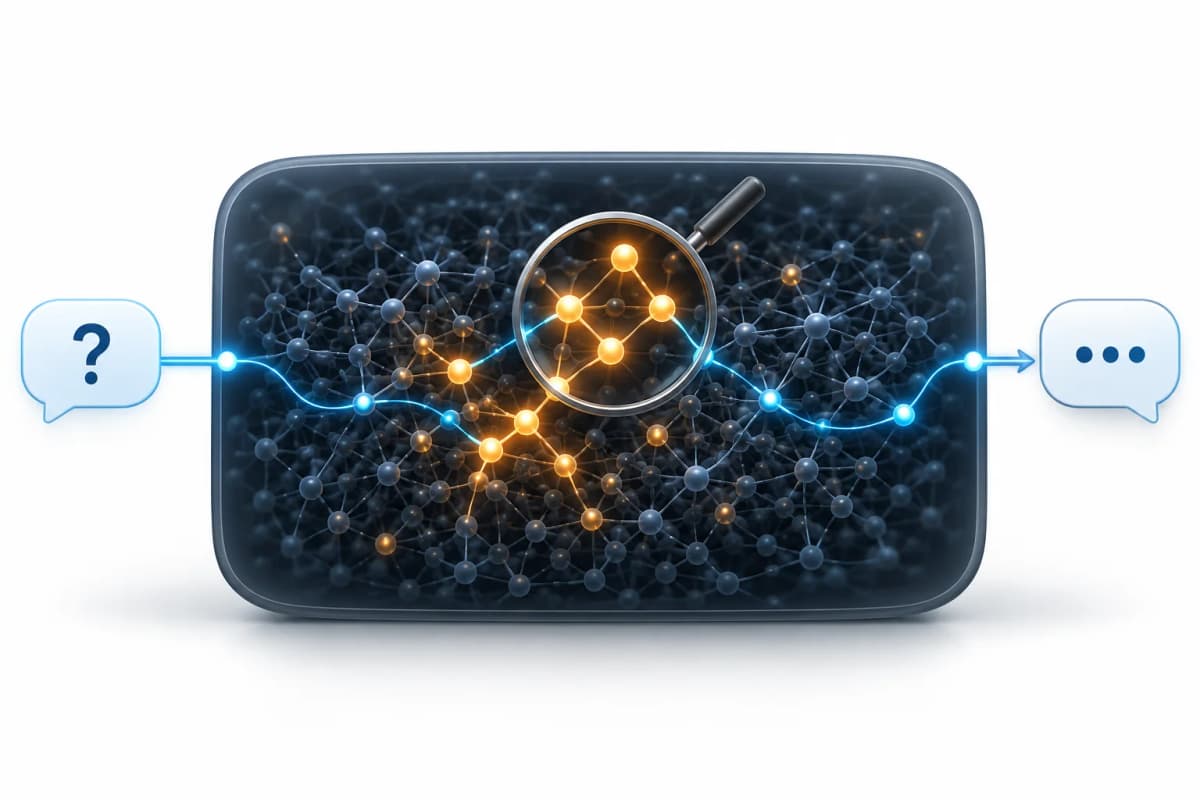
Що сталося: Goodfire дослідила невеликі частини мовної моделі, які називаються нейронами. У вибраних тестах дослідники могли описати функції деяких із них і змінити відповідь, видаливши їх.
Чому це важливо: Внутрішню роботу моделі може бути легше досліджувати, ніж очікували багато дослідників.
Чого це не означає: Ми ще не можемо пояснити кожну відповідь або назвати модель безпечною. Якщо ви створюєте продукти зі звичайними AI API, продовжуйте тестувати результати та обмежувати можливості AI. Подальші дослідження можуть привести до кращих інструментів для налагодження й моніторингу моделей.
Що це означає для AI-продуктів сьогодні?
Для агентських і контентних робочих процесів, які я створюю, цей результат не дає нам нового перемикача, який можна ввімкнути. Негайна робота полягає в тестуванні завдань, які насправді виконують користувачі, перевірці джерел і фактичних тверджень, журналюванні поведінки моделі та інструментів, обмеженні дозволів інструментів і вимозі людського схвалення перед важливими зовнішніми діями. Ці засоби контролю усувають спостережувані збої незалежно від того, чи є нейрони моделі зрозумілими.
Ви все одно можете оцінювати зовнішню поведінку розміщеної моделі. У моєму попередньому посібнику про калібрування впевненості LLM→ описано одне з таких завдань: перевірку того, чи відповідає оцінка правильності на вашій власній роботі. Це вимірює інше питання, ніж механістична інтерпретованість, і обидва підходи потребують чітких обмежень.
Перед впровадженням внутрішнього монітора я запитав би, яку поведінку він виявляє на відкладених даних, як часто пропускає шкідливі випадки або перериває нешкідливі, чи діє до виклику інструмента і чи справді постачальник надає необхідні активації. Звичайні результати API не відповідають на ці запитання.
Що може змінитися в довшій перспективі?
Якщо інші команди відтворять результати щодо нейронів і зможуть простежити важливі шляхи між нейронами, розробники моделей зможуть діагностувати збої на рівні механізмів, а не лише досліджувати результати. Каммарата також описує автоматизованих дослідницьких агентів і обережну зміну навчального середовища, яке доводить свою шкідливість, як можливі майбутні кроки. Це пропозиції для перевірки, а не можливості, встановлені цим есе.
Споріднений напрям уже має конкретний приклад. У окремому дослідженні Goodfire про Kimi K3 зонд активацій передає дані другій моделі, яка оцінює, чи потрібно перервати ризиковану взаємодію агента. Goodfire повідомляє про перспективні результати у власних оцінюваннях. Цьому монітору потрібен доступ до внутрішніх активацій, а дослідження не підтверджує пояснення нейронів Каммарати. Воно показує, що сигнали на рівні моделі можуть зрештою запропонувати постачальнику або розгортанню з відкритими вагами; клієнту API знадобився б доступний сервіс і власне оцінювання, специфічне для завдання.
Краща внутрішня видимість могла б допомогти перевіркам безпеки, а також пришвидшити розробку моделей. Баланс невідомий. Корисний майбутній стандарт мав би вимагати від постачальників показувати, яку поведінку охоплюють їхні внутрішні пояснення, де вони дають збій і чи покращує монітор перевірки лише за результатами в реалістичних робочих процесах.
За чим нам стежити далі?
Я звернув би увагу на п’ять видів доказів у майбутній технічній статті та подальших роботах:
Мій висновок такий: Goodfire переконливо обґрунтувала необхідність уважніше досліджувати власні нейрони моделі. Вона також надала дослідникам кращі експерименти для дискусії. Станом на 17 жовтня 2026 року найсильніший висновок є вужчим за твердження «чорну скриньку LLM розв’язано»: деякі частини можуть бути читабельнішими, ніж очікувалося, а шлях від читабельних частин до надійних пояснень усієї моделі залишається відкритим. Для команд, які створюють продукти на основі розміщених API, практичною відправною точкою й надалі залишаються тести поведінки та межі дозволів.
Основні джерела: дослідницьке есе Каммарати, відповідь Гао, пряма дискусія дослідників і окреме дослідження Goodfire моніторингу активацій.