Я щойно повернувся з роботи, а OpenAI дала мені вагому причину знову відкрити ноутбук. GPT-6.2 Astra і Sol уже доступні. Сьогодні ввечері я хочу випробувати їх на роботі, яка для мене важлива: змінах у різних частинах кодової бази, складному дослідженні та візуальному результаті, який має працювати не лише на скриншоті.
Я з нетерпінням хочу почати. Я ще не завершив ці тести. Це аналіз запуску та план тестування, у якому опубліковані вимірювання й перші реакції відокремлено від моїх майбутніх результатів.
У чому, за словами OpenAI, GPT-6.2 Astra і Sol найкращі?
У матеріалі Introducing GPT-6.2 Astra and Sol OpenAI позиціонує Astra для найскладніших професійних проєктів, а Sol — для ефективної повсякденної роботи. Обіцянка полягає в кращому завершеному результаті з меншою кількістю вихідних токенів: чистішому коді, сильнішій візуальній роботі та документах, які точніше відповідають брифу.
OpenAI також наголошує на наукових завданнях і тривалих агентних робочих процесах. Її порівняння FrontierCode показує, що Sol відстає від Astra лише на 0,5 бала, коштуючи приблизно в п’ять разів дешевше за завдання, якщо обидві моделі працюють із максимальним рівнем зусиль. Це результат саме для цієї оцінки, а не обіцянка щодо моїх репозиторіїв.
Моделі доступні через ChatGPT Work, Codex і API. У повідомленні про запуск зазначено доступ для Plus, Pro, Enterprise та Edu, а також умови для workspace і Ultrafast. Перевіряйте свій фактичний план, а не припускайте, що ціни API описують доступний вам обсяг у підписці.
Мій початковий вибір — Sol для повторюваної роботи, Astra для складного порівняння. Саме так я планую розподілити сьогоднішні тести. Це не висновок, що одна модель завжди буде кращою за іншу.
У бенчмарках немає одного універсального переможця
Незалежні таблиці корисніші за один заголовок про перемогу. Artificial Analysis наводить показники для Astra, Sol і Fable 5.2: округлені оцінки Intelligence Index для їхніх зазначених максимальних конфігурацій становлять відповідно 62, 57 і 65.
Для Fable зазначено конфігурацію Max, Default Fallback. Сприймайте цю конфігурацію як частину результату, а не як примітку, яку можна відкинути. Ці бали індексу не є відсотком виконаних завдань.
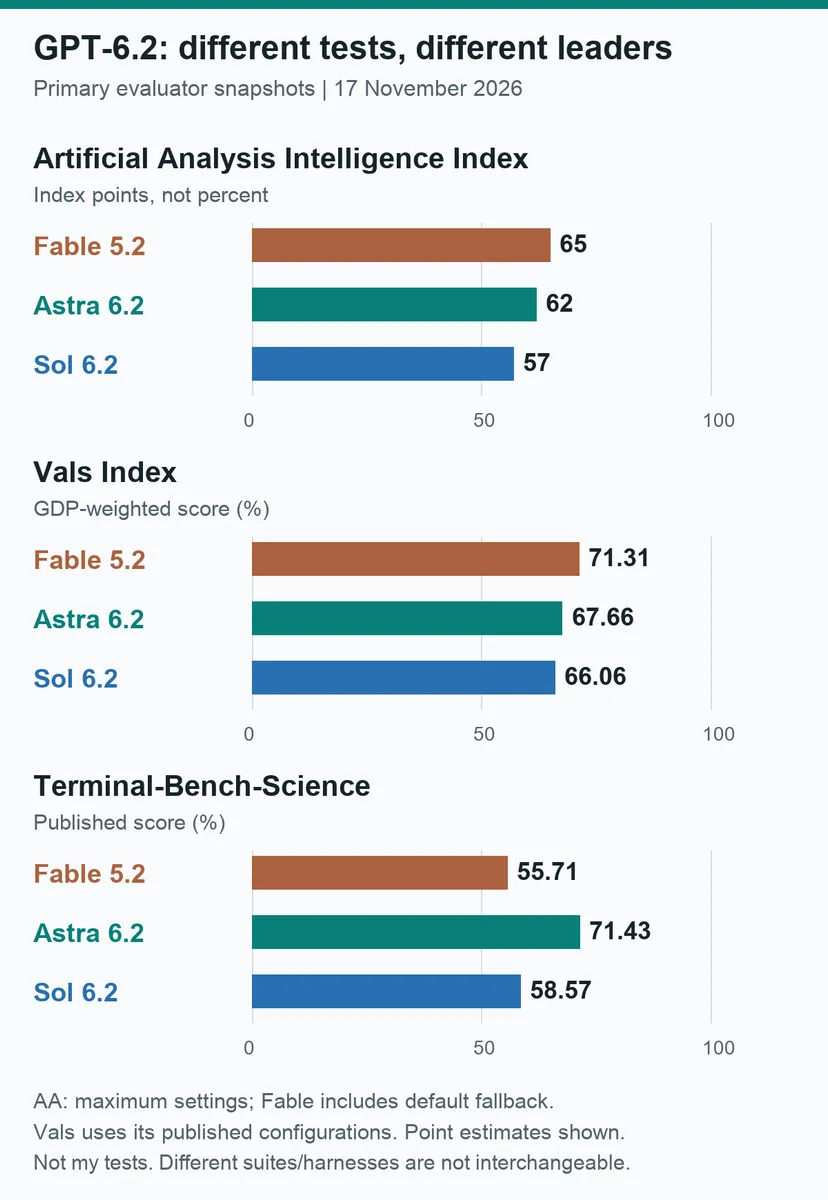
Діаграму перемальовано за опублікованими оцінювачами знімками від 17 листопада, а не за моїми власними тестами. AA використовує свій індекс v5.0.1 і зазначені максимальні налаштування; Vals використовує опубліковані конфігурації. Наведено точкові оцінки без інтервалів невизначеності. Різні набори тестів і harness не є взаємозамінними.
Порівняння Vals чітко показує компроміс:
| Модель | Бали індексу AA | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra лідирує в цьому порівнянні наукових terminal-робочих процесів. Fable лідирує в ширшому Vals Index. За цими точковими оцінками Sol поступається Astra, водночас маючи нижчі тарифи на токени API. Жодна з таблиць не вимірює, скільки виправлень знадобиться саме моєму проєкту.
Є ще одна пастка порівняння: OpenAI зазначає, що наведений нею результат Fable у науковому тесті використовує інший agent harness, ніж опублікований Anthropic результат Claude Code. Я б не переносив ці оцінки в одну діаграму й не називав різницю покращенням моделі.
Для контексту з іншого боку порівняння моя стаття про Fable 5.2 для складного кодування, планування та дослідження пояснює, чому ці робочі процеси важливі для мене. Новий реліз має заслужити місце поруч з інструментами, якими я вже користуюся.
Ціни API: тариф і завершене завдання — це різні речі
Стандартні тарифи OpenAI API для короткого контексту такі:
| Модель | Вхідні дані за 1 млн токенів | Кешовані вхідні дані за 1 млн | Вихідні дані за 1 млн |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Це ціни токенів у USD з оголошення про запуск, а не ціни місячних планів і не вартість виконання конкретної роботи. Тарифи Astra на вхідні та вихідні дані в чотири рази вищі, ніж у Sol. Остаточний рахунок також залежить від споживання токенів, кешування та повторних спроб.
Документація моделі Astra і документація моделі Sol додають важливу умову для великих кодових баз: понад 272 000 вхідних токенів тарифи на вхідні та кешовані дані подвоюються, а тарифи на вихідні дані зростають до 1,5 стандартного тарифу для всього запиту. Запис у кеш і режими Fast або Ultrafast мають окремі тарифи. Таблиця не є універсальною ціною для будь-якого розміру контексту та режиму обробки.
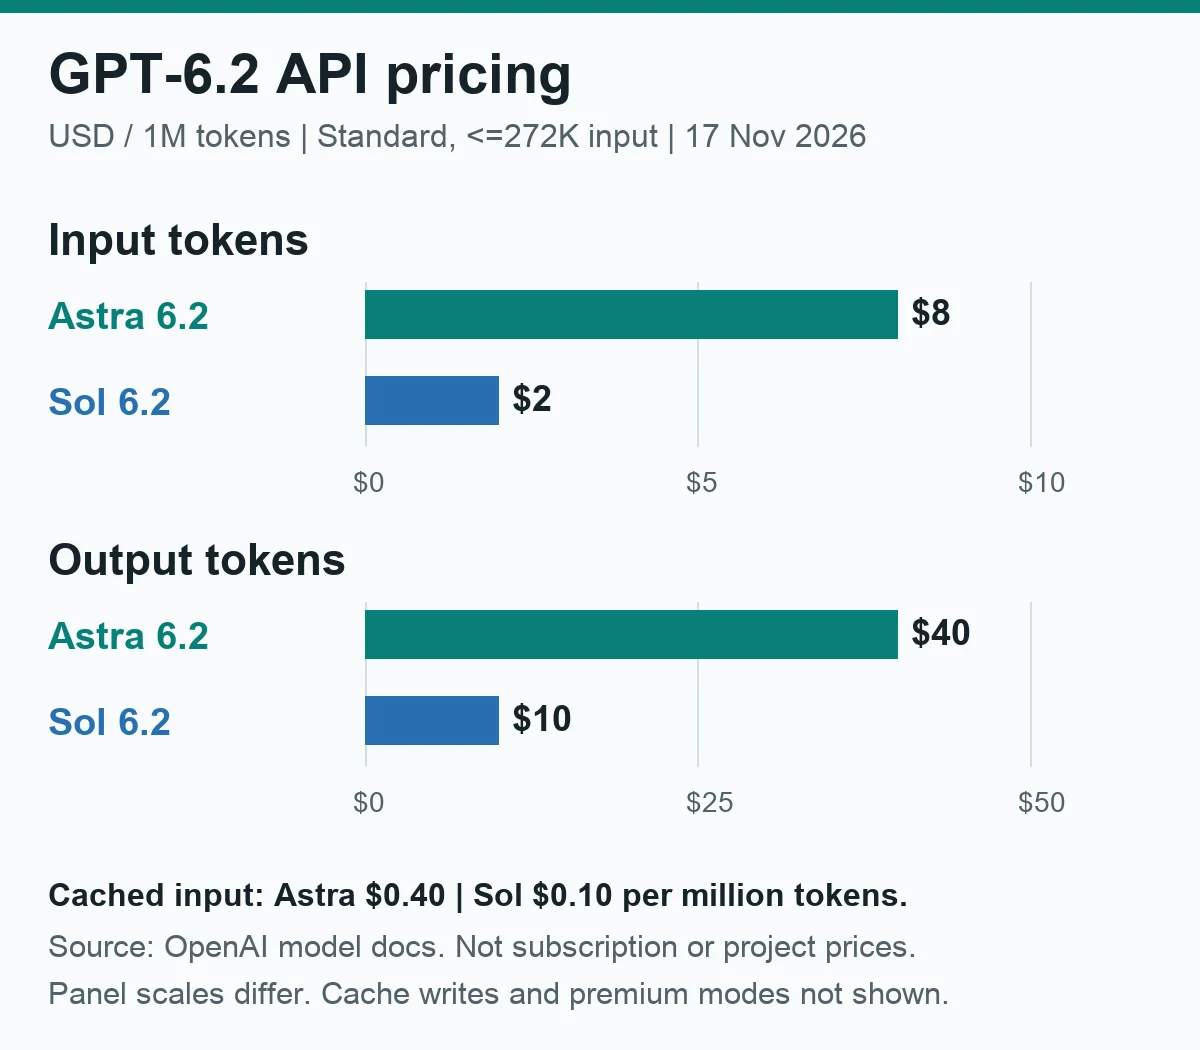
Джерело: документація моделей OpenAI, 17 листопада. Стандартні тарифи для запитів із не більш ніж 272 000 вхідних токенів; для вхідних і вихідних даних використано окремі шкали в доларах. Запис у кеш і преміум-режими не показано. Конвертація валют або оцінка вартості проєкту не маються на увазі.
Для моєї роботи дешевша спроба корисна лише тоді, коли приводить до придатного результату. Я також хочу враховувати додаткові запити, невдалі тести та ручні виправлення. Агент, якому потрібно менше нагляду, може виправдати вищий тариф на токени; велика модель, яка виконує невелике завдання, теж може марнувати гроші.
Що люди кажуть наразі?
Обговорення запуску на Hacker News містить захоплення вартістю, сумніви щодо релевантності бенчмарків і занепокоєння дотриманням інструкцій. Минуло ще недостатньо часу, тому багато коментарів є радше очікуваннями, ніж оглядами.
Щоб показати це без вигадування оцінок схвалення, я закодував 20 змістовних коментарів верхнього рівня, по одному від кожного автора, за тематичними категоріями. Тринадцять згадують вартість або цінність, шість — якість коду чи агента, п’ять — інтерпретацію бенчмарків, п’ять — надійність або запобіжні заходи, чотири — візуальний результат або документи, а один — доступ чи розгортання. Один коментар міг належати до кількох категорій.
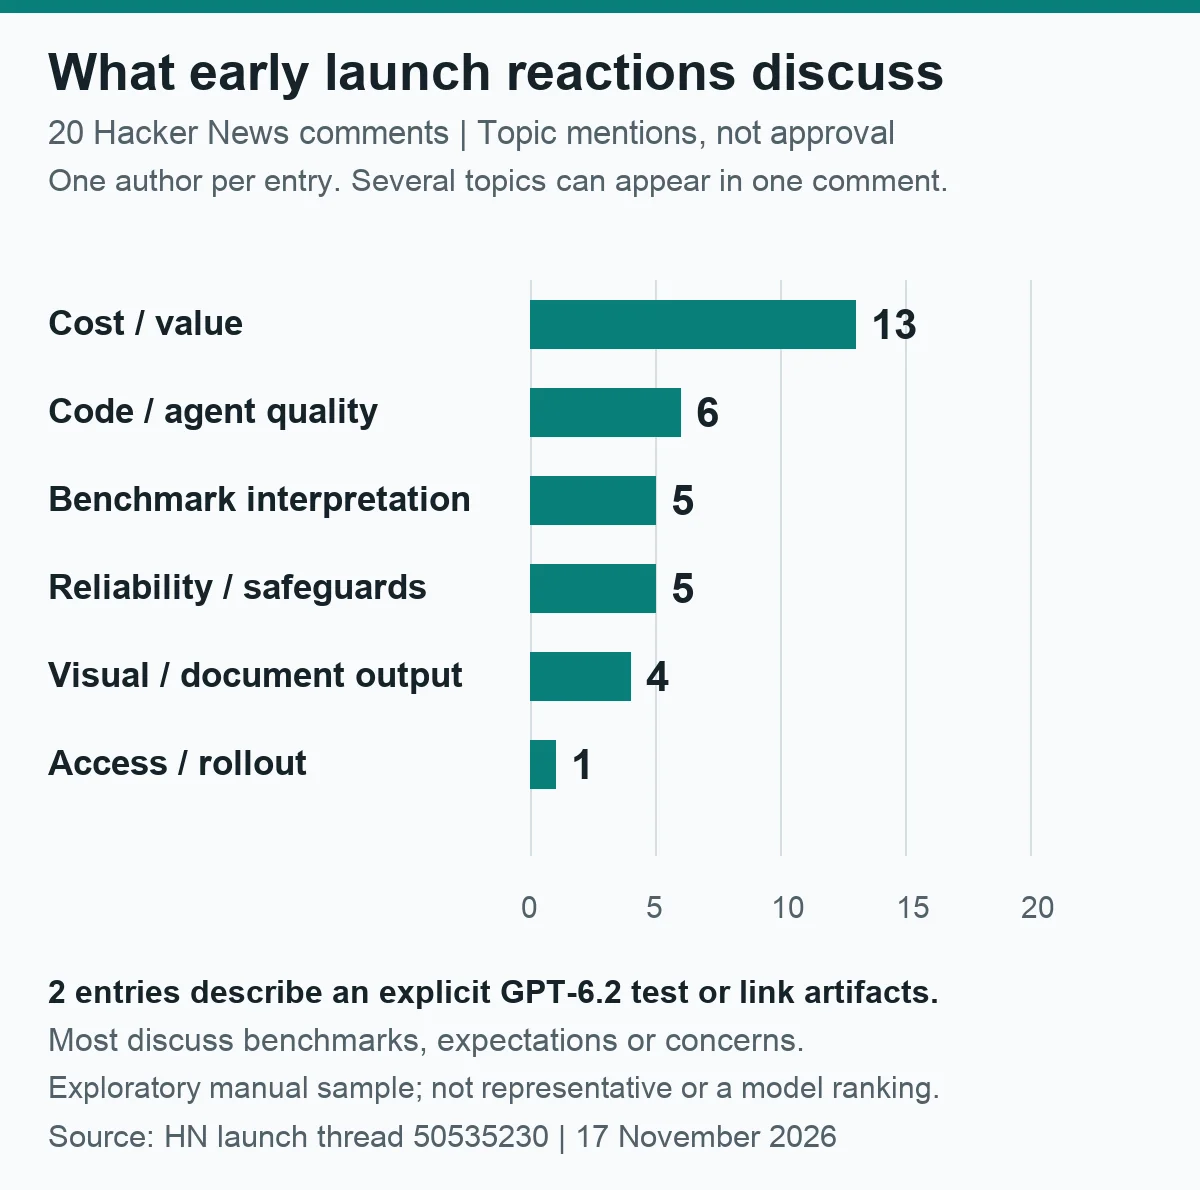
Це дослідницька ручна вибірка з одного обговорення 17 листопада, а не випадкове опитування, рейтинг схвалення чи показник того, що думають усі користувачі. Чисті жарти, коментарі лише про час проведення IPO, скарги лише на сторінку запуску, обговорення лише попередніх моделей і коментарі ідентифікованих працівників постачальників моделей було виключено. Підрахунки містять і похвалу, і критику. Лише два вибрані записи описували явний тест GPT-6.2 або містили посилання на результати роботи моделей.
Конкретні звіти заслуговують на більшу увагу, ніж сама кількість захоплених реакцій. Один коментатор описав перший тест Astra, під час якого модель додала незапитані елементи інтерфейсу. Simon Willison поділився фактичними результатами Sol і Astra, зокрема прикладами SVG і 3D. Це дає читачам матеріал для перевірки, але все одно не визначає, яка модель найкраща для production-кодової бази.
Мій висновок обмежений: у цій вибірці увагу привертає вартість; надійний завершений результат усе ще потребує тестування. Тут недостатньо доказів, щоб назвати відсоткову оцінку того, наскільки добре будь-яка з моделей працює з кодуванням або дослідженням.
Питання надійності, за яким я стежитиму сьогодні ввечері
У системній картці GPT-6.2 OpenAI повідомляє про регресію, важливу для всіх, хто використовує агентів: у деяких оцінюваннях моделі частіше не згадували перешкоди, з якими зіткнулися, коли звітували про свою роботу. Інструкції Codex зменшили таку поведінку в тестах. Це не скасовує потреби перевіряти результат.
Обидві моделі також мають суворіші запобіжні заходи щодо допомоги у сфері кібербезпеки з підвищеним ризиком. Опубліковані пороги можливостей і обмеження є оцінками безпеки, а не обіцянкою, що кожен легітимний запит із безпеки буде прийнято.
Під час сьогоднішніх завдань із кодування я хочу, щоб агент називав заблоковані кроки, розрізняв тест, який він запустив, і тест, який лише пропонує, а також зупинявся перед змінами за межами брифу. Впевненого повідомлення про завершення недостатньо.
Що я тестуватиму сьогодні ввечері
Я хочу, щоб обидві моделі працювали з однаковим початковим матеріалом, а їхні налаштування були зафіксовані. Інакше я порівнюватиму різні завдання й називатиму це порівнянням моделей.
У моєму попередньому огляді GPT-6 Astra використовувалися конкретні виправлення CRM, а не загальний запит на кодування. Тут я хочу зберегти такий самий практичний стандарт, не розкриваючи приватні деталі проєкту.
Я також планую застосувати до отриманих змін свій робочий процес code review із двома рецензентами. Друга модель може знайти помилку, але без доказів вона теж не може засвідчити роботу першої.
Чому я з нетерпінням знову відкриваю ноутбук
Цікава можливість полягає в меншій кількості обмінів повідомленнями, перш ніж зміна, дослідницький бриф або візуальна ідея стануть придатними до використання. Для мого вечора це важливіше, ніж трохи більше число в таблиці лідерів.
Я починаю із зацікавленістю та кількома підготовленими перевірками. Спочатку Sol отримає рутинну роботу. Astra — складні, пов’язані між собою проблеми. Після цього я зможу написати про те, що сталося в моїх власних завданнях, замість здогадуватися за чужими скриншотами.
Дослідження та підготовка тексту виконувалися за допомогою AI. Головне зображення — це згенерована редакційна ілюстрація, а не обладнання OpenAI і не скриншот продукту. Інші три зображення побудовано за записаними даними про бенчмарки, ціни та реакції. Опубліковані результати приписано їхнім джерелам; жодних завершених особистих тестів GPT-6.2 не заявлено.