Я провів значно менше часу з моделями Google, ніж з іншими AI-інструментами у своєму робочому процесі. Gemini 4 Argon дає мені причину це змінити. Результати автоматизації бізнесу виглядають корисними, а оголошена початкова ціна відповідає рівню GPT-6.1 Sol, а не моделі, доступній лише за преміальною ціною.
Я хочу протестувати її, коли доступ буде відкрито. А поки це огляд опублікованих даних, цін і перших реакцій, а не практичний огляд Argon.
Перевірка джерел: 1 жовтня 2026 року. Обкладинка — редакційна ілюстрація, створена за допомогою AI. Наведені нижче графіки відтворюють числові результати з цитованих джерел; це не скриншоти моїх власних тестів.
Що таке Gemini 4 Argon і чи можу я вже ним користуватися?
Google оголосила Argon 30 вересня 2026 року, спочатку — для перевірених фахівців із кіберзахисту через Fairwind. Ширший доступ розпочнеться для платних клієнтів API та підписників Google AI Ultra; в оголошенні немає точної дати загального публічного релізу. Дивіться оголошення Google про Gemini 4 Argon.
Я б дочекався фактичного доступу до облікового запису, перш ніж купувати підписку спеціально заради Argon. Оголошений запуск — це не те саме, що модель, яку я можу вибрати вже сьогодні, а Google у цьому оголошенні не пообіцяла дату доступності у Швеції.
Найвагоміша причина звернути увагу — можливість виконувати довші завдання з меншим втручанням. Мій корисний тест включатиме наявний код, складні бізнес-правила та докази того, що фінальний результат працює. Самої відшліфованої відповіді буде недостатньо.
Ціни Gemini 4 Argon: у початкової ставки є нюанс
Google оголошує ціну $2 за вхідні та $10 за вихідні токени на мільйон токенів. У примітці до цін указано подальшу ставку $4/$20, але не названо дату завершення початкового періоду. Кешовані вхідні дані отримують знижку 95%, що за розрахунком дає початкову ставку $0.10.
| Модель або період ціноутворення | Вхідні / 1 млн токенів | Вихідні / 1 млн токенів |
|---|---|---|
| Gemini 4 Argon, початкова ціна | $2 | $10 |
| Gemini 4 Argon, після початкового періоду | $4 | $20 |
| GPT-6.1 Sol, Standard | $2 | $10 |
| Claude Opus 5.5, Standard | $4 | $20 |
| GPT-6 Astra, Standard | $10 | $50 |
Джерела: оголошення Google і розширена примітка до цін, ціни моделі GPT-6.1 Sol, ціни моделі GPT-6 Astra і ціни Claude Platform.
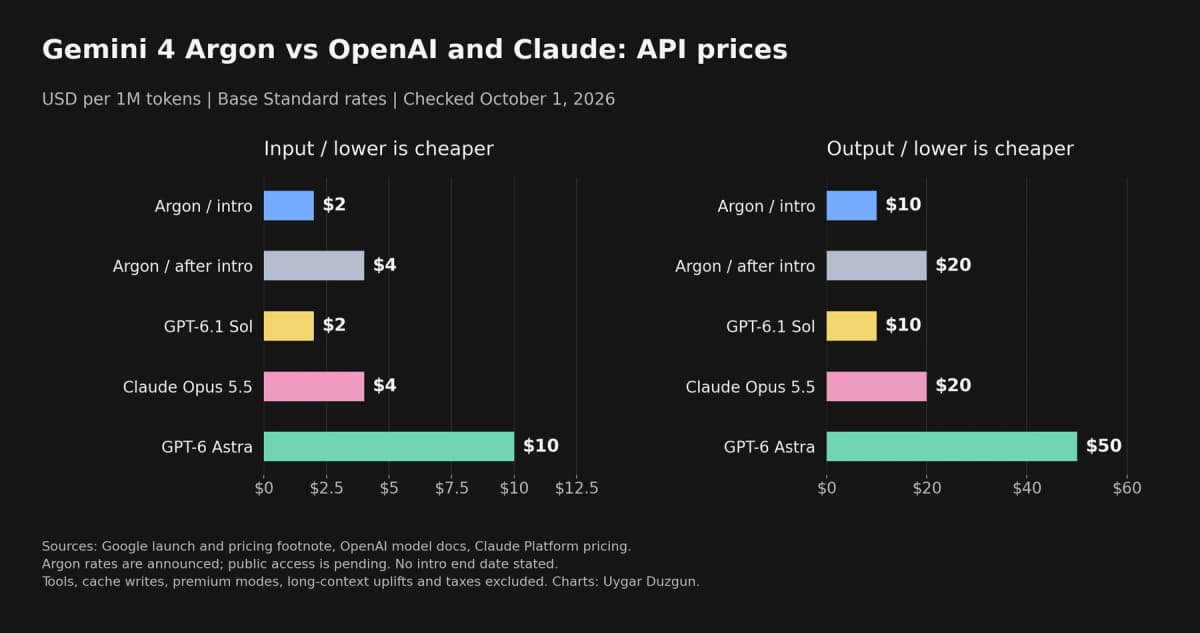
Базові ціни в USD перевірено 1 жовтня. Ціни Argon — це оголошені ставки, а не доказ загальної доступності API. Порівняння не враховує інструменти, запис кешу, преміальні режими, регіональні збори та податки.
Для простого прикладу бюджету: один мільйон некешованих вхідних токенів і 100 000 вихідних токенів у кількох запитах із коротким контекстом коштували б $3 за початковими ставками Argon, $6 після завершення початкового періоду, $3 із Sol, $6 з Opus і $15 з Astra. Це арифметика для фіксованого співвідношення токенів, а не вимірювання реального робочого навантаження. Те саме завдання може споживати різну кількість токенів у різних моделей.
OpenAI також підвищує ціни на повний запит, якщо в одному запиті понад 272 000 вхідних токенів; Anthropic указує стандартні ціни для всього контекстного вікна Opus 5.5. Тому таблиця базових цін не може показати, скільки коштуватиме робота з величезним репозиторієм. У моєму порівнянні GPT-6.1 Sol і Opus 5.5 розглянуто ці компроміси.
Я б планував інтеграцію, використовуючи подальшу ставку Argon, а промоційну ціну розглядав би як тимчасову економію. Це не дозволить будувати бізнес-обґрунтування на знижці, дату завершення якої я поки не можу визначити.
Бенчмарки Gemini 4 Argon: сильна автоматизація, неоднозначні результати в програмуванні
Автоматизація бізнесу — це результат, який мене найбільше цікавить
AutomationBench 1.0.6 від Zapier перевіряє наскрізну роботу з 47 інструментами у шести бізнес-функціях. Він перевіряє отримане середовище за допомогою детермінованих тверджень, а не оцінює переконливість фінального повідомлення агента.
Наведені нижче вибрані конфігурації зберігають свої налаштування рівня зусиль і поведінку резервного перемикання.
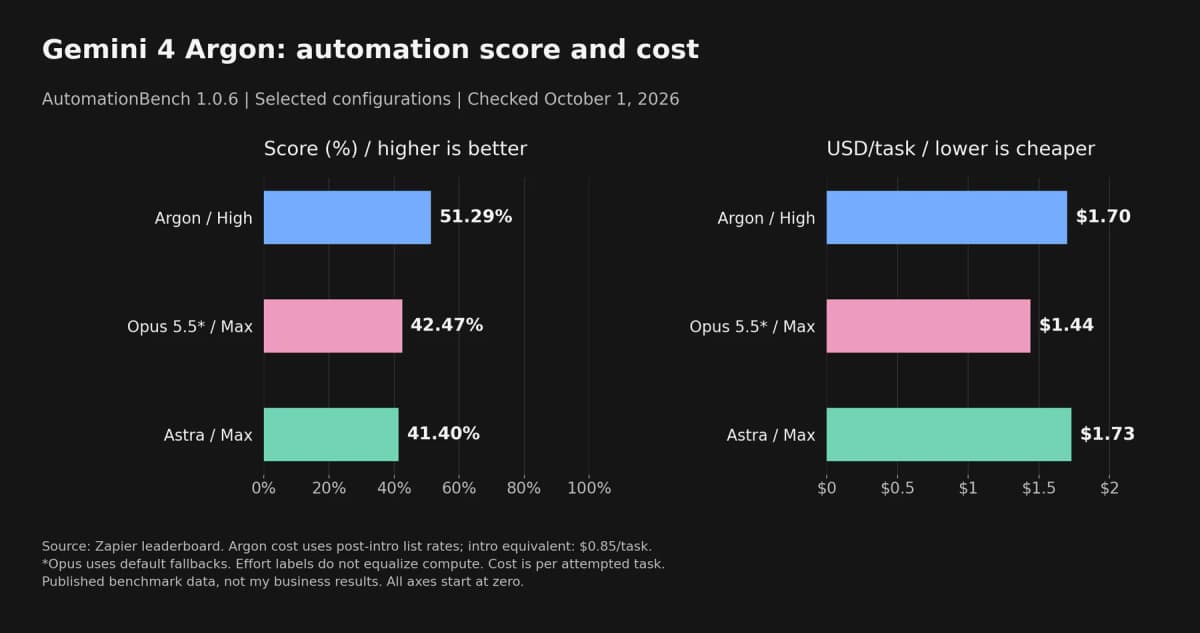
Zapier повідомляє, що Argon High набирає 51.29% і коштує $1.70 за спробу виконання завдання за подальшими цінами; його еквівалент за початковою ціною становить $0.85. Opus 5.5 Max зі стандартним резервним перемиканням набирає 42.47% за ціною $1.44, а Astra Max — 41.40% за $1.73. Позначення рівня зусиль не відповідають однаковим обчислювальним бюджетам у різних постачальників.
У цьому порівнянні Argon має вищий результат, але його звичайна вартість виконання завдання не є найнижчою. Також результат близько 51% у бенчмарку не виправдовує неконтрольований доступ до робочого середовища. Я все одно хочу мати підтвердження перед важливими діями, журнали, які можна перевірити, і спосіб відновлення після часткового виконання.
Ця відмінність важлива для автоматизації бізнесу. Мене цікавить, чи оновлено правильний запис і чи отримав повідомлення правильний адресат. Повідомлення агента про завершення роботи не може замінити ці перевірки.
Результати програмування залежать від завдання
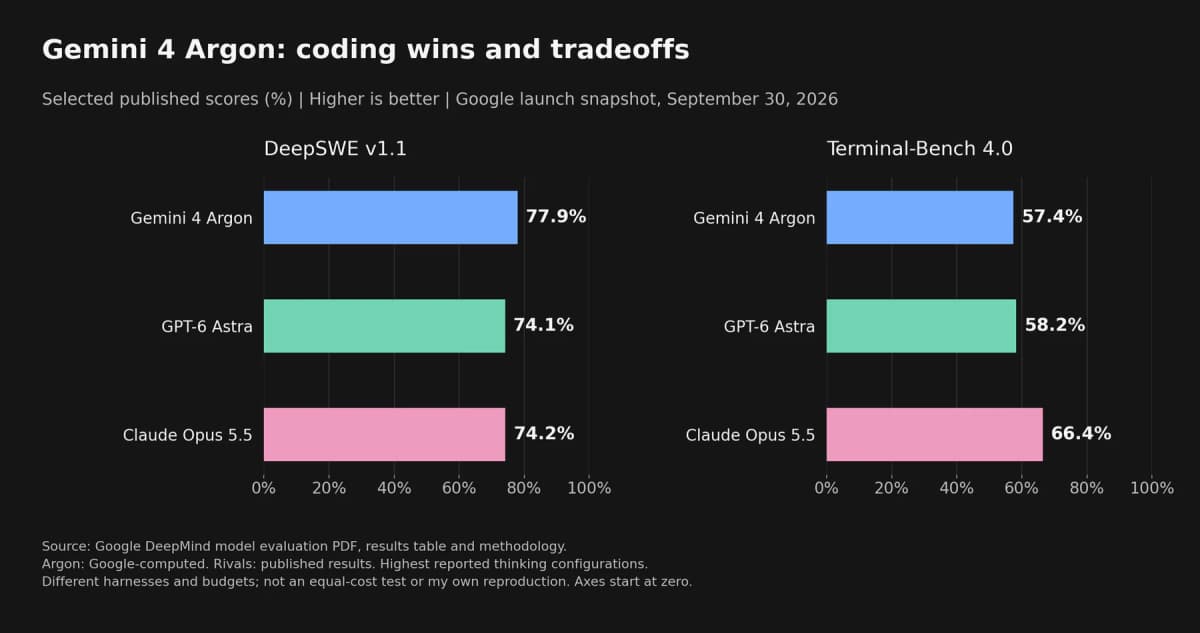
Вибрані результати з звіту Google DeepMind про оцінювання моделі. Тут поєднано результати Argon, обчислені Google, з опублікованими результатами конкурентів, а не наведено однорідний незалежний очний тест.
Argon досягає 77.9% у DeepSWE v1.1 проти 74.1% у Astra та 74.2% у Opus. У Terminal-Bench 4.0 Opus очолює цю трійку з результатом 66.4%, за ним ідуть Astra з 58.2% та Argon із 57.4%. У звіті також зазначено перевагу Astra у FrontierSWE v2: 65.5% проти 55.0% у Argon.
Google зазвичай повідомляє результати за найвищих налаштувань міркування та максимальні або найкращі доступні результати конкурентів. Важливі тестові оболонки й бюджети. Перевага в одному бенчмарку репозиторію не гарантує кращого виправлення в моїй кодовій базі, особливо коли різниця становить лише кілька відсоткових пунктів.
Я б окремо протестував обмежене виправлення регресії та зміну в кількох файлах. Обидва завдання потребують поведінкових перевірок і перегляду diff. Модель може пройти тест, водночас додавши абстракцію, яку я не хочу підтримувати.
Незалежні дані про інтелектуальну роботу додають контекст
Vals Index 2.1, оновлений 30 вересня, указує для Argon результат 68.90%, для Opus 5.5 — 66.97%, для Astra — 63.13%, а для Sol 6.1 — 61.15%. Vals поєднує завдання з фінансів, програмування, права й оподаткування, використовуючи галузеві ваги на основі ВВП США.
Його стовпчик вартості ускладнює рейтинг: $15.68 за тест для Argon за тарифами токенів $4/$20 проти $3.24 для Sol. Це витрати, специфічні для бенчмарку, а не розцінки для моєї роботи. Вони показують, чому я залишив би дешевшу модель у тестуванні, навіть якщо інша модель очолює стовпчик результатів.
Я б розподіляв завдання після їх вимірювання. Просту регулярну роботу та дорогі помилки не слід автоматично доручати одній і тій самій моделі.
Що інші люди говорять про Argon?
У ранньому обговоренні релізу Gemini 4 Argon є захоплення, розчарування через обмежений доступ і нагадування про подальше підвищення ціни. Це реакції окремих користувачів на запуск, а не репрезентативне опитування чи доказ того, що всі вони випробували Argon. Коментарі про очікування протягом тижнів або місяців є припущеннями.
Для мене корисніша дискусія відбувається в обговоренні міграцій кодових баз Google у спільноті Rust. Один із коментаторів, nicoburns, стверджує, що переклад між мовами може працювати краще, оскільки початковий дизайн уже існує. Інші описують проблеми з підтримуваністю та зусилля, яких вони докладають для виправлення згенерованого коду.
Ця дискусія стосується інженерії з широким використанням агентів. Вона не встановлює реальну надійність Argon. Я серйозно сприймаю практичний висновок: порівнювати поведінку з оригіналом, зберігати зміни придатними для перевірки та вимірювати обсяг людської роботи, що залишається після цього.
Як я планую тестувати Gemini 4 Argon
Мені достатньо цікаво, щоб дати Google належний шанс. Я почну із завдань, які можу перевірити, а не проситиму модель одразу взяти на себе все.
Я хочу записувати час виконання, вартість токенів, повторні спроби, правильність і зусилля на перевірку. Питання в тому, чи зменшує Argon мою загальну роботу, включно з перевіркою та виправленням результату.
Оголошення Google також підвищує ліміт вихідних даних до одного мільйона токенів. Це верхня межа, а не ціль. Я все одно встановлював би бюджети й умови зупинки; додаткові доступні можливості міркування мають виправдовувати свою вартість. У моїй статті про токени міркування AI та обчислювальні витрати пояснюється, чому для мене важливий цей компроміс.
Gemini 4 Argon варто протестувати. Я ще недостатньо користувався продуктами Google, щоб справедливо визначити їм місце у своєму робочому процесі. Ці результати змушують мене захотіти змінити це, коли я отримаю доступ до моделі, водночас зберігаючи Sol, Opus і Astra як реальні альтернативи, доки власні тести не дадуть мені більше інформації.