Я використовую Claude Haiku 5.5 для перекладів, швидких змін тексту, виправлень і нескладної роботи з деплоєм. Для таких завдань потрібна модель, яка дотримується вузького технічного завдання й завершує роботу, не перетворюючи невелике редагування на окремий проєкт.
Налаштування зусиль має значення, оскільки ці завдання не однаково складні. Виправлення друкарської помилки та переклад сторінки з технічною термінологією потребують різних початкових налаштувань.
Це частина 1 серії AI Models in Practice про вибір моделей для реальної роботи. Наведені нижче приклади — це багаторазово використовувані промпти та запропоновані налаштування. Я не проводив контрольованого порівняння кожного рівня зусиль, а приклади перекладів є редакторськими прикладами, а не записаними результатами Haiku. Дані про модель і ціни перевірено за документацією Anthropic 12 жовтня 2026 року.
Зміст
Що таке Claude Haiku 5.5?
Claude Haiku 5.5 — це варіант малої моделі від Anthropic для високочастотної роботи, чутливої до часу виконання. Anthropic випустила її 7 жовтня 2026 року й позиціонує для створення резюме, класифікації, вилучення даних, маршрутизації та обмежених завдань субагентів. ID моделі Claude API — claude-haiku-5-5. Див. анонс запуску Claude Haiku 5.5.
В огляді моделі Haiku 5.5 зазначено підтримку текстового та графічного введення, текстового виведення, контекстного вікна на один мільйон токенів і до 128 000 вихідних токенів у Messages API. За замовчуванням модель використовує адаптивне мислення. Велике контекстне вікно описує місткість, але не доводить, що надсилати весь репозиторій корисно чи економно.
Я спочатку надав би Haiku готовий абзац, глосарій і точне завдання з редагування, перш ніж просити її інтерпретувати весь бізнес. Вужче технічне завдання спрощує перевірку результату.
Для чого добре підходить Haiku 5.5?
Мій практичний список починається з роботи, для якої я вже її використовую:
Серед інших завдань, які варто оцінити, — вилучення полів із наданого документа, сортування повідомлень за відомими категоріями та створення резюме короткої розмови зі службою підтримки. Це запропоновані варіанти використання, а не результати мого власного бенчмарку.
Для широкої інженерної роботи вибір моделі потребує додаткового розгляду. У матеріалах про запуск Anthropic рекомендує Sonnet 5.5 і Opus 5.5 для складнішого агентного програмування. Підвищення рівня зусиль Haiku не гарантує таких самих можливостей, як у більшої моделі.
Що означають п’ять рівнів зусиль?
Haiku 5.5 підтримує low, medium, high, xhigh і max. Значення за замовчуванням — medium. Рівень зусиль визначає, скільки роботи модель витрачає на відповідь; це не фіксований бюджет токенів і не гарантія точності. Він впливає на мислення, текст відповіді та виклики інструментів. Див. документацію Anthropic про зусилля.
| Рівень зусиль | Офіційна початкова рекомендація | Моє запропоноване використання |
|---|---|---|
low | Короткі, прості завдання, чутливі до затримки | Виправлення друкарської помилки або короткий однозначний переклад |
medium | Значення за замовчуванням для більшості завдань, зокрема обмеженого програмування | Звичайний переклад або невелике редагування тексту з обмеженнями |
high | Робота зі знаннями, довші агентні завдання, суворе дотримання інструкцій | Неоднозначна термінологія або редагування, яке має відповідати кільком правилам |
xhigh | Використовуйте, коли оцінювання демонструє приріст якості | Експеримент зі складним обмеженим завданням; порівняйте із Sonnet |
max | Використовуйте, коли оцінювання виправдовує додаткові витрати | Винятковий тестовий випадок після перевірки нижчих рівнів |
Моє початкове правило: починайте з medium, а потім коригуйте налаштування на основі помилок, які бачите. Для тривіального виправлення спробуйте low. Для перекладу, чутливого до глосарія, порівняйте medium із high. Залишайте промпт і вхідні дані незмінними, щоб зрозуміти, чи допомогло налаштування.
Деплой може складатися лише з однієї команди й водночас мати значні наслідки. Вимоги до перевірки та затвердження я визначав би незалежно від рівня зусиль.
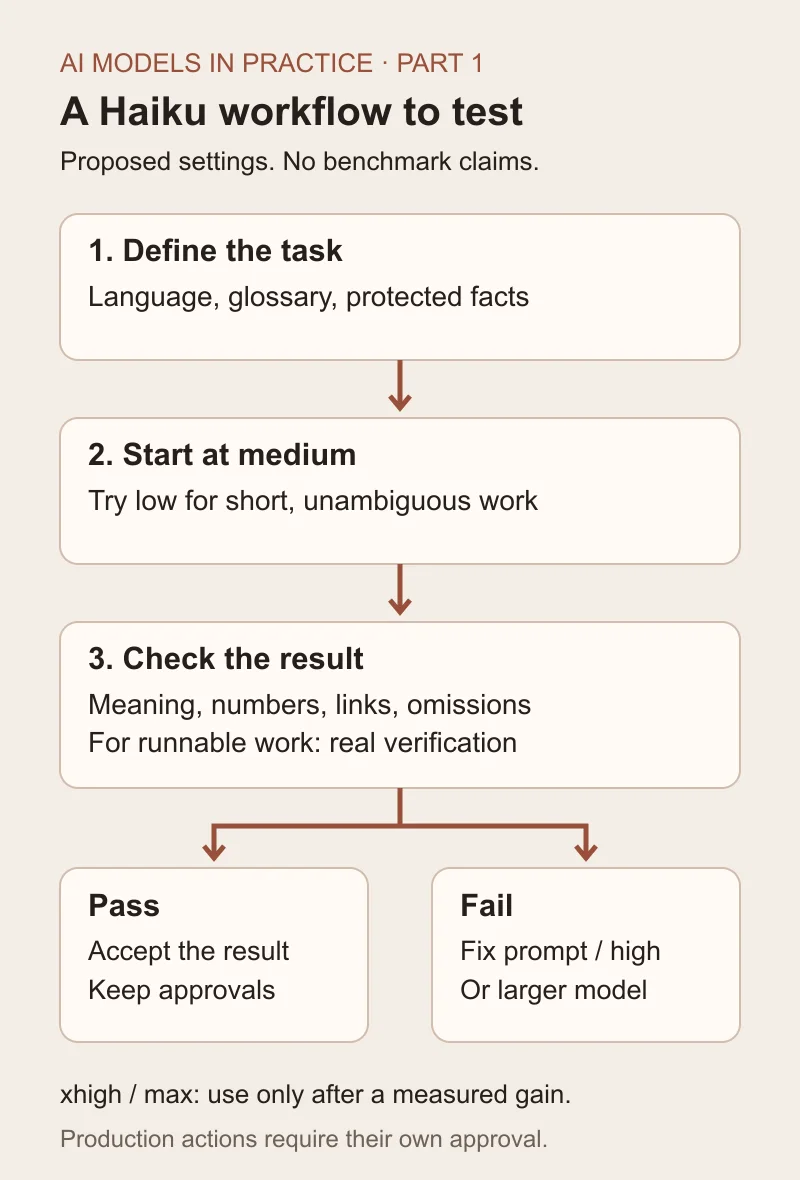
Запропонований робочий процес, а не доказ бенчмарку. Прийняття означає, що результат пройшов перевірки для цього завдання; публікація та дії у production зберігають окремі етапи затвердження.
Як я налаштовував би рівень зусиль для перекладів
Переклад — найочевидніший приклад того, чому одне значення за замовчуванням не може охопити все. Ці налаштування є початковими гіпотезами для оцінювання, а не виміряними переможцями.
Low для короткого буквального тексту
Коротке повідомлення про статус має мало неоднозначностей:
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
Прийнятний редакторський орієнтир: “Your order 1842 was dispatched on 12 October 2026.” Важливі перевірки — номер замовлення, дата та значення. Кілька варіантів англійською можуть бути прийнятними.
Тут я спробував би low, а потім підвищив рівень, якщо модель пропустить деталь. Додавання додаткових міркувань до цього промпту має бути виправдане кращим результатом.
Medium для звичайного тексту вебсайту
Для абзацу я почав би з medium і вказав аудиторію, локаль, тон і захищені терміни:
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
Редакторський орієнтир може бути таким: “We normally update the page within two working days. It may take longer if we need additional information.” Версія, яка обіцяє оновлення протягом двох днів, змінює твердження.
У посібнику Anthropic щодо багатомовної підтримки рекомендується вказувати вихідну й цільову мови та враховувати регіональний контекст. Опублікована таблиця мов охоплює старіші моделі, зокрема Haiku 4.5; вона не є доказом точності перекладу Haiku 5.5.
High, коли потрібно врахувати термінологію або неоднозначність
Деякі терміни залежать від бізнес-контексту. Шведське слово “reklamation” не слід автоматично перекладати як “advertising”. Відповідний англійський варіант може передавати скаргу або претензію щодо несправного товару — залежно від речення.
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
Для такого типу завдання я порівняв би medium і high. Критерій успіху — збереження умови в перекладі та використання потрібної термінології. Самої природності формулювань недостатньо.
Для структурованого контенту я надсилав би рядки для перекладу зі стабільними ідентифікаторами. Моя програма перевіряла б, що кожен ідентифікатор повертається один раз, а захищені значення зберігаються. Прохання до моделі зберегти великий JSON-файл не замінює парсинг і валідацію.
Швидкі зміни тексту та виправлення
Промпт для виправлення має визначати дозволені зміни. Інакше прохання виправити граматику може перетворитися на переписування.
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
Редакторський орієнтир: “We have updated the page, but the payment tests are not finished yet.” Версія, яка стверджує, що сторінку повністю протестовано, не відповідає технічному завданню.
Для такого речення low — розумний рівень для оцінювання. Для кількох абзаців, захищених посилань або кількох обмежень я пропоную починати з medium.
Для зміни тексту просіть конкретний результат: “Скороти це до 80 слів, збережи два обмеження та залиш посилання.” Кількість слів і збереження посилання можна перевірити незалежно від моделі.
Нескладна робота з деплоєм: визначте, що означає «готово»
Я зараховую просту роботу з деплоєм до способів використання Haiku, але слово “проста” потребує чітко визначених меж. Відома процедура деплою для затвердженої зміни тексту — це інше завдання, ніж діагностика зламаного релізу або рішення про міграцію бази даних.
Багаторазово використовувана інструкція може виглядати так:
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
Для підготовки та перевірок я почав би з medium. Якщо робота потребує дослідження збоїв у різних системах, я переглянув би вибір моделі та рівня зусиль, а не називав би це нескладним завданням.
У посібнику Anthropic зі створення промптів для Haiku зазначено, що агенти з низьким рівнем зусиль і довгими промптами можуть завершувати роботу зарано або пропускати перевірки. У ньому рекомендуються чіткі інструкції щодо перевірки. Також у посібнику зазначено, що в багатокрокових розмовах на xhigh іноді трапляються порожні видимі відповіді, а коли мислення вимкнено разом зі структурованим виведенням, можуть виникати проблеми з викликами інструментів. Інтеграція має виявляти неповні результати, а не мовчки їх приймати.
Як змінити рівень зусиль у Claude або API?
У Claude app відкрийте меню моделі поруч із кнопкою надсилання, виберіть Haiku 5.5, а потім Effort. Доступні варіанти можуть залежати від налаштувань облікового запису або адміністратора. Anthropic зазначає, що в Claude app мислення не можна вимкнути для Haiku 5.5. Див. Як змінити налаштування моделі, зусиль і мислення.
API надає пряміший контроль. Мінімальне тіло запиту має такий вигляд:
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
Це ілюстративна форма запиту, а не запит, який я виконував. Передайте абзац у повідомленні користувача. max_tokens — це обмеження, а не резерв і не інструкція створювати довгу відповідь.
У посібнику з міграції Haiku 5.5 від Anthropic пояснюється, що мислення використовує цей бюджет виведення, тому малий ліміт може обрізати відповідь до появи видимого тексту. Вибирайте блоки відповіді за їхнім type, а не припускайте, що перший блок містить відповідь.
Для нових запитів API не вказуйте temperature, top_p і top_k. Замініть стару конфігурацію з увімкненим мисленням і budget_tokens на адаптивне мислення. API дозволяє вимкнути мислення на рівнях low, medium і high; для xhigh і max потрібне адаптивне мислення. У посібнику також перелічено відмінності між провайдерами, тому перед міграцією перевірте фактичну платформу.
Зберігайте API key на сервері. Поле зусиль є конфігурацією, а не причиною розміщувати облікові дані у frontend-коді.
Скільки коштує Haiku 5.5?
У документації Anthropic щодо цін API наведено такі стандартні тарифи в USD за мільйон токенів, перевірені 12 жовтня 2026 року:
| Довжина промпту | Введення | Виведення | Читання кешу |
|---|---|---|---|
| До 100 000 токенів | $0.10 | $0.50 | $0.01 |
| Понад 100 000 токенів | $0.50 | $2.50 | $0.05 |
Вищий тариф застосовується до запиту, зокрема до введення, врахованого як читання або запис кешу. Це ціни на токени API; підписка Claude є окремим продуктом. Запис кешу, серверні інструменти та модифікатори платформи можуть додавати витрати.
Для ілюстративного запиту без кешування з 2 000 вхідних токенів і 1 000 загальних оплачуваних вихідних токенів:
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
Цей розрахунок не враховує додаткові платежі й не є виміряною вартістю перекладу. Мислення враховується в оплачуваному виведенні. Вищий рівень зусиль може змінити використання токенів, тому сама таблиця цін не може передбачити вартість завершеного завдання.
Найкращі практики, яких я дотримувався б для всіх цих завдань
Давайте моделі найменше повне завдання. Додавайте потрібний їй глосарій або затверджений вихідний текст і уникайте сторонніх матеріалів.
Визначайте контракт виведення. Для перекладу називайте дві мови та локаль. Для редагування вказуйте, які факти й форматування мають зберегтися. Для агента визначайте перевірки та момент зупинки.
Розглядайте вихідний текст як контент для перетворення. Речення, вбудоване в документ, не повинно отримувати повноваження змінювати завдання, отримувати доступ до облікових даних або публікувати контент.
Перевіряйте результат відповідно до завдання. Перевіряйте захищені терміни, числа, посилання та пропущені фрагменти. Для роботи з кодом або деплоєм перевіряйте фактичні результати тестів і виконання.
Підвищуйте рівень на основі конкретної помилки. Пропущений уточнювальний елемент вказує на потребу в іншому промпті або рівні зусиль. Завдання, яке постійно розширюється, може потребувати Sonnet або Opus. Повторні помилки мають запускати перегляд підходу, а не нескінченне підвищення рівня зусиль.
Як я тестував би налаштування, перш ніж покладатися на них
Я створив би невеликий набір для оцінювання з 20 затверджених анонімізованих прикладів: десять перекладів, п’ять виправлень і п’ять обмежених змін тексту. Ці кількості описують запропонований тест, а не завершене дослідження.
Запускайте low, medium і high з однаковими вхідними даними та критеріями прийняття. Повторюйте приклади, щоб виявити нестабільну поведінку. Нехай переклади оцінює фахівець, який вільно володіє мовою, не знаючи рівня зусиль.
Записуйте точну модель, рівень зусиль, версію промпту, час виконання, оплачувані токени та дефекти. Підраховуйте пропущені уточнення, змінені числа, зламані посилання, пропущений текст і непотрібні переписування. Порівнюйте вартість прийнятого результату, включно з роботою з виправлення.
Для допомоги з деплоєм оцінюйте окремі завдання підготовки в непостійному середовищі з відомим очікуваним результатом. Дії у production залишаються підпорядкованими процедурі затвердження проєкту.
Мій попередній посібник із бенчмаркінгу AI-моделей для реальної роботи→ охоплює ширший підхід до оцінювання. Порівняння GPT-6.1 Sol і Opus 5.5→ дає контекст для вибору більших моделей; це не тест перекладу Haiku.
Серія починається з невеликих завдань
Haiku — перша частина, оскільки переклади, виправлення та короткі редагування роблять компроміси помітними. Ви можете перевірити, чи зберегло речення своє значення і чи залишилося на місці посилання.
У наступних частинах планується розглянути Sonnet для щоденного програмування й аналізу, Opus для складнішої роботи та фінальний посібник із маршрутизації завдань між моделями. У кожній частині використовуватиметься те саме розрізнення: задокументовані можливості, моє фактичне використання та тести, які ще потрібно провести.