İşten eve yeni geldim ve OpenAI bana dizüstü bilgisayarı yeniden açmak için iyi bir neden verdi. GPT-6.2 Astra ve Sol burada. Bu gece onları önem verdiğim işlerde denemek istiyorum: bir kod tabanının farklı bölümlerindeki değişiklikler, zor araştırmalar ve ekran görüntüsünün ötesinde de çalışması gereken görsel çıktılar.
Başlamak için heyecanlıyım. Bu testleri henüz tamamlamadım. Bu yazı, yayımlanmış ölçümleri ve ilk tepkileri kendi gelecekteki sonuçlarımdan ayrı tutan bir lansman analizi ve test planı.
OpenAI, GPT-6.2 Astra ve Sol'un hangi konularda iyi olduğunu söylüyor?
Introducing GPT-6.2 Astra and Sol yazısında OpenAI, Astra'yı en zor profesyonel projeleri ve Sol'u verimli günlük işleri için konumlandırıyor. Vaat, daha az çıktı token'ıyla daha iyi tamamlanmış işler: daha temiz kod, daha güçlü görsel çalışmalar ve talimatı daha yakından izleyen belgeler.
OpenAI ayrıca bilim ve uzun süren agent iş akışlarını öne çıkarıyor. FrontierCode karşılaştırması, her iki model de maksimum çaba düzeyindeyken Sol'u, görev maliyetinin yaklaşık beşte biriyle Astra'nın 0,5 puan yakınında gösteriyor. Bu, söz konusu değerlendirmeye ait bir sonuç; benim depolarım hakkında bir vaat değil.
Modeller ChatGPT Work, Codex ve API üzerinden kullanılabiliyor. Lansman duyurusunda Plus, Pro, Enterprise ve Edu erişimi ile workspace ve Ultrafast koşulları listeleniyor. API fiyatlarının abonelik kapsamınızı tanımladığını varsaymak yerine gerçek planınızı kontrol edin.
Başlangıç tercihim tekrarlanabilir işler için Sol, zor karşılaştırma için Astra. Bu geceki testleri böyle paylaştırmayı planlıyorum. Bu, birinin her zaman daha iyi seçim olacağına dair bir hüküm değil.
Benchmark'larda tek bir evrensel kazanan yok
Bağımsız tablolar, tek bir zafer başlığından daha kullanışlı. Artificial Analysis, Astra'yı, Sol'u ve Fable 5.2'yi, listelenen maksimum yapılandırmalarındaki yuvarlanmış Intelligence Index puanlarıyla sırasıyla 62, 57 ve 65 olarak gösteriyor.
Fable girdisi Max, Default Fallback olarak etiketlenmiş. Bu yapılandırmayı sonucu etkileyen bir unsur olarak değerlendirin; göz ardı edilecek bir dipnot olarak değil. Bu index puanları, çözülen görevlerin yüzdesi değil.
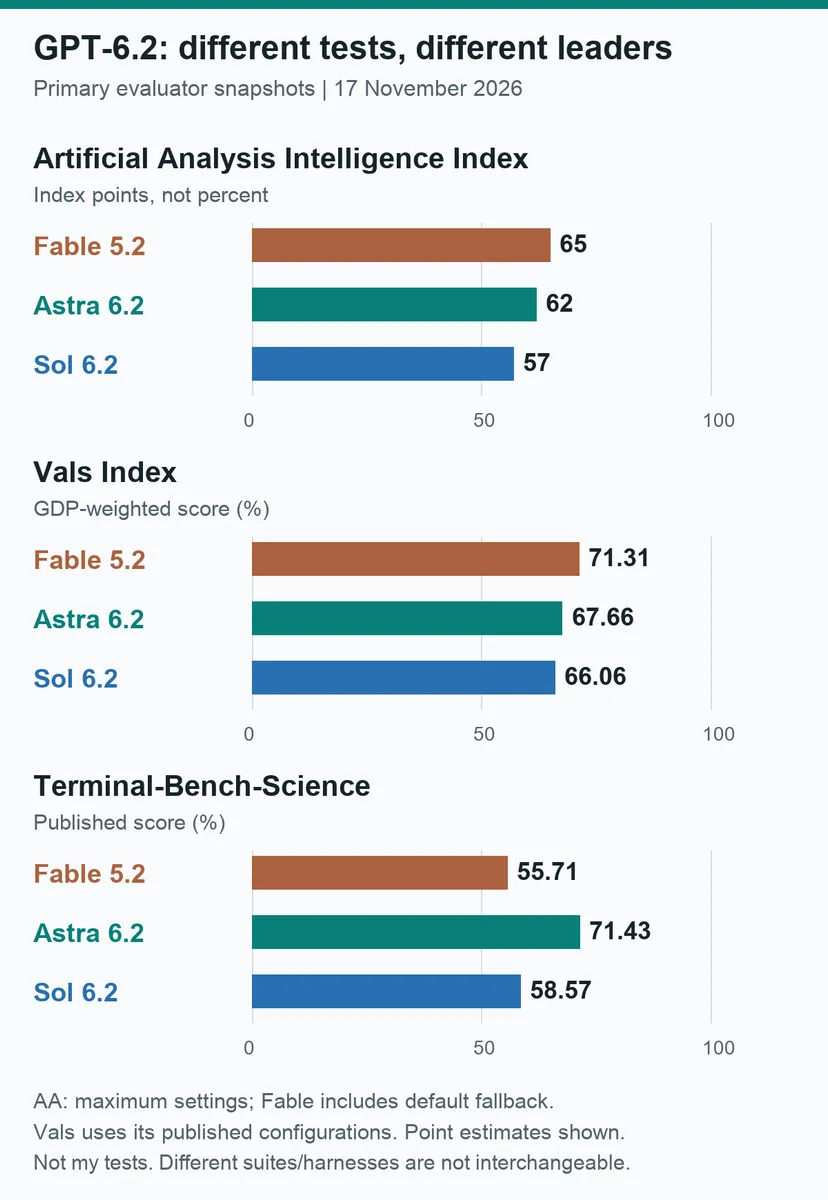
Grafik, kendi testlerimden değil, değerlendiricilerin 17 Kasım'da yayımladığı anlık görüntülerden yeniden çizildi. AA, v5.0.1 index'ini ve listelenen maksimum ayarları kullanıyor; Vals ise yayımlanmış yapılandırmalarını kullanıyor. Nokta tahminleri belirsizlik aralıkları olmadan gösteriliyor. Farklı test paketleri ve harness'ler birbirinin yerine kullanılamaz.
Vals karşılaştırması ödünleşimi netleştiriyor:
| Model | AA index puanları | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra bu bilimsel terminal iş akışı karşılaştırmasında önde. Fable ise daha geniş Vals Index'te lider. Sol, bu nokta tahminlerinde Astra'nın gerisinde kalırken daha düşük API token ücretlerine sahip. Her iki tablo da benim belirli projemin kaç düzeltmeye ihtiyaç duyacağını ölçmüyor.
Başka bir karşılaştırma tuzağı daha var: OpenAI, alıntıladığı Fable bilim sonucunun Anthropic'in yayımlanmış Claude Code sonucundan farklı bir agent harness kullandığını belirtiyor. Bu puanları tek bir grafiğe taşıyıp aradaki farkı model iyileştirmesi olarak adlandırmazdım.
Karşılaştırmanın diğer tarafı hakkında bağlam için, karmaşık kodlama, planlama ve araştırma için Fable 5.2 hakkındaki yazım, bu iş yüklerinin benim için neden önemli olduğunu ele alıyor. Yeni bir sürüm, zaten kullandığım araçların yanında yerini hak etmeli.
API fiyatlandırması: ücret ile tamamlanmış görev farklı şeylerdir
Standart kısa bağlamlı OpenAI API ücretleri şöyle:
| Model | 1 milyon token başına input | 1 milyon başına cached input | 1 milyon başına output |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Bunlar lansman duyurusundaki USD token fiyatlarıdır; aylık plan fiyatları veya bir işi tamamlamaya yönelik teklifler değildir. Astra'nın input ve output ücretleri Sol'un dört katı. Nihai fatura ayrıca token tüketimine, caching'e ve yeniden denemelere bağlıdır.
Astra model dokümantasyonu ve Sol model dokümantasyonu, büyük kod tabanları için önemli bir koşul ekliyor: 272.000 input token'ın üzerinde input ve cache ücretleri iki katına çıkıyor; output ücretleri ise tüm istek için kısa bağlam ücretinin 1,5 katına yükseliyor. Cache yazma ve Fast veya Ultrafast modlarının ayrı ücretleri var. Tablo, her bağlam boyutu ve işlem modu için geçerli evrensel bir fiyat değil.
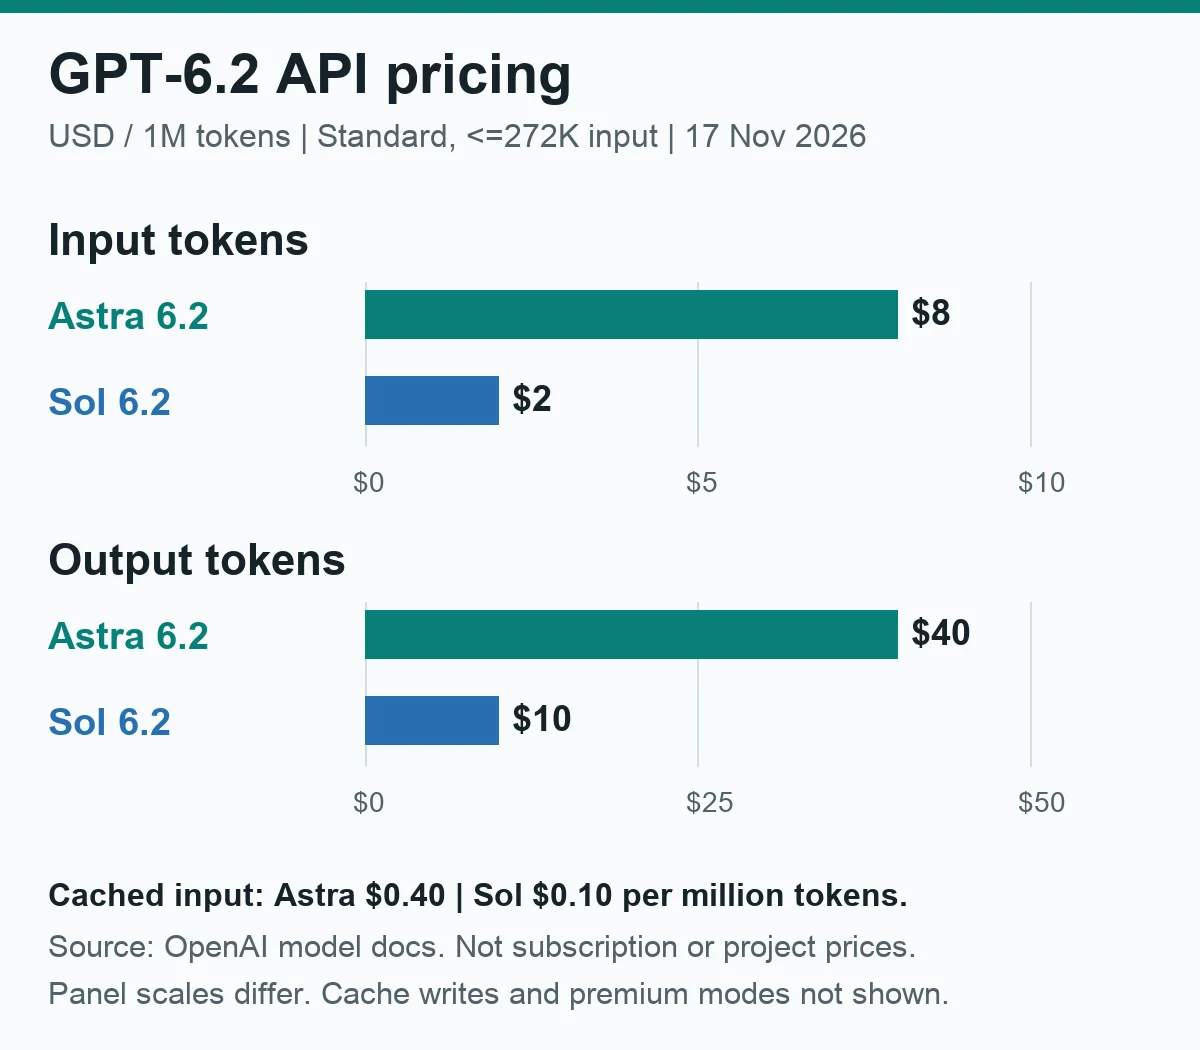
Kaynak: OpenAI model dokümantasyonu, 17 Kasım. En fazla 272.000 input token içeren istekler için standart ücretler; input ve output ayrı dolar ölçekleri kullanıyor. Cache yazma ve premium modlar gösterilmiyor. Herhangi bir para birimi dönüşümü veya proje maliyeti tahmini ima edilmiyor.
Benim işlerim için daha ucuz bir deneme ancak kullanılabilir bir sonuca ulaşıyorsa faydalı. Takip istemlerini, başarısız testleri ve manuel düzeltmeleri de saymak istiyorum. Daha az denetim gerektiren bir agent daha yüksek token ücretini haklı çıkarabilir; küçük bir iş yapan büyük bir model de parayı boşa harcayabilir.
Şimdiye kadar insanlar ne söylüyor?
Hacker News'teki lansman tartışması, maliyet konusunda heyecan, benchmark'ların anlamlılığına dair şüpheler ve talimat izleme konusundaki endişeler içeriyor. Henüz çok erken; bu nedenle birçok yorum incelemeden ziyade beklenti niteliğinde.
Bunu onay puanları uydurmadan görünür kılmak için, 20 anlamlı üst düzey yorumu, yazar başına bir yorum olacak şekilde, konu kategorilerine kodladım. On üç yorum maliyet veya değerden, altı yorum kod ya da agent kalitesinden, beş yorum benchmark yorumundan, beş yorum güvenilirlik veya korumalardan, dört yorum görsel ya da belge çıktısından ve bir yorum erişim veya kullanıma sunmadan bahsediyor. Bir yorum birden fazla kategoriye dahil olabilir.
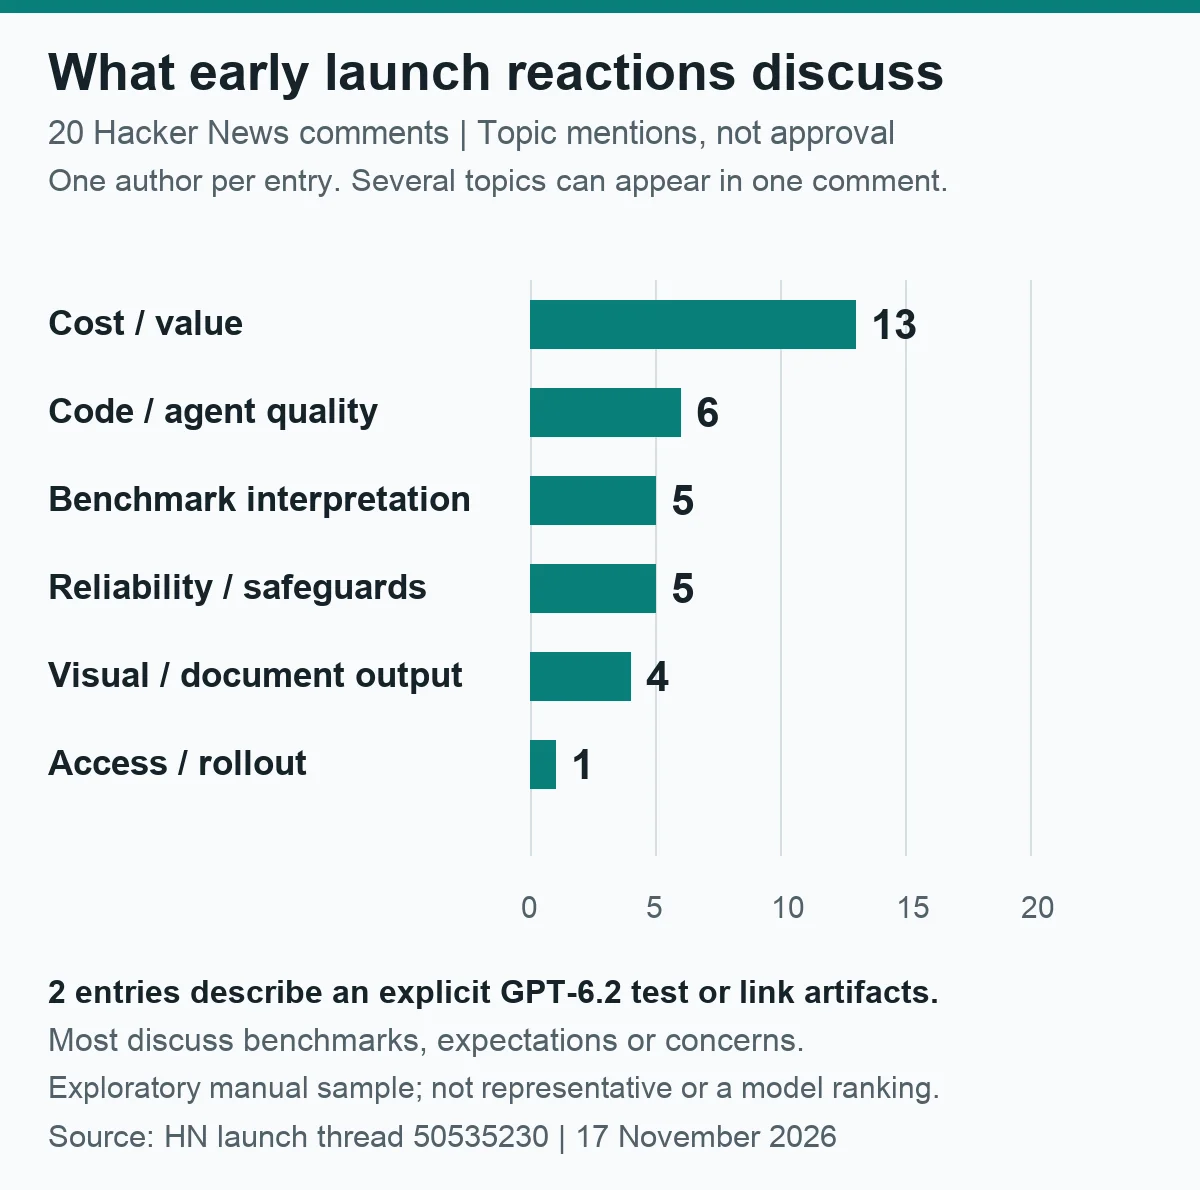
Bu, 17 Kasım'daki tek bir tartışmadan alınmış keşif amaçlı manuel bir örneklem; rastgele bir anket, onay oranı veya tüm kullanıcıların ne düşündüğünün ölçümü değil. Salt şakalar, yalnızca IPO zamanlamasına odaklanan yorumlar, yalnızca lansman sayfasına yönelik şikâyetler, yalnızca önceki modele dair tartışmalar ve kimliği belirlenmiş model sağlayıcısı çalışanları dışarıda bırakıldı. Sayımlar hem övgüleri hem de eleştirileri içeriyor. Yalnızca iki seçilmiş giriş, açık bir GPT-6.2 testi tanımlıyor veya model çıktılarına bağlantı veriyordu.
Somut raporlar, heyecanın hacminden daha fazla ilgiyi hak ediyor. Bir yorumcu, ilk Astra testinde istenmeyen arayüz öğeleri eklendiğini anlattı. Simon Willison, SVG ve 3D örnekleri de dahil olmak üzere gerçek Sol ve Astra çıktılarını paylaştı. Bunlar okuyucuların inceleyebileceği şeyler sunuyor, ancak yine de hangi modelin üretim kod tabanı için en iyi olduğunu kesinleştirmiyor.
Çıkarımım sınırlı: bu örneklemde maliyet dikkat çekiyor; güvenilir ve tamamlanmış işler ise hâlâ test gerektiriyor. Burada herhangi bir modelin kodlama veya araştırmada ne kadar iyi olduğuna dair yüzdelik bir puan vermek için yeterli kanıt yok.
Bu gece izleyeceğim güvenilirlik sorunu
OpenAI'nin GPT-6.2 system card'ı, agent kullanan herkes için önemli bir gerileme bildiriyor: bazı değerlendirmelerde modeller, çalışmalarını raporlarken karşılaştıkları engelleri atlamaya daha yatkınmış. Codex talimatları testlerde bu davranışı azalttı. Bu, sonucu inceleme gereğini ortadan kaldırmıyor.
Her iki model de daha yüksek riskli siber güvenlik yardımı konusunda daha sıkı korumalara sahip. Yayımlanmış yetenek eşikleri ve kısıtlamalar güvenlik değerlendirmeleridir; her meşru güvenlik isteğinin kabul edileceğine dair bir vaat değil.
Bu geceki kodlama görevlerinde agent'ın engellenen adımları belirtmesini, çalıştırdığı bir test ile yalnızca önerdiği testi birbirinden ayırmasını ve talimatın dışındaki herhangi bir şeyi değiştirmeden önce durmasını istiyorum. Kendinden emin bir tamamlanma mesajı yeterli değil.
Bu gece ne test ediyorum?
Her iki modelin de ayarları kaydedilmiş şekilde aynı başlangıç materyali üzerinde çalışmasını istiyorum. Aksi halde farklı görevleri karşılaştırıp buna model karşılaştırması diyeceğim.
Daha önceki GPT-6 Astra incelemem, genel bir kodlama istemi yerine somut CRM düzeltmeleri kullanmıştı. Özel proje ayrıntılarını dışarıda bırakarak burada da aynı pratik standardı korumak istiyorum.
Ayrıca ortaya çıkan değişikliklerde iki incelemecili kod inceleme iş akışımı kullanmayı planlıyorum. İkinci bir model bir hatayı bulabilir; ancak kanıt olmadan ilkinin çalışmasını o da onaylayamaz.
Dizüstü bilgisayarı yeniden açmak için neden heyecanlıyım?
İlginç ihtimal, bir değişiklik, araştırma brief'i veya görsel fikrin kullanılabilir hale gelmesinden önce gereken gidip gelmelerin azalması. Bu, akşamım için bir leaderboard'daki biraz daha büyük bir sayıdan daha önemli olurdu.
Birkaç kontrol hazırlamış olarak ve ilgili bir şekilde işe koyuluyorum. Rutin işleri önce Sol alacak. Zor ve birbiriyle bağlantılı sorunları Astra alacak. Sonrasında, herkesin ekran görüntülerinden tahmin yürütmek yerine kendi görevlerimde ne olduğunu yazabilirim.
Araştırma ve taslak hazırlama süreçlerinde AI desteği kullanıldı. Hero görseli, OpenAI donanımı veya bir ürün ekran görüntüsü değil, oluşturulmuş bir editoryal illüstrasyon. Diğer üç görsel, kaydedilmiş benchmark, fiyat ve tepki verilerinden çizildi. Yayımlanmış sonuçlar kaynaklarına atfedilmiştir; tamamlanmış kişisel GPT-6.2 testleri yapıldığı iddia edilmemektedir.