Google'ın modelleriyle, iş akışımda kullandığım diğer AI araçlarına kıyasla çok daha az zaman geçirdim. Gemini 4 Argon bunu değiştirmem için bana bir neden veriyor. İş otomasyonu sonuçları kullanışlı görünüyor ve duyurulan başlangıç fiyatı, yalnızca premium bir model olmak yerine GPT-6.1 Sol ile aynı seviyede yer alıyor.
Erişim açıldığında test etmek istiyorum. Şimdilik bu, uygulamalı bir Argon incelemesi değil; yayımlanmış kanıtlara, fiyatlandırmaya ve ilk tepkilere bir bakış.
Kaynak kontrolü: 1 Ekim 2026. Kapak görseli AI ile oluşturulmuş editoryal bir çalışmadır. Aşağıdaki grafikler, atıf yapılan sayısal sonuçların yeniden çizimidir; kendi testlerimin ekran görüntüleri değildir.
Gemini 4 Argon nedir ve henüz kullanabilir miyim?
Google, Argon'u 30 Eylül 2026'da ilk olarak Fairwind aracılığıyla güvenilir siber savunucular için duyurdu. Daha geniş erişim, ücretli API müşterileri ve Google AI Ultra aboneleriyle başlayacak; duyuruda kesin bir genel kullanıma sunulma tarihi verilmiyor. Google'ın Gemini 4 Argon duyurusuna bakın.
Özellikle Argon için abonelik satın almadan önce gerçek hesap erişimini beklerdim. Duyurulmuş bir kullanıma sunma süreci, bugün seçebildiğim bir modelden farklıdır ve Google bu duyuruda İsveç için bir erişilebilirlik tarihi vaat etmedi.
Benim için dikkat etmeye değer en güçlü neden, daha uzun görevleri daha az müdahaleyle tamamlama ihtimali. Faydalı testim mevcut kodu, karmaşık iş kurallarını ve nihai sonucun çalıştığına dair kanıtları içerecek. Tek başına kusursuz bir yanıt bunu kanıtlamaya yetmeyecek.
Gemini 4 Argon fiyatlandırması: başlangıç oranının bir koşulu var
Google, milyon token başına $2 input ve $10 output fiyatını duyuruyor. Fiyatlandırma dipnotu, başlangıç döneminin bitiş tarihini belirtmeden sonraki oranı $4/$20 olarak belirliyor. Önbelleğe alınmış input %95 indirim alıyor; bu da hesaplamayla başlangıçta $0.10 oranına denk geliyor.
| Model veya fiyatlandırma dönemi | Input / 1M token | Output / 1M token |
|---|---|---|
| Gemini 4 Argon, başlangıç | $2 | $10 |
| Gemini 4 Argon, başlangıç sonrası | $4 | $20 |
| GPT-6.1 Sol, Standard | $2 | $10 |
| Claude Opus 5.5, Standard | $4 | $20 |
| GPT-6 Astra, Standard | $10 | $50 |
Kaynaklar: Google'ın duyurusu ve genişletilmiş fiyatlandırma dipnotu, GPT-6.1 Sol model fiyatlandırması, GPT-6 Astra model fiyatlandırması ve Claude Platform fiyatlandırması.
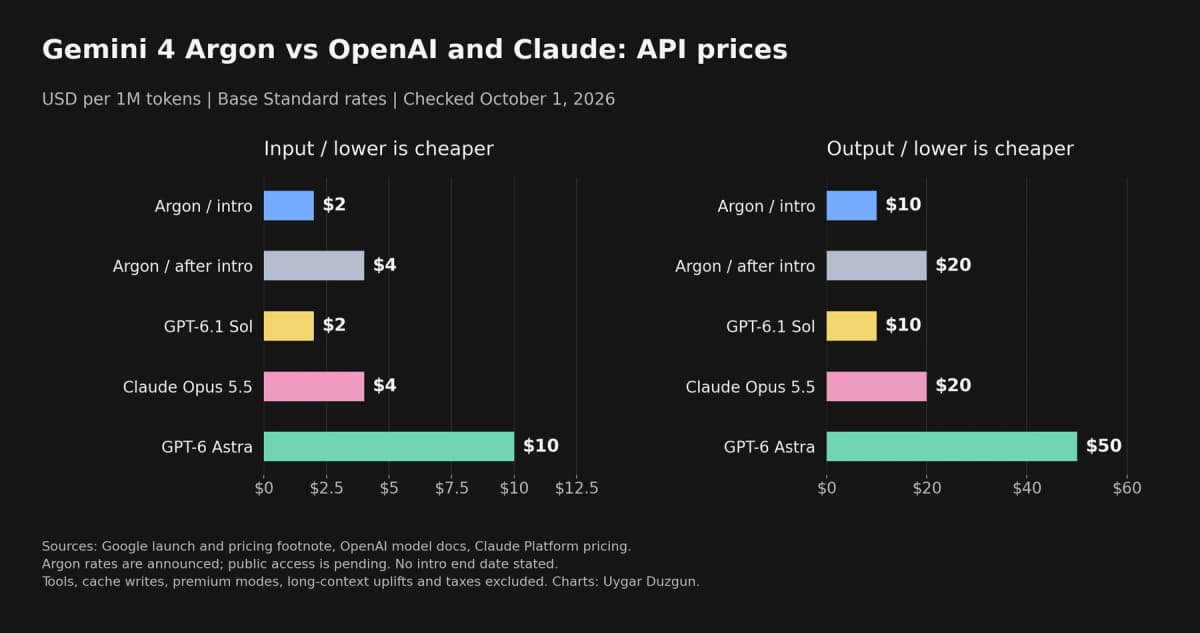
Temel USD oranları 1 Ekim'de kontrol edildi. Argon'un fiyatları duyurulmuş oranlardır; genel API erişiminin kanıtı değildir. Karşılaştırmaya araçlar, cache yazımları, premium modlar, bölgesel ücretler ve vergiler dahil değildir.
Basit bir bütçe örneğinde, birden fazla kısa context isteğine yayılan bir milyon önbelleğe alınmamış input token'ı ve 100.000 output token'ı, Argon'un başlangıç oranlarıyla $3, sonrasında $6, Sol ile $3, Opus ile $6 ve Astra ile $15 tutar. Bu, sabit bir token karışımı kullanılarak yapılan bir aritmetiktir; ölçülmüş bir iş yükü değildir. Aynı görev, modeller arasında farklı miktarlarda token tüketebilir.
OpenAI ayrıca tek bir prompt'ta 272.000 input token'ın üzerindeki tam istekler için fiyatları artırıyor; Anthropic, Opus 5.5'in context window'u genelinde standard fiyatlandırmayı listeliyor. Bu nedenle temel fiyat tablosu, devasa bir repository oturumunun faturasını size söyleyemez. GPT-6.1 Sol ve Opus 5.5 karşılaştırmam bu ödünleşimleri ele alıyor.
Bir entegrasyonu Argon'un sonraki oranını kullanarak bütçelendirir, ardından kampanyayı geçici bir tasarruf olarak değerlendirirdim. Böylece, sona erme tarihini henüz planlayamadığım bir indirime dayalı bir iş gerekçesi oluşturmaktan kaçınırım.
Gemini 4 Argon benchmark'ları: güçlü otomasyon, karmaşık coding sonuçları
En çok önemsediğim sonuç iş otomasyonu
Zapier's AutomationBench 1.0.6, altı iş fonksiyonunda 47 araç genelinde uçtan uca çalışmayı test ediyor. Bir agent'ın ikna edici nihai mesajını puanlamak yerine, ortaya çıkan ortamı deterministik assertions ile kontrol ediyor.
Aşağıdaki seçili yapılandırmalar, effort ayarlarını ve fallback davranışlarını koruyor.
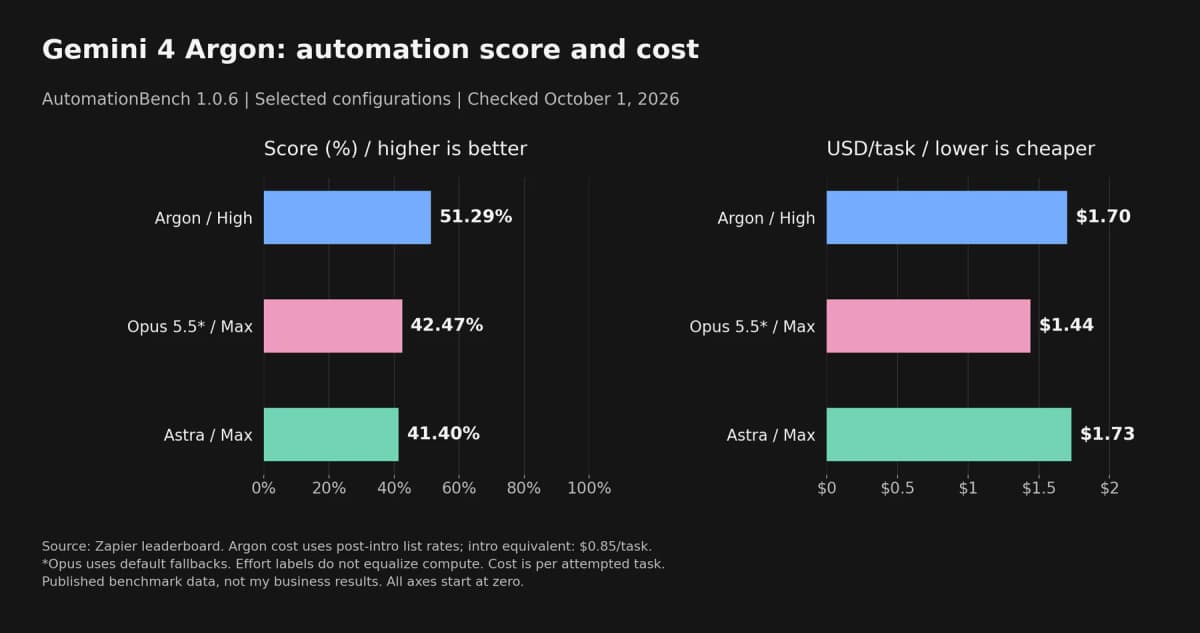
Zapier, Argon High'ın sonraki liste fiyatları kullanıldığında %51,29 ve denenmiş görev başına $1,70 sonuç verdiğini bildiriyor; başlangıçtaki karşılığı $0,85. Varsayılan fallback'lere sahip Opus 5.5 Max, $1,44 ile %42,47; Astra Max ise $1,73 ile %41,40 skor alıyor. Effort etiketleri, sağlayıcılar arasındaki compute budget'ları eşleştirmiyor.
Argon bu karşılaştırmada daha yüksek skora sahip, ancak normal görev maliyeti en düşük değil. Yaklaşık %51'lik bir benchmark skoru da unattended production erişimini haklı çıkarmaz. Sonuçları inceleyebileceğim log'lar, önemli eylemler için hâlâ onay ve kısmi tamamlanmadan kurtulmanın bir yolunu istiyorum.
Bu ayrım iş otomasyonu için önemli. Doğru kaydın güncellenmesini ve doğru alıcının mesajı almasını önemsiyorum. Bir agent'ın işi bitirdiğini söylemesi, bu kontrollerin yerini tutamaz.
Coding sonuçları göreve bağlıdır
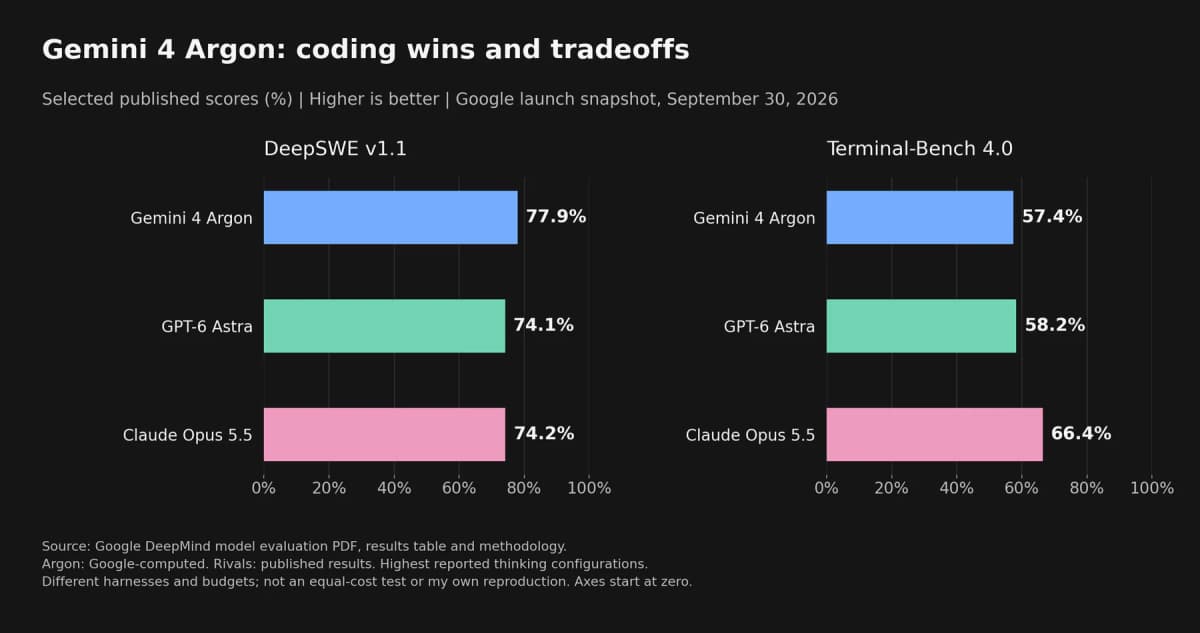
Google DeepMind'in model değerlendirme raporundan seçili skorlar. Bu karşılaştırma, Google tarafından hesaplanan Argon sonuçlarını yayımlanmış rakip sonuçlarıyla birleştiriyor; tek tip bağımsız bir head-to-head çalışması değil.
Argon, DeepSWE v1.1'de %77,9'a ulaşırken Astra %74,1 ve Opus %74,2'de kalıyor. Terminal-Bench 4.0'da Opus, bu üçlüde %66,4 ile önde; onu %58,2 ile Astra ve %57,4 ile Argon izliyor. Rapor ayrıca FrontierSWE v2'de Astra'yı önde gösteriyor: Argon'un %55,0'ına karşı %65,5.
Google genellikle en yüksek thinking ayarlarını ve rakiplerin mevcut en yüksek veya en iyi sonuçlarını raporluyor. Harness'ler ve budget'lar önemlidir. Bir repository benchmark'ındaki liderlik, özellikle fark yalnızca birkaç yüzde puanı olduğunda, codebase'imde daha iyi bir düzeltme garantilemez.
Sınırlı bir regression repair ile multi-file değişikliği ayrı ayrı test ederdim. Her ikisi de davranış kontrolleri ve diff incelemesi gerektirir. Bir model testi geçerken sürdürmek istemediğim bir abstraction ekleyebilir.
Bağımsız knowledge-work kanıtı bağlam sağlıyor
30 Eylül'de güncellenen Vals Index 2.1, Argon'u %68,90, Opus 5.5'i %66,97, Astra'yı %63,13 ve Sol 6.1'i %61,15 olarak listeliyor. Vals, ABD GDP'sine dayalı sektör ağırlıklarıyla finance, coding, legal ve tax görevlerini birleştiriyor.
Maliyet sütunu sıralamayı karmaşıklaştırıyor: $4/$20 token oranlarında Argon için test başına $15,68; Sol içinse $3,24. Bunlar benchmark'a özgü maliyetlerdir, benim çalışmam için teklif değildir. Başka bir model skor sütununda zirveye çıksa bile değerlendirmede neden daha ucuz bir modeli tutacağımı gösteriyorlar.
Görevleri ölçtükten sonra yönlendirme yapardım. Kolay, tekrarlanan işler ile pahalı hatalar otomatik olarak aynı modeli kullanmamalı.
Diğer insanlar Argon hakkında ne söylüyor?
İlk Gemini 4 Argon sürüm tartışması, heyecanı, kısıtlı erişim konusundaki hayal kırıklığını ve sonraki fiyatla ilgili hatırlatmaları içeriyor. Bunlar bireysel kullanıcılardan gelen sürüm tepkileridir; temsili bir anket değildir ve hepsinin Argon'u denediğine dair kanıt sunmaz. Haftalarca veya aylarca bekleme öngören yorumlar spekülasyondur.
Benim için daha faydalı tartışma, Rust topluluğunun Google'ın codebase migration'ları hakkındaki tartışmasında ortaya çıkıyor. Yorumculardan nicoburns, orijinal tasarım zaten mevcut olduğu için diller arasındaki çevirinin daha iyi çalışabileceğini savunuyor. Diğerleri maintainability sorunlarını ve oluşturulan kodu düzeltmek için harcadıkları çabayı anlatıyor.
Bu tartışma genel olarak agent-assisted engineering ile ilgili. Argon'un gerçek dünya güvenilirliğini ortaya koymuyor. Pratik dersi ciddiye alıyorum: davranışı orijinalle karşılaştırın, değişiklikleri incelenebilir tutun ve sonrasında geriye kalan insan işini ölçün.
Gemini 4 Argon'u nasıl test etmeyi planlıyorum
Google'a adil bir şans verecek kadar merak ediyorum. Modelden her şeyi bir anda devralmasını istemek yerine, doğrulayabileceğim görevlerle başlayacağım.
Geçen süreyi, token maliyetini, retry'ları, doğruluğu ve review effort'ını kaydetmek istiyorum. Soru, Argon'un sonucu kontrol etme ve düzeltme dahil toplam işimi azaltıp azaltmadığı.
Google'ın duyurusu ayrıca output limitini bir milyon token'a çıkarıyor. Bu bir üst sınırdır, hedef değil. Yine de budget'lar ve durma koşulları belirlerdim; daha fazla kullanılabilir reasoning, maliyetini karşılamalı. AI reasoning token'ları ve compute maliyetleri hakkındaki makalem, bu ödünleşimi neden önemsediğimi açıklıyor.
Gemini 4 Argon test edilmeye değer görünüyor. Henüz Google'ı workflow'umda adil bir yere koyacak kadar kullanmadım. Bu sonuçlar, modele erişebildiğimde bunu değiştirmek istememe neden oluyor; ancak kendi testlerim daha fazlasını söyleyene kadar Sol, Opus ve Astra'yı gerçek alternatifler olarak tutacağım.