LLM:s svarta låda är ett praktiskt problem: en modell kan besvara en svår fråga på några sekunder, samtidigt som vi inte kan förklara vilka interna beräkningar som producerade svaret. Den 15 oktober 2026 publicerade Nick Cammarata, medförfattare till OpenAI:s neuronstudie från 2023, Neural Networks Are Already Clean som Goodfire-forskare. Han hävdar att denna "svarta låda" kan vara lättare att studera än forskningsfältet antagit. Påståendet förtjänar uppmärksamhet. Det behöver också läsas noggrant: essän är en arbetshypotes, och den tillhörande tekniska artikeln om språkmodellneuroner har ännu inte publicerats.
Den användbara frågan är om forskare kan gå från en intressant beskrivning av en neuron till en tillförlitlig förklaring av en modells beteende. Cammarata presenterar nya belägg för det första steget och flera kausala demonstrationer av det andra. Inget av detta utgör en komplett karta över en stor språkmodell.
För en sammanfattning på enkel svenska, hoppa till den enkla versionen.
Varför består LLM:s svarta låda?
Forskare känner till de matematiska operationerna i ett tränat nätverk. Det svåra är att förklara hur miljontals inlärda komponenter kombineras för att producera ett visst svar. En enskild artificiell neuron kan aktiveras av exempel som verkar orelaterade. Om den reagerar både på ansiktet hos en katt och fronten på en bil, vad representerar den egentligen?
Ett inflytelserikt svar var superposition: en modell kan packa orelaterade egenskaper i överlappande interna riktningar eftersom den har begränsat utrymme. Forskare tränar sedan en andra modell, ofta en gles autoencoder, för att separera dessa egenskaper.
Cammarata hävdar att vissa av de klassiska beläggen för denna bild har misstolkats. Den uppenbara blandningen kan i stället återspegla ett gemensamt mönster, ett ofullkomligt mikroskop eller en nätverksarkitektur som gjorde senare lager svårare att träna. Hans definition av superposition är specifikt att orelaterade beräkningar packas in i samma mekanism; andra forskare använder ordet bredare för att beskriva representationen av fler koncept än det finns dimensioner. Hans essä förklarar den skillnaden.
Vad förändrades i den nya forskningen?
Den välkända neuronen för katt och bil kom från en visionsmodell, inte en LLM. Cammarata beskriver den nu som en neuron som reagerar på ett gemensamt V-format visuellt mönster. Enligt hans redogörelse grupperar neuronen relaterad visuell struktur i stället för att dölja två godtyckliga koncept i samma plats. Han rapporterar också att efter arkitektoniska förändringar av InceptionV1, en visionsmodell, blev 99–100 % av neuronerna i dess sista lager lätta att tolka, medan modellstorlek och träningsdata hölls konstanta. Det är ett påstående om ett omtränat lager i en visionsmodell. Det är inte en statistik om moderna chattmodeller.
Beläggen från språkmodeller är mer relevanta för LLM:er och mer preliminära. Goodfires team uppskattar att omkring 90 % av neuronpolerna i en inledande granskning av Qwen3-32B har en huvudsaklig uppgift, ofta med små relaterade utlöpare. Ytterligare ungefär 7 % har två relaterade uppgifter, och omkring 2–4 % förblir oförklarade.
En "pol" syftar på ena sidan av en neurons positiva eller negativa respons; procentsatsen betyder inte att 90 % av en LLM:s beteende har förklarats. Cammarata säger att klassificeringen förändras beroende på tröskeln för svaga aktiveringar, modellens djup, kretsarnas täthet och vad som räknas som en uppgift. Dessa förbehåll står bredvid uppskattningen.
Teamet erbjuder mer än etiketter för aktiveringar. Dess interaktiva essä innehåller 1 000 slumpmässigt utvalda fallstudier av neuroner från Qwen3-32B och Qwen3.6-35B-A3B. I ett test använde en agent skriftliga förklaringar för att hitta på exempel som borde aktivera en neuron och nästan-exempel som inte borde göra det. Bland 183 neuroner med förklaringar av sin positiva sida aktiverades de nya exemplen starkt 76 % av gångerna, jämfört med 11 % för nästan-exemplen. Det är ett användbart prediktionstest inom teamets upplägg. Det fastställer inte att beskrivningarna fångar varje viktig aktivering eller nedströms effekt.
Kan forskarna ändra en LLM:s svar genom att ingripa?
Ja, i utvalda exempel. Goodfire spårar grupper av neuroner i Qwen3-32B och tar sedan bort dem för att se vad som förändras. I en prompt där ledtrådarna pekar på jultomten sänkte borttagningen av åtta utvalda neuroner som var kopplade till svaret modellens rapporterade sannolikhet för "Santa" till 0,059; när samma antal slumpmässiga neuroner från motsvarande lager togs bort låg den kvar på 0,997. Detta är belägg för att de utvalda neuronerna hade betydelse för den prompten och nästa ords prediktion. Det är inte en uppmätt framgångsfrekvens över godtyckliga prompter eller modeller. Interventionen och kontrollen visas i originalessän.
Cammarata visar också en neuronbaserad attribueringsgraf för Kimi K3, en modell med flera biljoner parametrar. Plånboksexemplet följer vissa vägar från prompten mot ett svar om att lämna tillbaka upphittad egendom. Essän kallar de visade grupperna ett handplockat utsnitt och säger att fullständiga granskningar i den skalan ännu inte har påbörjats. Ett läsbart utsnitt av en mycket stor modell är lovande, men det kan inte berätta vad varje utelämnad väg gjorde.
Hur reagerar andra forskare?
Den 17 oktober publicerade forskaren Leo Gao Neural networks are not already clean. Han håller med om att tidigare forskning kan ha kallat neuroner polysemantiska för snabbt.
Hans invändning är att en prydlig beskrivning av de starkaste exemplen fortfarande kan missa indata som borde aktivera neuronen, svaga responser som spelar roll eller betydelsen av aktiveringens styrka. Gao föreslår ett hårdare test: ersätt neuronens värden med värden som förutsägs utifrån förklaringen och mät sedan om resten av modellen fortfarande beter sig på samma sätt. Om beteendet försämras har förklaringen missat något viktigt.
Neel Nandas direkta svar gör en närliggande åtskillnad. Han ser praktiskt värde i att använda inbyggda neuroner och attribueringsgrafer för att undersöka ett särskilt misstänkt beteende. Han är fortfarande inte övertygad om att detta visar att ambitiös reverse engineering är nära, och pekar särskilt på svaga aktiveringar i LLM:er och information i residualströmmen. Cammarata säger själv att attention är mindre förstådd i detta arbete och att enorma språkmodeller är långt ifrån fullständigt kartlagda.
Oenigheten är produktiv. Goodfire frågar om nätverkets egna komponenter kan vara utgångspunkten för tolkning. Gao och Nanda frågar hur mycket en förklaring måste kunna förutsäga innan vi kan lita på den. En neuron kan verka lättolkad, ha ett kausalt deltagande i ett svar och ändå ha viktigt beteende som vi inte har fångat.
Två andra reaktioner skärper beviskraven. I samma offentliga diskussion efterfrågar John Wentworth en förklaring neuron för neuron av den presenterade ConvNeXt-visionsmodellen, med beläggen för varje tolkning. Han säger att det offentliga mikroskopet i sig inte gjorde betydelsen hos dessa neuroner omedelbart tydlig för honom. Det är en begäran om ett granskningsbart artefakt, inte ett test som motbevisar LLM-resultaten. Alex Gibson pekar på en annan lucka: essän kallar sin största slutsats mycket spekulativ, medan vissa korta inlägg på sociala medier låter mer säkra. Detta är tidiga individuella reaktioner, inte ett domslut från hela forskningsfältet.
Gör detta ett AI-system säkert eller transparent?
Nej, dessa resultat utgör inget säkerhetsintyg. En förklaring av en neuron är ett lokalt påstående. En attribueringsgraf är en partiell redogörelse för en beräkning. Ett systemövergripande säkerhetsanspråk skulle kräva täckning av viktiga kretsar, tillförlitliga tester mot missat beteende och belägg för att metoden fungerar bortom de exempel som valts ut för granskning. För ett system som använder verktyg behöver AI-agentbehörigheter→ fortfarande begränsa vad modellen kan göra, oavsett hur läsbara dess interna kretsar blir.
Goodfires tekniska artikel om språkmodeller och oberoende replikering kommer att vara viktiga här.
Det finns också en åtkomstgräns. Dessa experiment granskar interna aktiveringar och ingriper i komponenter. Om din produkt bara anropar en hostad chat-API kan du inte köra samma tester på den modellen genom vanliga prompter.
Den enkla versionen
En fråga går in i en AI-modell och ett svar kommer ut. Det svåra är att veta vad som hände inuti.
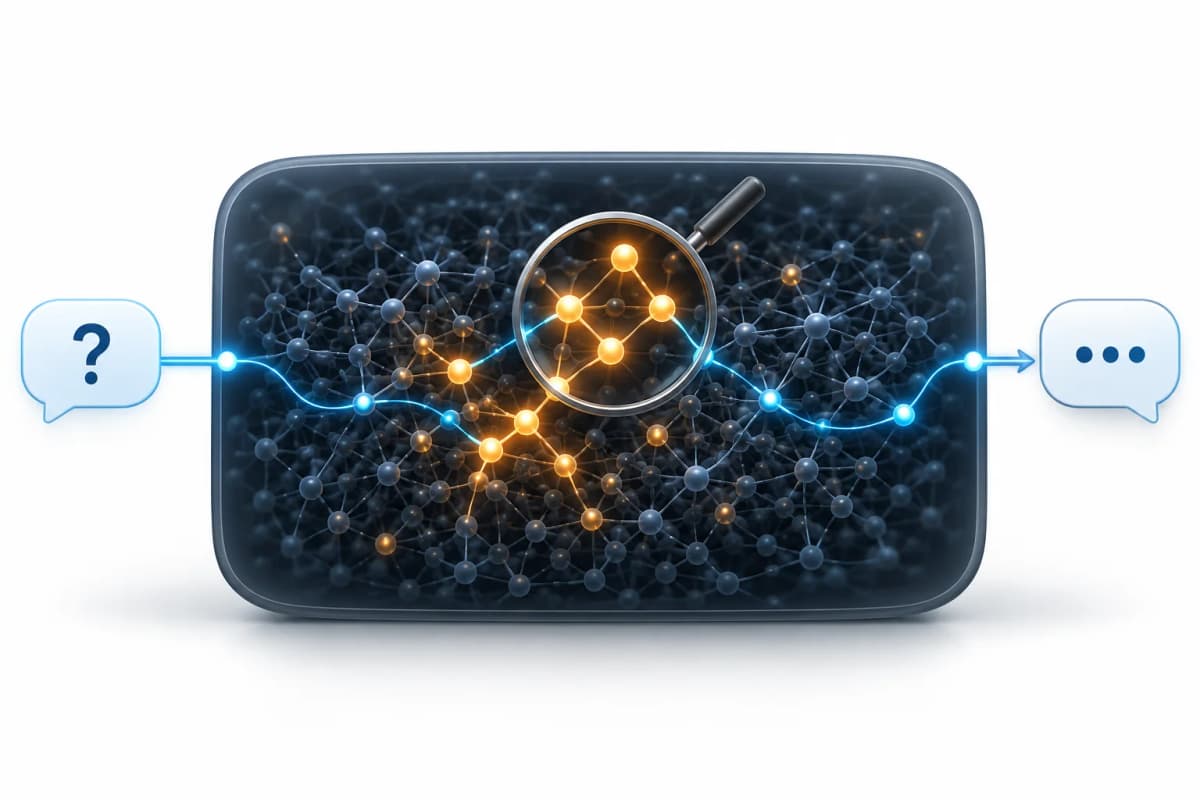
Vad som hände: Goodfire undersökte små delar av en språkmodell som kallas neuroner. I utvalda tester kunde forskarna beskriva vad vissa av dem gjorde och ändra ett svar genom att ta bort dem.
Varför det spelar roll: Modellens inre funktioner kan vara lättare att undersöka än många forskare förväntade sig.
Vad det inte betyder: Vi kan ännu inte förklara varje svar eller kalla modellen säker. Om du bygger med vanliga AI-API:er bör du fortsätta testa utdata och begränsa vad AI:n kan göra. Senare studier kan leda till bättre verktyg för felsökning och övervakning av modeller.
Vad betyder detta för AI-produkter i dag?
För de agent- och innehållsarbetsflöden jag bygger ger detta resultat oss ingen ny knapp att slå på. Det omedelbara arbetet är att testa de uppgifter som användarna faktiskt kör, kontrollera källor och faktapåståenden, logga modellens och verktygens beteende, begränsa verktygsbehörigheter och kräva mänskligt godkännande innan konsekvensrika externa åtgärder. Dessa kontroller hanterar observerbara fel oavsett om modellens neuroner är lättolkade.
Du kan fortfarande utvärdera en hostad modells externa beteende. Min tidigare guide till LLM-konfidenskalibrering→ behandlar en sådan uppgift: att kontrollera om ett poängvärde följer korrektheten i ditt eget arbete. Det mäter en annan fråga än mekanistisk interpretabilitet, och båda kräver tydliga begränsningar.
Innan jag införde en intern monitor skulle jag fråga vilket beteende den upptäcker i data som hållits utanför träningen, hur ofta den missar skadliga fall eller avbryter godartade sådana, om den agerar före ett verktygsanrop och om leverantören faktiskt exponerar de aktiveringar som krävs. Vanliga API-utdata besvarar inte dessa frågor.
Vad kan förändras på längre sikt?
Om andra team reproducerar neuronresultaten och kan spåra de viktiga vägarna mellan neuroner, skulle modellutvecklare kunna diagnostisera fel på mekanismnivå i stället för att bara studera utdata. Cammarata skisserar också automatiserade forskningsagenter och möjligheten att försiktigt förändra en träningsmiljö som visar sig vara skadlig som möjliga framtida steg. Detta är förslag att testa, inte förmågor som etablerats av denna essä.
En närliggande riktning har redan ett konkret exempel. I en separat Goodfire-studie av Kimi K3 matar en aktiveringsprobe en andra modell som bedömer om en riskfylld agentinteraktion ska avbrytas. Goodfire rapporterar lovande resultat i sina egna utvärderingar. Denna monitor behöver åtkomst till interna aktiveringar, och studien validerar inte Cammaratas neuronförklaringar. Den visar vad signaler på modellnivå så småningom kan erbjuda en leverantör eller en distribution med öppna vikter; en API-kund skulle behöva en exponerad tjänst och en egen uppgiftsspecifik utvärdering.
Bättre intern insyn kan hjälpa säkerhetsgranskningar och samtidigt göra modellutvecklingen snabbare. Balansen är okänd. En användbar framtida standard skulle be leverantörer visa vilka beteenden deras interna förklaringar täcker, var de misslyckas och om en monitor förbättrar resultaten jämfört med kontroller som enbart bygger på utdata i realistiska arbetsflöden.
Vad bör vi hålla utkik efter härnäst?
Jag skulle leta efter fem delar av bevis i den utlovade tekniska artikeln och uppföljande arbete:
Min tolkning är att Goodfire har lagt fram ett trovärdigt argument för att granska en modells inbyggda neuroner noggrannare. De har också gett forskare bättre experiment att diskutera. Den 17 oktober 2026 är den starkaste slutsatsen snävare än att "LLM:s svarta låda är löst": vissa delar kan vara mer läsbara än väntat, och vägen från läsbara delar till tillförlitliga förklaringar av hela modellen är fortfarande öppen. För team som bygger på hostade API:er är beteendetester och behörighetsgränser fortfarande den praktiska utgångspunkten.
Primärkällor: Cammaratas forskningsessä, Gaos svar, den direkta forskardiskussionen och Goodfires separata studie av aktiveringsmonitorer.