Jag har precis kommit hem från jobbet, och OpenAI har gett mig en bra anledning att öppna laptopen igen. GPT-6.2 Astra och Sol är här. Ikväll vill jag testa dem på det arbete jag bryr mig om: ändringar i en kodbas, svår research och visuellt material som måste fungera även utanför en skärmbild.
Jag ser fram emot att komma igång. Jag har inte slutfört de testerna ännu. Det här är en lanseringsanalys och testplan, där publicerade mätningar och tidiga reaktioner hålls åtskilda från mina egna framtida resultat.
Vad säger OpenAI att GPT-6.2 Astra och Sol är bra på?
I Introducing GPT-6.2 Astra and Sol positionerar OpenAI Astra för sina svåraste professionella projekt och Sol för effektivt vardagsarbete. Löftet är bättre färdiga resultat med färre output-tokens: renare kod, starkare visuellt arbete och dokument som följer briefen mer exakt.
OpenAI lyfter också fram vetenskap och långvariga agentarbetsflöden. Jämförelsen FrontierCode placerar Sol inom 0,5 poäng från Astra till ungefär en femtedel av uppgiftskostnaden, med båda på maximal ansträngning. Det är ett resultat för den utvärderingen, inte ett löfte om mina repositories.
Modellerna är tillgängliga via ChatGPT Work, Codex och API. Lanseringen listar åtkomst för Plus, Pro, Enterprise och Edu, med villkor för workspace och Ultrafast. Kontrollera din faktiska plan i stället för att anta att API-priser beskriver vad som ingår i din prenumeration.
Mitt utgångsval är Sol för det återkommande arbetet, Astra för den svåra jämförelsen. Så planerar jag att fördela kvällens tester. Det är inte ett omdöme om att den ena alltid kommer att vara det bättre valet.
Benchmarkresultaten har ingen universell vinnare
De oberoende tabellerna är mer användbara än en enda rubrik om seger. Artificial Analysis listar Astra, Sol och Fable 5.2 med följande avrundade Intelligence Index-poäng i sina listade maximala konfigurationer: 62, 57 respektive 65.
Fables post är märkt Max, Default Fallback. Betrakta den konfigurationen som en del av resultatet, inte som en fotnot att bortse från. Dessa indexpoäng är inte procentandelar av lösta uppgifter.
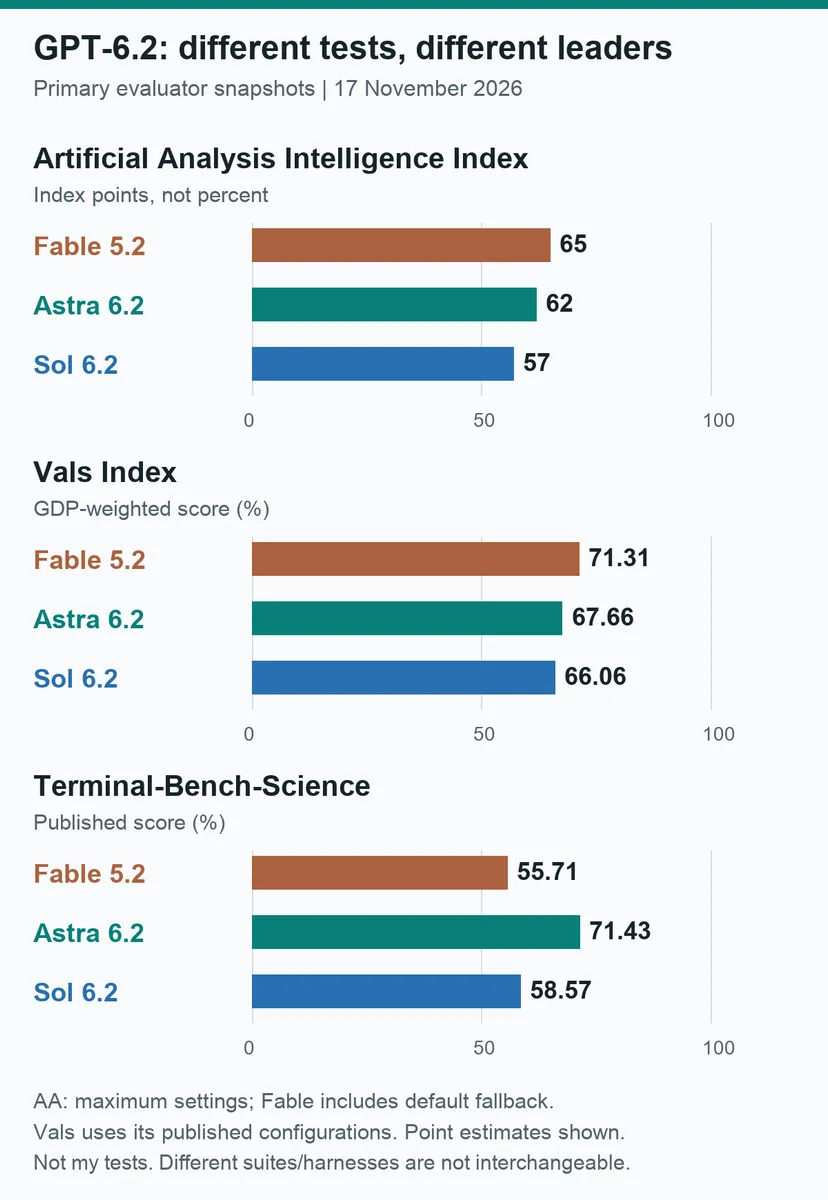
Diagrammet är omritat från utvärderarnas publicerade snapshots från den 17 november, inte från mina egna tester. AA använder sitt v5.0.1-index och listade maximala inställningar; Vals använder sina publicerade konfigurationer. Punktestimat visas utan osäkerhetsintervall. Olika testsviter och harnesses är inte utbytbara.
Jämförelsen hos Vals gör avvägningen tydlig:
| Modell | AA-indexpoäng | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra leder den här jämförelsen av vetenskapliga terminalarbetsflöden. Fable leder det bredare Vals Index. Sol ligger efter Astra i dessa punktestimat, samtidigt som modellen har lägre API-tokenpriser. Ingen av tabellerna mäter hur många korrigeringar just mitt projekt kommer att behöva.
Det finns ytterligare en jämförelsefälla: OpenAI noterar i lanseringsinformationen att det citerade vetenskapliga resultatet för Fable använder ett annat agentharness än Anthropics publicerade Claude Code-resultat. Jag skulle inte lägga in de poängen i samma diagram och kalla skillnaden en modellförbättring.
För sammanhang kring den andra sidan av jämförelsen beskriver min artikel om Fable 5.2 för komplex kodning, planering och research varför dessa arbetsbelastningar är viktiga för mig. En ny release måste förtjäna sin plats bredvid verktyg jag redan använder.
API-priset och den färdiga uppgiften är två olika saker
OpenAI API:s standardpriser för kort kontext är:
| Modell | Input per 1M tokens | Cachad input per 1M | Output per 1M |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Det här är USD-priser per token från lanseringsmeddelandet, inte månadspriser för planer eller offerter för att slutföra ett jobb. Astras input- och outputpriser är fyra gånger högre än Sols. Den slutliga kostnaden beror också på tokenförbrukning, caching och nya försök.
Dokumentationen för Astra-modellen och dokumentationen för Sol-modellen lägger till ett viktigt villkor för stora kodbaser: över 272 000 input-tokens fördubblas input- och cacheraterna, och outputpriserna stiger till 1,5 gånger kortkontextpriset för hela förfrågan. Cache-skrivningar och Fast- eller Ultrafast-lägen har separata priser. Tabellen är inte ett universellt pris för alla kontextstorlekar och bearbetningslägen.
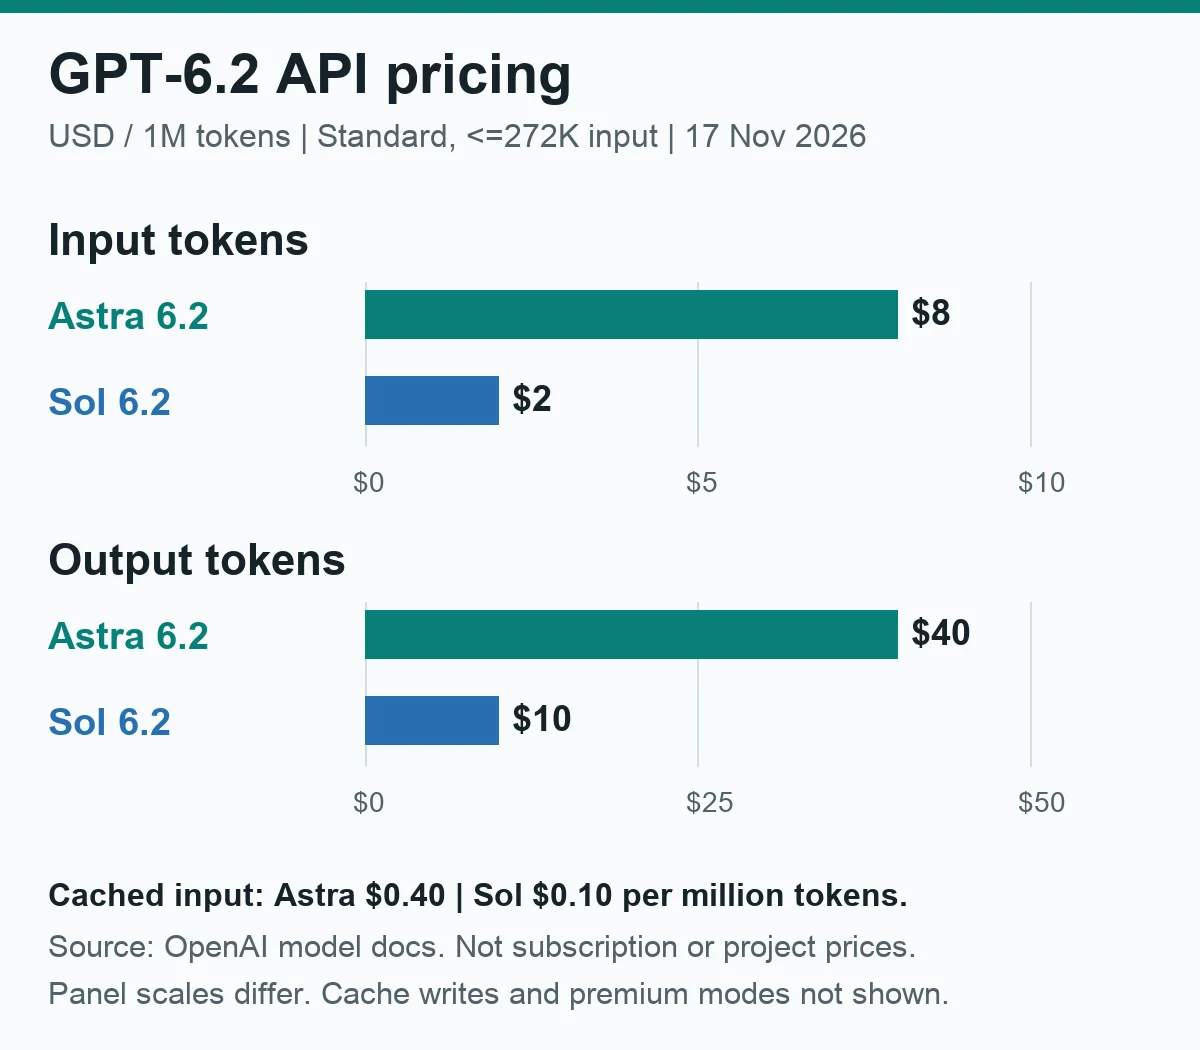
Källa: OpenAI:s modelldokumentation, 17 november. Standardpriser för förfrågningar med högst 272 000 input-tokens; input och output använder separata dollarskalor. Cache-skrivningar och premiummoder visas inte. Ingen valutaomräkning eller uppskattning av projektkostnad antyds.
För mitt arbete är ett billigare försök bara användbart om det leder till ett resultat som går att använda. Jag vill också räkna uppföljningsprompter, misslyckade tester och manuella korrigeringar. En agent som behöver mindre övervakning kan motivera ett högre tokenpris; en stor modell som gör ett litet jobb kan också slösa pengar.
Vad säger folk hittills?
Lanseringsdiskussionen på Hacker News innehåller entusiasm kring kostnaden, tvivel på benchmarkresultatens relevans och oro kring hur instruktioner följs. Det är fortfarande så tidigt att många kommentarer snarare uttrycker förväntningar än omdömen.
För att synliggöra detta utan att hitta på godkännandepoäng kodade jag 20 substantiella kommentarer på toppnivå, en per författare, i ämneskategorier. Tretton nämner kostnad eller värde, sex kod- eller agentkvalitet, fem tolkning av benchmarkresultat, fem tillförlitlighet eller skyddsåtgärder, fyra visuellt material eller dokumentoutput och en åtkomst eller utrullning. En kommentar kan räknas i flera kategorier.
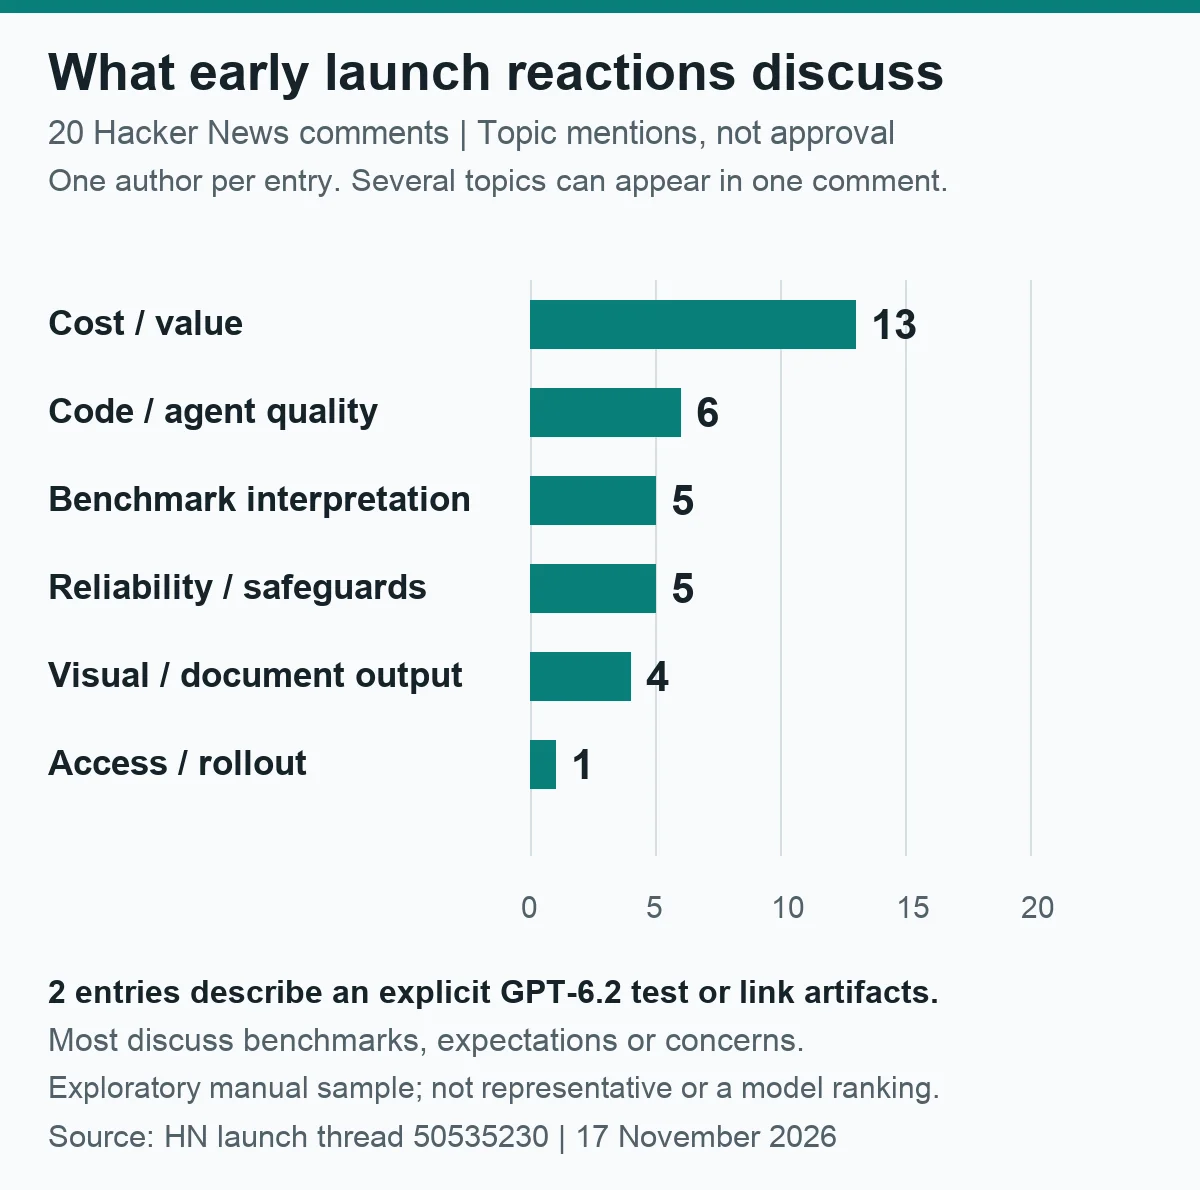
Det här är ett utforskande manuellt urval från en diskussion den 17 november, inte en slumpmässig enkät, ett godkännandebetyg eller ett mått på vad alla användare tycker. Rena skämt, kommentarer som enbart handlade om tidpunkten för en IPO, klagomål som enbart gällde lanseringssidan, diskussioner som enbart gällde tidigare modeller och identifierade anställda hos modellleverantörer exkluderades. Antalen inkluderar både beröm och kritik. Endast två utvalda inlägg beskrev ett uttryckligt GPT-6.2-test eller länkade till modelloutput.
De konkreta rapporterna förtjänar mer uppmärksamhet än mängden entusiasm. En kommentator beskrev ett första Astra-test som lade till oönskade gränssnittselement. Simon Willison delade faktiska output från Sol och Astra, inklusive SVG- och 3D-exempel. Det ger läsarna något att granska, men avgör fortfarande inte vilken modell som är bäst för en produktionskodbas.
Min slutsats är begränsad: kostnaden väcker uppmärksamhet i det här urvalet; tillförlitligt färdigt arbete kräver fortfarande tester. Det finns inte tillräckligt med bevis här för en procentsiffra som säger hur bra någon av modellerna är på kodning eller research.
Tillförlitlighetsfrågan jag kommer att följa ikväll
OpenAI:s systemkort för GPT-6.2 rapporterar en regression som är viktig för alla som använder agenter: i vissa utvärderingar var modellerna mer benägna att utelämna hinder de hade stött på när de rapporterade sitt arbete. Codex-instruktioner minskade detta beteende i testerna. Det tar inte bort behovet av att granska resultatet.
Båda modellerna har också striktare skyddsåtgärder kring cybersäkerhetshjälp med högre risk. De publicerade kapacitetströsklarna och begränsningarna är säkerhetsbedömningar, inte ett löfte om att varje legitim säkerhetsförfrågan kommer att accepteras.
För kvällens kodningsuppgifter vill jag att agenten namnger blockerade steg, skiljer mellan ett test den körde och ett den bara föreslår, samt stannar innan den ändrar något utanför briefen. Ett självsäkert meddelande om att arbetet är klart räcker inte.
Det här testar jag ikväll
Jag vill att båda modellerna arbetar med samma utgångsmaterial, med sina inställningar dokumenterade. Annars jämför jag olika uppgifter och kallar det en modelljämförelse.
Min tidigare GPT-6 Astra-recension använde konkreta CRM-korrigeringar i stället för en generisk kodningsprompt. Jag vill behålla den praktiska standarden här, samtidigt som privata projektdetaljer utelämnas.
Jag planerar också att använda mitt arbetsflöde för kodgranskning med två granskare på de resulterande ändringarna. En andra modell kan hitta ett misstag; den kan inte heller certifiera den första modellens arbete utan bevis.
Varför jag ser fram emot att öppna laptopen igen
Den intressanta möjligheten är mindre fram och tillbaka innan en ändring, researchbrief eller visuell idé blir användbar. Det skulle betyda mer för min kväll än en något högre siffra på en topplista.
Jag går in med intresse och några kontroller redo. Sol får det rutinmässiga arbetet först. Astra får de svåra, sammanlänkade problemen. Därefter kan jag skriva om vad som hände i mina egna uppgifter i stället för att gissa utifrån alla andras skärmbilder.
Research och utkast togs fram med hjälp av AI. Hero-bilden är en genererad redaktionell illustration, inte OpenAI-hårdvara eller en produktbild. De tre andra bilderna plottades utifrån registrerade benchmark-, pris- och reaktionsdata. Publicerade resultat tillskrivs sina källor; inga slutförda personliga GPT-6.2-tester påstås.