Jag har lagt betydligt mindre tid på Googles modeller än på de andra AI-verktygen i mitt arbetsflöde. Gemini 4 Argon ger mig en anledning att ändra på det. Resultaten inom affärsautomation ser användbara ut, och det annonserade introduktionspriset ligger i nivå med GPT-6.1 Sol snarare än med en modell som enbart riktar sig till premiumsegmentet.
Jag vill testa den när åtkomsten öppnar. För tillfället är detta en genomgång av publicerade belägg, priser och tidiga reaktioner, inte en praktisk Argon-recension.
Källkontroll: 1 oktober 2026. Omslaget är AI-genererat redaktionellt material. Diagrammen nedan återger citerade numeriska resultat; de är inte skärmbilder från mina egna tester.
Vad är Gemini 4 Argon, och kan jag använda den redan?
Google annonserade Argon den 30 september 2026, initialt för betrodda cyberförsvarare genom Fairwind. Bredare åtkomst börjar med betalande API-kunder och Google AI Ultra-prenumeranter; tillkännagivandet anger inget fast offentligt lanseringsdatum. Se Googles tillkännagivande av Gemini 4 Argon.
Jag skulle vänta på faktisk kontoåtkomst innan jag köper en prenumeration specifikt för Argon. En annonserad utrullning är något annat än en modell jag kan välja i dag, och Google har inte lovat något datum för tillgänglighet i Sverige i det tillkännagivandet.
Det starkaste skälet för mig att vara uppmärksam är möjligheten att slutföra längre uppgifter med mindre ingripande. Mitt användbara test kommer att omfatta befintlig kod, besvärliga affärsregler och belägg för att slutresultatet fungerar. Ett välformulerat svar räcker inte för att avgöra saken.
Priset för Gemini 4 Argon: introduktionspriset har en hake
Google annonserar $2 för input och $10 för output per miljon tokens. Prisnotisen anger det senare priset till $4/$20, utan att ange när introduktionsperioden tar slut. Cachad input får 95 % rabatt, vilket enligt beräkning ger ett introduktionspris på $0,10.
| Modell eller prisperiod | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Gemini 4 Argon, introduktion | $2 | $10 |
| Gemini 4 Argon, efter introduktionen | $4 | $20 |
| GPT-6.1 Sol, Standard | $2 | $10 |
| Claude Opus 5.5, Standard | $4 | $20 |
| GPT-6 Astra, Standard | $10 | $50 |
Källor: Googles tillkännagivande och utökade prisnotis, GPT-6.1 Sol model pricing, GPT-6 Astra model pricing och Claude Platform pricing.
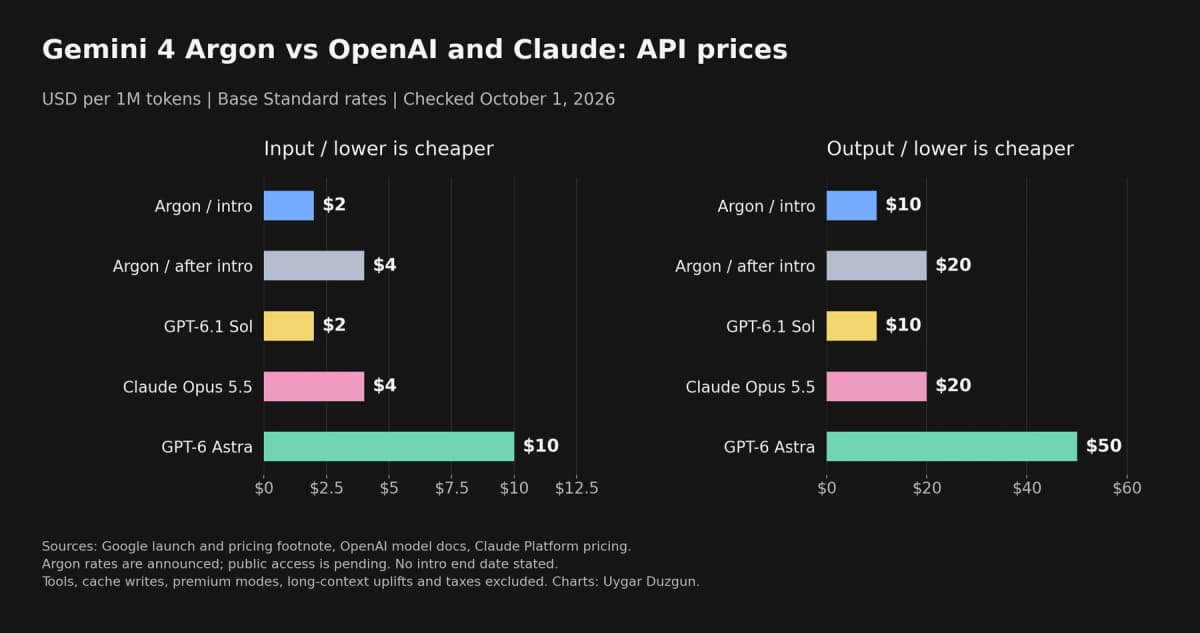
Grundpriser i USD kontrollerade den 1 oktober. Argons priser är annonserade priser, inte ett bevis på allmän API-åtkomst. Jämförelsen exkluderar verktyg, cache-skrivningar, premiumlägen, regionala avgifter och skatter.
Som ett enkelt budgetexempel skulle en miljon okachade input-tokens plus 100 000 output-tokens över flera förfrågningar med kort kontext kosta $3 med Argons introduktionspriser, $6 därefter, $3 med Sol, $6 med Opus och $15 med Astra. Det är aritmetik baserad på en fast tokenfördelning, inte en uppmätt arbetsbelastning. Samma uppgift kan förbruka olika antal tokens i olika modeller.
OpenAI höjer också priserna för hela förfrågningar över 272 000 input-tokens i en prompt; Anthropic anger standardpriser för hela kontextfönstret i Opus 5.5. En tabell med grundpriser kan därför inte tala om vad en enorm repository-session kostar. Min jämförelse av GPT-6.1 Sol och Opus 5.5 går igenom dessa avvägningar.
Jag skulle budgetera en integration utifrån Argons senare pris och sedan behandla kampanjen som en tillfällig besparing. Då undviker jag att bygga ett affärsunderlag kring en rabatt vars slutdatum jag ännu inte kan planera för.
Gemini 4 Argon-benchmarks: stark automation, blandad kodning
Affärsautomation är det resultat jag bryr mig mest om
Zapier's AutomationBench 1.0.6 testar arbete från början till slut över 47 verktyg inom sex affärsfunktioner. Testet kontrollerar den resulterande miljön med deterministiska påståenden i stället för att bedöma en agents övertygande slutmeddelande.
De valda konfigurationerna nedan behåller sina inställningar för arbetsinsats och sitt reservbeteende.
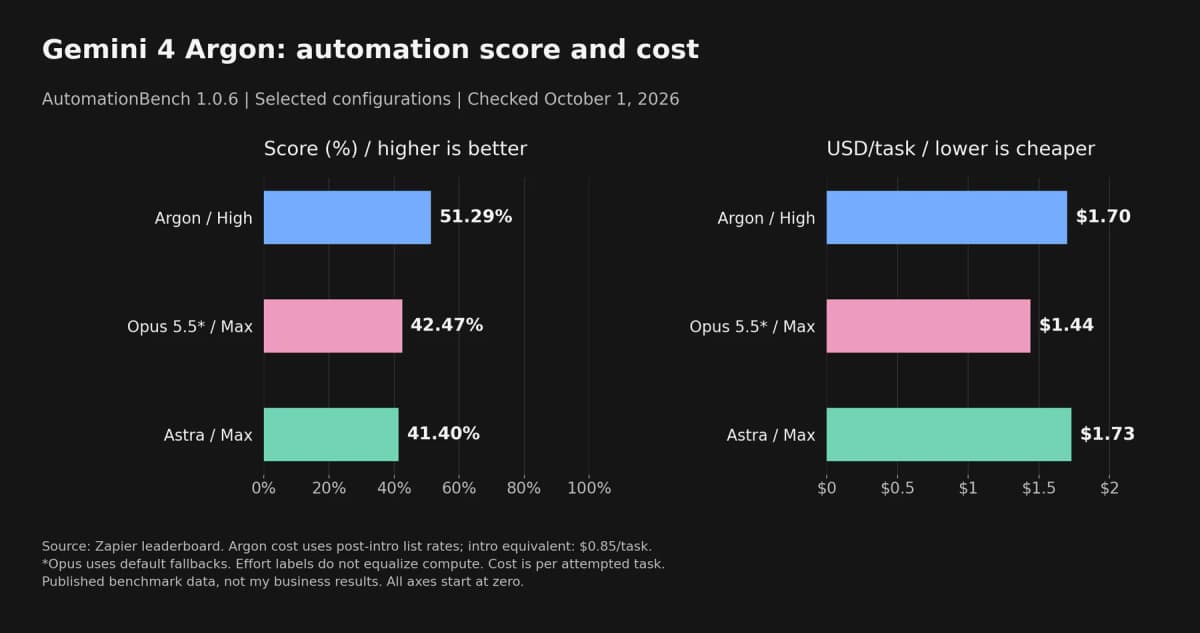
Zapier rapporterar 51,29 % för Argon High och $1,70 per försökt uppgift med senare listpriser; motsvarande introduktionspris är $0,85. Opus 5.5 Max med standardmässiga reservlösningar får 42,47 % till en kostnad på $1,44, och Astra Max får 41,40 % till $1,73. Etiketter för arbetsinsats motsvarar inte samma beräkningsbudgetar mellan leverantörer.
Argon har det högre resultatet i denna jämförelse, men den vanliga uppgiftskostnaden är inte den lägsta. Ett benchmarkresultat på ungefär 51 % motiverar inte heller obevakad åtkomst i produktion. Jag vill fortfarande ha godkännande kring konsekvensfyllda åtgärder, loggar som jag kan granska och ett sätt att återhämta mig från delvis slutförda uppgifter.
Den skillnaden spelar roll för affärsautomation. Jag bryr mig om att rätt post uppdateras och att rätt mottagare får ett meddelande. Att en agent säger att den är klar kan inte ersätta dessa kontroller.
Kodningsresultat beror på uppgiften
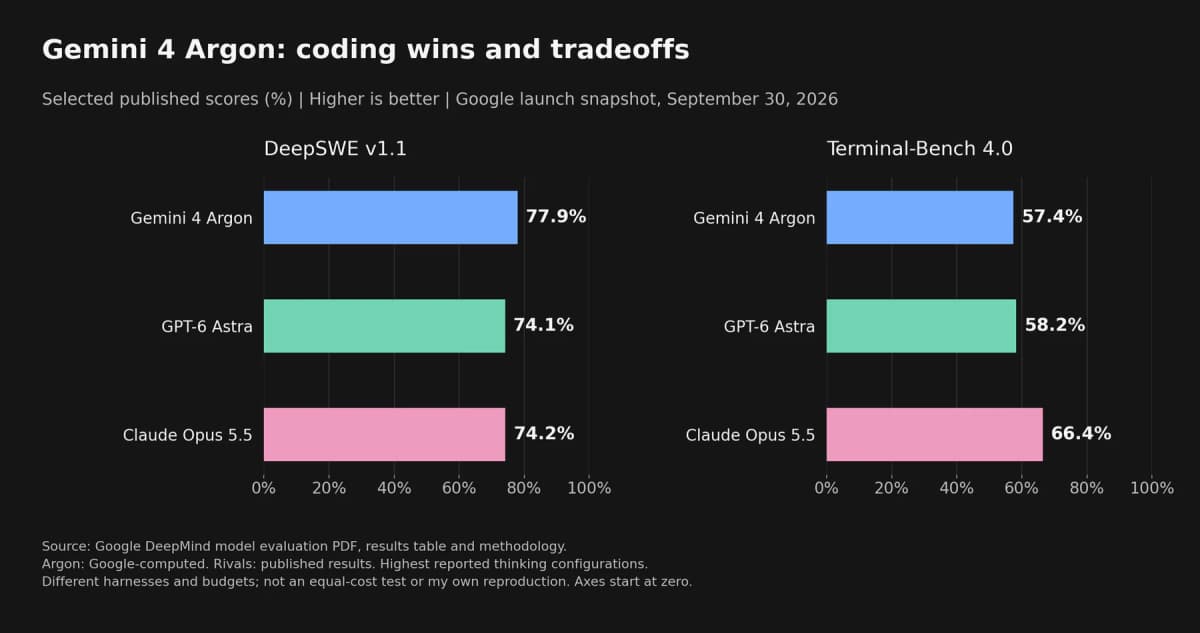
Utvalda resultat från Google DeepMinds model evaluation report. Detta kombinerar Argon-resultat beräknade av Google med publicerade resultat för konkurrenter, inte en enhetlig oberoende head-to-head-körning.
Argon når 77,9 % på DeepSWE v1.1, jämfört med Astras 74,1 % och Opus 74,2 %. På Terminal-Bench 4.0 leder Opus denna trio med 66,4 %, följt av Astra på 58,2 % och Argon på 57,4 %. Rapporten placerar också Astra före på FrontierSWE v2: 65,5 % jämfört med Argons 55,0 %.
Google rapporterar i allmänhet sina högsta inställningar för tänkande samt maximala eller bästa tillgängliga resultat för konkurrenterna. Testmiljöer och budgetar spelar roll. Ett försprång på ett repository-benchmark garanterar inte en bättre lösning i min kodbas, särskilt när skillnaden bara är några procentenheter.
Jag skulle testa en avgränsad regressionslagning och en ändring som omfattar flera filer separat. Båda behöver beteendekontroller och en granskning av diffen. En modell kan klara testet samtidigt som den lägger till en abstraktion som jag inte vill underhålla.
Oberoende belägg för kunskapsarbete ger mer sammanhang
Vals Index 2.1, uppdaterat den 30 september, listar Argon på 68,90 %, Opus 5.5 på 66,97 %, Astra på 63,13 % och Sol 6.1 på 61,15 %. Vals kombinerar uppgifter inom finans, kodning, juridik och skatt med sektorsvikter baserade på USA:s BNP.
Dess kostnadskolumn gör rankningen mer komplicerad: $15,68 per test för Argon med tokenpriser på $4/$20, jämfört med $3,24 för Sol. Det är kostnader specifika för benchmarken, inte offerter för mitt arbete. De visar varför jag skulle behålla en billigare modell i utvärderingen även om en annan modell toppar resultatkolumnen.
Jag skulle styra uppgifter efter mätning. Enkelt återkommande arbete och kostsamma fel bör inte automatiskt använda samma modell.
Vad säger andra om Argon?
Den tidiga diskussionen om lanseringen av Gemini 4 Argon innehåller entusiasm, frustration över begränsad åtkomst och påminnelser om det senare priset. Detta är lanseringsreaktioner från enskilda användare, inte en representativ undersökning eller belägg för att de alla har provat Argon. Kommentarer som förutspår veckor eller månader av väntan är spekulation.
Den mer användbara debatten för mig finns i Rust-communityts diskussion om Googles kodbasmigreringar. En kommentator, nicoburns, hävdar att översättning mellan språk kan fungera bättre eftersom den ursprungliga designen redan finns. Andra beskriver underhållsproblem och den tid de lägger på att korrigera genererad kod.
Den diskussionen gäller agentassisterad utveckling i stort. Den fastställer inte Argons tillförlitlighet i verkligheten. Jag tar den praktiska lärdomen på allvar: jämför beteendet med originalet, håll ändringarna möjliga att granska och mät hur mycket mänskligt arbete som återstår efteråt.
Så planerar jag att testa Gemini 4 Argon
Jag är tillräckligt nyfiken för att ge Google en ordentlig chans. Jag börjar med uppgifter som jag kan verifiera, i stället för att be modellen ta över allt på en gång.
Jag vill registrera förfluten tid, tokenkostnad, nya försök, korrekthet och granskningsarbete. Frågan är om Argon minskar mitt totala arbete, inklusive kontroll och reparation av resultatet.
Googles tillkännagivande höjer också output-gränsen till en miljon tokens. Det är ett tak, inte ett mål. Jag skulle fortfarande sätta budgetar och stoppvillkor; mer tillgängligt resonemang bör förtjäna sin kostnad. Min artikel om AI reasoning tokens and compute costs förklarar varför jag bryr mig om den avvägningen.
Gemini 4 Argon ser ut att vara värd att testa. Jag har inte använt Google tillräckligt mycket för att ge modellen en rättvis plats i mitt arbetsflöde ännu. Dessa resultat gör att jag vill ändra på det när jag får tillgång till modellen, samtidigt som jag behåller Sol, Opus och Astra som verkliga alternativ tills mina egna tester säger mer.