Jag använder Claude Haiku 5.5 för översättningar, snabba textändringar, korrigeringar och enklare deployarbete. Dessa uppgifter kräver en modell som följer en avgränsad instruktion och slutför arbetet utan att förvandla en liten ändring till ett projekt.
Inställningen för insatsnivå spelar roll eftersom dessa uppgifter inte är lika svåra. Att rätta ett stavfel och att översätta en sida med teknisk terminologi bör ha olika utgångspunkter.
Det här är del 1 av AI Models in Practice, en serie om att välja modeller för verkligt arbete. Exemplen nedan är återanvändbara prompts och föreslagna inställningar. Jag har inte genomfört en kontrollerad jämförelse av varje insatsnivå, och exempelöversättningarna är redaktionella exempel, inte inspelade Haiku-resultat. Modelluppgifter och priser kontrollerades mot Anthropic-dokumentationen den 12 oktober 2026.
Innehållsförteckning
Vad är Claude Haiku 5.5?
Claude Haiku 5.5 är Anthropic:s alternativ med liten modell för arbete med hög volym och tidskänslighet. Anthropic lanserade den den 7 oktober 2026 och positionerar den för sammanfattningar, klassificering, extrahering, routing och avgränsade subagentuppgifter. Claude API:s modell-ID är claude-haiku-5-5. Se lanseringsmeddelandet för Claude Haiku 5.5.
Modellöversikten för Haiku 5.5 listar text- och bildinmatning, textutmatning, ett kontextfönster på en miljon tokens och upp till 128 000 output-tokens i Messages API. Den använder adaptivt tänkande som standard. Ett stort kontextfönster beskriver kapacitet; det innebär inte att det är användbart eller ekonomiskt att skicka hela ditt repository.
Jag skulle ge Haiku ett tillhandahållet stycke, en ordlista och en exakt redigeringsuppgift innan jag bad den tolka ett helt företag. Den snävare instruktionen gör resultatet enklare att granska.
Vad är Haiku 5.5 bra för?
Min praktiska kortlista börjar med det arbete jag redan använder den för:
Andra uppgifter som är värda att utvärdera är att extrahera fält från ett tillhandahållet dokument, sortera meddelanden i kända kategorier och sammanfatta ett kort supportsamtal. Detta är föreslagna användningsområden, inte resultat från mitt eget benchmark.
För bredare ingenjörsarbete bör modellvalet granskas på nytt. Anthropic:s lanseringsmaterial rekommenderar Sonnet 5.5 och Opus 5.5 för mer komplex agentisk kodning. Att öka Haikus insatsnivå garanterar inte samma kapacitet som hos en större modell.
Vad betyder de fem insatsnivåerna?
Haiku 5.5 stöder low, medium, high, xhigh och max. Standardvärdet är medium. Insatsnivån styr hur mycket arbete modellen lägger på ett svar; den är inte en fast tokenbudget eller en garanti för korrekthet. Den påverkar tänkande, svarstext och tool calls. Se Anthropic:s dokumentation om insatsnivå.
| Insatsnivå | Officiell vägledning för start | Mitt föreslagna användningsområde |
|---|---|---|
low | Korta, enkla och latenskänsliga uppgifter | En stavningskorrigering eller en kort, entydig översättning |
medium | Standard för det mesta arbetet, inklusive avgränsad kodning | En normal översättning eller en liten textredigering med begränsningar |
high | Kunskapsarbete, längre agentuppgifter och strikt instruktionsföljande | Tvetydig terminologi eller en redigering som måste uppfylla flera regler |
xhigh | Använd när utvärderingar visar en kvalitetsvinst | Ett experiment på en svår, avgränsad uppgift; jämför med Sonnet |
max | Använd när utvärderingar motiverar den extra kostnaden | Ett exceptionellt testfall efter att lägre nivåer har kontrollerats |
Min startregel skulle vara medium, och därefter justera utifrån de fel du ser. För en trivial korrigering kan du prova low. För en översättning som är känslig för en ordlista kan du jämföra medium med high. Behåll prompten och indata oförändrade så att du kan avgöra om inställningen hjälpte.
En deploy kan bara omfatta ett enda kommando och ändå få betydande konsekvenser. Jag skulle välja krav på verifiering och godkännande oberoende av insatsnivå.
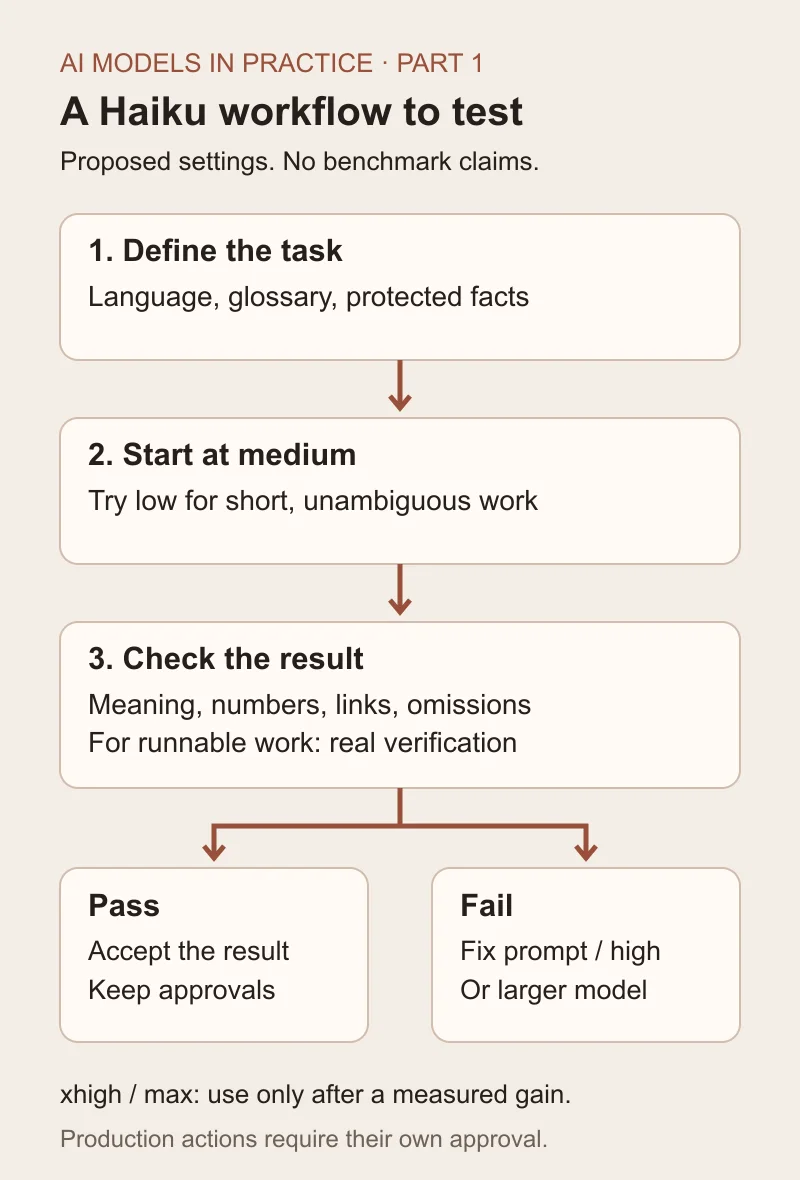
Föreslaget arbetsflöde, inte benchmarkbevis. Godkännande innebär att resultatet klarade kontrollerna för uppgiften; publicering och produktionsåtgärder behåller sina separata godkännandesteg.
Hur jag skulle ställa in insatsnivån för översättningar
Översättning är det tydligaste exemplet på varför en enda standardinställning inte kan täcka allt. Dessa inställningar är starthypoteser för utvärdering, inte uppmätta vinnare.
Low för kort, bokstavlig text
Ett kort statusmeddelande har liten tvetydighet:
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
En godtagbar redaktionell referens är: “Your order 1842 was dispatched on 12 October 2026.” De viktiga kontrollerna gäller ordernumret, datumet och betydelsen. Flera engelska formuleringar kan godkännas.
Jag skulle prova low här och sedan höja nivån om någon detalj försvinner. Att lägga till extra resonemang i denna prompt bör motiveras genom ett bättre resultat.
Medium för normal webbtext
För ett stycke skulle jag börja på medium och ange målgrupp, locale, ton och skyddade termer:
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
En redaktionell referens kan vara: “We normally update the page within two working days. It may take longer if we need additional information.” En version som lovar en uppdatering inom två dagar har ändrat påståendet.
Anthropic:s guide till flerspråkigt stöd rekommenderar att ange käll- och målspråk samt ta hänsyn till regional kontext. Den publicerade språktabellen omfattar äldre modeller, inklusive Haiku 4.5; den är inte bevis på Haiku 5.5:s översättningsprecision.
High när terminologi eller tvetydighet kräver uppmärksamhet
Vissa termer beror på verksamhetens kontext. Det svenska ordet “reklamation” bör inte automatiskt översättas till “advertising”. En lämplig engelsk formulering kan handla om ett klagomål eller ett krav gällande en defekt produkt, beroende på meningen.
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
Jag skulle jämföra medium och high för den här typen av uppgift. Framgångskriteriet är om översättningen bevarar villkoret och använder avsedd terminologi. Flytande formuleringar räcker inte.
För strukturerat innehåll skulle jag skicka översättningsbara strängar med stabila identifierare. Min applikation skulle kontrollera att varje identifierare returneras exakt en gång och att skyddade värden finns kvar. Att be en modell bevara en stor JSON-fil ersätter inte parsning och validering.
Snabba textändringar och korrigeringar
En korrigeringsprompt bör definiera vilka ändringar som är tillåtna. Annars kan en begäran om att rätta grammatiken förvandlas till en omskrivning.
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
Den redaktionella referensen är: “We have updated the page, but the payment tests are not finished yet.” En version som säger att sidan är helt testad misslyckas med uppgiften.
Low är en rimlig nivå att utvärdera för en sådan mening. Medium är min föreslagna startpunkt för flera stycken, skyddade länkar eller flera begränsningar.
För en textändring bör du be om det specifika resultatet: “Cut this to 80 words, preserve the two limitations, and retain the link.” Ordantal och bevarande av länkar är kontroller du kan köra oberoende av modellen.
Enklare deployarbete: definiera vad som räknas som klart
Jag räknar enkelt deployarbete bland mina användningsområden för Haiku, men “enkelt” behöver en uttrycklig avgränsning. En känd deployprocedur för en godkänd textändring är en annan uppgift än att diagnostisera en trasig release eller besluta hur en databas ska migreras.
En återanvändbar instruktion kan vara:
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
För förberedelser och kontroller skulle jag börja på medium. Om arbetet kräver att fel utreds över flera system skulle jag ompröva modell och insatsnivå i stället för att kalla det en enkel uppgift.
Anthropic:s Haiku-specifika guide till prompting påpekar att agenter med låg insatsnivå och långa prompts kan avsluta tidigt eller utelämna kontroller. Den rekommenderar uttryckliga verifieringsinstruktioner. Guiden nämner också tillfälliga tomma synliga svar i flerstegskonversationer på xhigh samt problem med tool calls när tänkande är avstängt tillsammans med strukturerad output. En integration bör upptäcka ofullständiga resultat i stället för att tyst acceptera dem.
Hur ändrar jag insatsnivån i Claude eller API:t?
I Claude-appen öppnar du modellmenyn bredvid skicka-knappen, väljer Haiku 5.5 och väljer sedan Effort. Tillgängliga alternativ kan bero på konto- eller administratörsinställningar. Anthropic uppger att tänkande inte kan stängas av för Haiku 5.5 i Claude-appen. Se Ändra inställningar för modell, insatsnivå och tänkande.
API:t ger mer direkt kontroll. En minimal request body ser ut så här:
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
Detta är en illustrativ request-struktur, inte en request jag har kört. Skicka stycket i user-meddelandet. max_tokens är en gräns, inte en reservation eller en instruktion att producera ett långt svar.
Anthropic:s migrationsguide för Haiku 5.5 förklarar att tänkande använder den output-budgeten, så en liten gräns kan kapa svaret innan synlig text visas. Välj response blocks utifrån deras type i stället för att anta att det första blocket innehåller svaret.
För nya API-requests ska du utelämna temperature, top_p och top_k. Ersätt den äldre konfigurationen med aktiverat tänkande och budget_tokens med adaptivt tänkande. API:t tillåter avstängt tänkande på low, medium och high; xhigh och max kräver adaptivt tänkande. Guiden listar också skillnader mellan providers, så validera din faktiska plattform innan migrering.
Behåll API-nyckeln på servern. Fältet för insatsnivå är konfiguration, inte ett skäl att lägga credentials i frontend-kod.
Vad kostar Haiku 5.5?
Anthropic:s dokumentation om API-priser listar följande standardpriser i USD per en miljon tokens, kontrollerade den 12 oktober 2026:
| Promptlängd | Input | Output | Cache read |
|---|---|---|---|
| Upp till 100 000 tokens | $0.10 | $0.50 | $0.01 |
| Över 100 000 tokens | $0.50 | $2.50 | $0.05 |
Den högre avgiften gäller för requesten, inklusive input som räknas som cache reads eller writes. Detta är API-tokenpriser; en Claude-prenumeration är en separat produkt. Cache writes, server tools och plattformsmodifierare kan medföra extra kostnader.
För en illustrativ uncached request med 2 000 input-tokens och 1 000 totalt debiterade output-tokens:
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
Beräkningen utesluter extra avgifter och är inte en uppmätt översättningskostnad. Räkna tänkande som debiterad output. Högre insatsnivå kan ändra tokenanvändningen, så pristabellen ensam kan inte förutsäga kostnaden för en slutförd uppgift.
Bästa praxis som jag skulle behålla för dessa uppgifter
Ge modellen den minsta kompletta uppgiften. Inkludera den ordlista eller godkända källtext den behöver och undvik orelaterat material.
Ange output-kontraktet. För en översättning ska du ange de två språken och locale. För en redigering ska du specificera vilka fakta och vilken formatering som måste bevaras. För en agent ska du definiera kontrollerna och stoppunkten.
Behandla källtext som innehåll som ska omvandlas. En mening som är inbäddad i ett dokument ska inte få behörighet att ändra uppgiften, komma åt credentials eller publicera innehåll.
Validera resultatet mot uppgiften. Kontrollera skyddade termer, siffror, länkar och saknade avsnitt. För kod- eller deployarbete ska du granska faktiska test- och runtime-bevis.
Eskalera utifrån ett konkret fel. En saknad begränsning tyder på en annan prompt eller insatsnivå. En uppgift som fortsätter att växa kan behöva Sonnet eller Opus. Upprepade fel bör utlösa en granskning, inte en ändlös ökning av insatsnivån.
Hur jag skulle testa inställningarna innan jag förlitar mig på dem
Jag skulle bygga ett litet utvärderingsset med 20 godkända, anonymiserade exempel: tio översättningar, fem korrigeringar och fem begränsade textredigeringar. Dessa antal beskriver ett föreslaget test, inte genomförd forskning.
Kör low, medium och high med samma indata och godkännandekriterier. Upprepa fallen för att synliggöra inkonsekvent beteende. Låt en flytande språkgranskare bedöma översättningarna utan att se inställningen.
Registrera exakt modell, insatsnivå, promptversion, förfluten tid, debiterade tokens och defekter. Räkna borttappade begränsningar, ändrade siffror, trasiga länkar, utelämnad text och onödiga omskrivningar. Jämför kostnad per godkänt resultat, inklusive reparationsarbete.
För deployassistans ska du utvärdera separata förberedelseuppgifter i en icke-produktionsmiljö med ett känt förväntat resultat. Produktionsåtgärder omfattas fortfarande av projektets godkännandeprocedur.
Min befintliga guide till benchmarking av AI-modeller för verkligt arbete→ beskriver den bredare utvärderingsmetoden. Jämförelsen mellan GPT-6.1 Sol och Opus 5.5→ ger kontext för val av större modeller; det är inte ett Haiku-test av översättning.
Serien börjar med de små uppgifterna
Haiku är den första delen eftersom översättningar, korrigeringar och korta redigeringar gör avvägningarna synliga. Du kan kontrollera om en mening behöll sin betydelse och om en länk överlevde.
De föreslagna kommande delarna behandlar Sonnet för daglig kodning och analys, Opus för svårare arbete och en avslutande guide till att routa uppgifter mellan modeller. Varje del kommer att använda samma åtskillnad: dokumenterade funktioner, min faktiska användning och tester som fortfarande återstår att genomföra.