A caixa-preta dos LLMs é um problema prático: um modelo pode responder a uma pergunta difícil em segundos, enquanto continuamos sem conseguir explicar quais computações internas produziram essa resposta. Em 15 de outubro de 2026, Nick Cammarata, coautor do estudo de 2023 da OpenAI sobre neurônios, publicou Neural Networks Are Already Clean como pesquisador da Goodfire. Ele argumenta que essa "caixa-preta" pode ser mais fácil de estudar do que o campo supunha. A afirmação merece atenção. Ela também precisa ser lida com cuidado: o ensaio é uma hipótese de trabalho, e seu artigo técnico complementar sobre neurônios de modelos de linguagem ainda será publicado.
A pergunta útil é se os pesquisadores conseguem passar de uma descrição interessante de um neurônio para uma explicação confiável do comportamento de um modelo. Cammarata oferece novas evidências para o primeiro passo e várias demonstrações causais do segundo. Nenhuma delas equivale a um mapa completo de um large language model.
Para um resumo em linguagem simples, vá para a versão simples.
Por que a caixa-preta dos LLMs persiste?
Os pesquisadores conhecem as operações matemáticas de uma rede treinada. A parte difícil é explicar como milhões de componentes aprendidos se combinam para produzir uma resposta específica. Um único neurônio artificial pode ser ativado por exemplos que parecem não ter relação. Se ele responde tanto ao rosto de um gato quanto à dianteira de um carro, o que ele realmente representa?
Uma resposta influente foi a superposição: um modelo pode compactar características não relacionadas em direções internas sobrepostas porque tem espaço limitado. Os pesquisadores então treinam um segundo modelo, geralmente um autoencoder esparso, para separar essas características.
Cammarata argumenta que parte das evidências clássicas para essa visão foi interpretada de forma equivocada. A mistura aparente pode, em vez disso, refletir um padrão compartilhado, um microscópio imperfeito ou uma arquitetura de rede que tornou as camadas posteriores mais difíceis de treinar. A definição de superposição usada por ele é especificamente a compactação de computações não relacionadas no mesmo mecanismo; outros pesquisadores usam a palavra de forma mais ampla, para representar mais conceitos do que há dimensões. O ensaio dele explica essa distinção.
O que mudou na nova pesquisa?
O conhecido neurônio do gato e do carro veio de um modelo de visão, não de um LLM. Cammarata agora o descreve como um neurônio que responde a um padrão visual compartilhado em forma de V. Segundo sua explicação, o neurônio agrupa uma estrutura visual relacionada, em vez de esconder dois conceitos arbitrários em um único espaço. Ele também relata que, após mudanças arquiteturais no InceptionV1, um modelo de visão, 99–100% dos neurônios em sua camada final se tornaram fáceis de interpretar, enquanto o tamanho do modelo e os dados de treinamento permaneceram fixos. Essa é uma afirmação sobre uma camada de um modelo de visão retreinado. Não é uma estatística sobre modelos de chat modernos.
As evidências sobre modelos de linguagem são mais relevantes para LLMs e mais preliminares. A equipe da Goodfire estima que, em uma auditoria inicial do Qwen3-32B, cerca de 90% dos polos dos neurônios têm uma função principal, geralmente com pequenas ramificações relacionadas. Outros aproximadamente 7% têm duas funções relacionadas, e cerca de 2–4% continuam sem explicação.
Um "polo" se refere a um dos lados da resposta positiva ou negativa de um neurônio; a porcentagem não significa que 90% do comportamento de um LLM tenha sido explicado. Cammarata afirma que a classificação muda conforme o limite para ativações fracas, a profundidade do modelo, a densidade dos circuitos e o que é considerado uma única função. Essas ressalvas aparecem ao lado da estimativa.
A equipe oferece mais do que rótulos para ativações. Seu ensaio interativo inclui 1.000 estudos de caso de neurônios selecionados aleatoriamente do Qwen3-32B e do Qwen3.6-35B-A3B. Em um teste, um agente usou explicações escritas para inventar exemplos que deveriam ativar um neurônio e quase-exemplos que não deveriam. Entre 183 neurônios com explicações para seu lado positivo, os novos exemplos ativaram fortemente o neurônio em 76% das vezes, contra 11% para os quase-exemplos. Esse é um teste de previsão útil dentro da configuração da equipe. Ele não estabelece que as descrições capturem toda ativação importante ou todo efeito posterior.
Os pesquisadores conseguem mudar a resposta de um LLM intervindo nele?
Sim, em exemplos selecionados. A Goodfire rastreia grupos de neurônios do Qwen3-32B e depois os remove para observar o que muda. Em um prompt cujas pistas apontavam para o Papai Noel, remover oito neurônios selecionados associados à resposta reduziu a probabilidade informada pelo modelo para "Santa" a 0,059; remover o mesmo número de neurônios aleatórios das camadas correspondentes manteve o valor em 0,997. Isso é uma evidência de que os neurônios selecionados foram importantes para aquele prompt e para a previsão da próxima palavra. Não é uma taxa de sucesso medida em prompts ou modelos arbitrários. A intervenção e o controle são mostrados no ensaio original.
Cammarata também mostra um grafo de atribuição baseado em neurônios para o Kimi K3, um modelo com vários trilhões de parâmetros. O exemplo da carteira acompanha alguns caminhos do prompt até uma resposta sobre devolver um objeto perdido. O ensaio chama os grupos exibidos de uma fatia escolhida manualmente e afirma que auditorias completas nessa escala ainda não começaram. Uma fatia legível de um modelo muito grande é promissora, mas não pode nos dizer o que cada caminho omitido fez.
Como outros pesquisadores estão reagindo?
Em 17 de outubro, o pesquisador Leo Gao publicou Neural networks are not already clean. Ele concorda que trabalhos anteriores podem ter classificado neurônios como polissêmicos rápido demais.
A objeção dele é que uma descrição organizada dos exemplos mais fortes ainda pode deixar de fora entradas que deveriam ativar o neurônio, respostas fracas que são importantes ou a relevância da intensidade da ativação. Gao propõe um teste mais rigoroso: substituir os valores do neurônio por valores previstos a partir da explicação e então medir se o restante do modelo continua se comportando da mesma forma. Se o comportamento se deteriorar, a explicação deixou passar algo importante.
A resposta direta de Neel Nanda faz uma distinção relacionada. Ele vê valor prático em usar neurônios nativos e grafos de atribuição para investigar um comportamento suspeito específico. Ele continua sem se convencer de que isso prove que a engenharia reversa ambiciosa está próxima e destaca especialmente as ativações fracas em LLMs e as informações no fluxo residual. O próprio Cammarata afirma que a atenção é menos compreendida neste trabalho e que modelos de linguagem enormes estão longe de ser completamente mapeados.
A discordância é produtiva. A Goodfire pergunta se os próprios componentes da rede podem ser o ponto de partida para a interpretação. Gao e Nanda perguntam quanto uma explicação precisa prever antes que possamos confiar nela. Um neurônio pode parecer legível, participar causalmente de uma resposta e ainda assim ter comportamentos importantes que não capturamos.
Duas outras reações tornam o ônus da prova mais claro. Na mesma discussão pública, John Wentworth pede uma explicação neurônio por neurônio do modelo de visão ConvNeXt apresentado, com as evidências para cada interpretação. Ele afirma que o microscópio público, por si só, não tornou imediatamente claros para ele os significados daqueles neurônios. Isso é um pedido por um artefato inspecionável, não um teste que refute as descobertas sobre LLMs. Alex Gibson aponta para uma lacuna diferente: o ensaio chama sua maior conclusão de altamente especulativa, enquanto algumas publicações curtas nas redes sociais soam mais certas. Essas são respostas individuais iniciais, não um veredito de todo o campo.
Isso torna um sistema de AI seguro ou transparente?
Nenhum certificado de segurança decorre desses resultados. Uma explicação de um neurônio é uma afirmação local. Um grafo de atribuição é um relato parcial de uma computação. Uma afirmação de garantia no nível do sistema exigiria cobertura dos circuitos importantes, testes confiáveis contra comportamentos não capturados e evidências de que o método funciona além dos exemplos escolhidos para inspeção. Para um sistema que usa ferramentas, as permissões de agentes de AI→ ainda precisam limitar o que o modelo pode fazer, independentemente de quão legíveis seus circuitos internos se tornem.
O artigo técnico da Goodfire sobre modelos de linguagem e uma replicação independente serão importantes nesse ponto.
Também existe um limite de acesso. Esses experimentos inspecionam ativações internas e intervêm em componentes. Se seu produto apenas chama uma chat API hospedada, você não pode executar os mesmos testes nesse modelo por meio de prompts comuns.
A versão simples
Uma pergunta entra em um modelo de AI, e uma resposta sai. A parte difícil é saber o que aconteceu lá dentro.
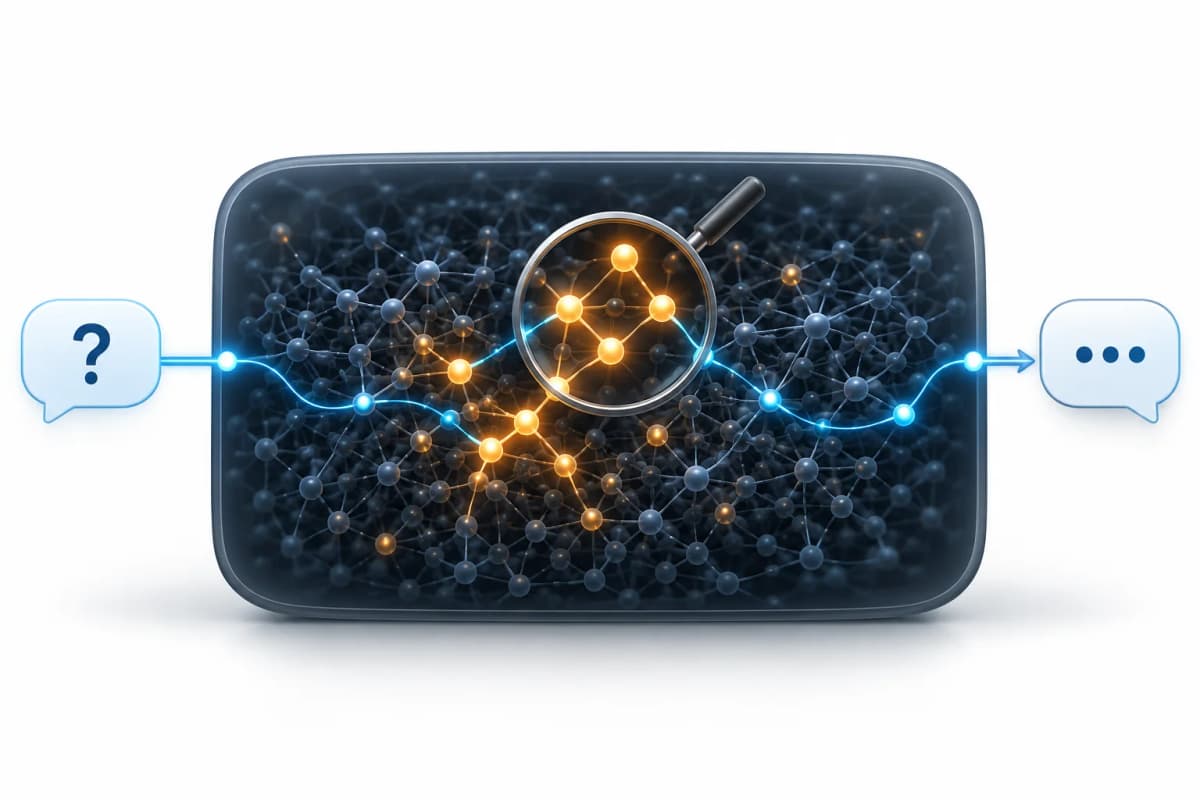
O que aconteceu: A Goodfire examinou pequenas partes de um modelo de linguagem chamadas neurônios. Em testes selecionados, os pesquisadores conseguiram descrever a função de alguns deles e mudar uma resposta removendo-os.
Por que isso importa: O funcionamento interno do modelo pode ser mais fácil de investigar do que muitos pesquisadores esperavam.
O que isso não significa: Ainda não conseguimos explicar todas as respostas nem chamar o modelo de seguro. Se você desenvolve usando APIs de AI comuns, continue testando as saídas e limitando o que a AI pode fazer. Estudos futuros podem levar a ferramentas melhores para depurar e monitorar modelos.
O que isso significa para produtos de AI hoje?
Para os fluxos de trabalho de agentes e conteúdo que desenvolvo, esse resultado não nos oferece um novo botão para ativar. O trabalho imediato é testar as tarefas que os usuários realmente executam, verificar fontes e afirmações factuais, registrar o comportamento do modelo e das ferramentas, restringir permissões de ferramentas e exigir aprovação humana antes de ações externas com consequências. Esses controles lidam com falhas observáveis, independentemente de os neurônios do modelo serem legíveis.
Ainda é possível avaliar o comportamento externo de um modelo hospedado. Meu guia anterior sobre calibração de confiança em LLMs→ aborda uma dessas tarefas: verificar se uma pontuação acompanha a correção no seu próprio trabalho. Isso mede uma questão diferente da interpretabilidade mecanicista, e ambas exigem limites claros.
Antes de adotar um monitor interno, eu perguntaria qual comportamento ele detecta em tarefas reservadas, com que frequência deixa passar casos prejudiciais ou interrompe casos benignos, se atua antes de uma chamada de ferramenta e se o provedor realmente expõe as ativações necessárias. Saídas comuns de API não respondem a essas perguntas.
O que pode mudar no longo prazo?
Se outras equipes reproduzirem as descobertas sobre neurônios e conseguirem rastrear os caminhos importantes entre eles, os desenvolvedores de modelos poderão diagnosticar falhas no nível do mecanismo, em vez de estudar apenas as saídas. Cammarata também apresenta agentes de pesquisa automatizados e a alteração cuidadosa de um ambiente de treinamento que se prove prejudicial como possíveis passos futuros. Essas são propostas a serem testadas, não capacidades estabelecidas por este ensaio.
Uma direção relacionada já tem um exemplo concreto. Em um estudo separado da Goodfire sobre o Kimi K3, uma sonda de ativação alimenta um segundo modelo que avalia se deve interromper uma interação arriscada de um agente. A Goodfire relata resultados promissores em suas próprias avaliações. Esse monitor precisa de acesso às ativações internas, e o estudo não valida as explicações de neurônios de Cammarata. Ele mostra o que sinais no nível do modelo podem oferecer futuramente a um provedor ou a uma implantação com pesos abertos; um cliente de API precisaria de um serviço exposto e de sua própria avaliação específica para a tarefa.
Uma visibilidade interna melhor poderia ajudar nas revisões de segurança e também tornar o desenvolvimento de modelos mais rápido. O equilíbrio é desconhecido. Um padrão futuro útil perguntaria aos provedores quais comportamentos suas explicações internas cobrem, onde elas falham e se um monitor melhora em relação a verificações baseadas apenas nas saídas em fluxos de trabalho realistas.
O que devemos acompanhar a seguir?
Eu procuraria cinco evidências no artigo técnico prometido e nos trabalhos de acompanhamento:
Minha leitura é que a Goodfire apresentou um caso convincente para examinarmos com mais atenção os neurônios nativos de um modelo. Ela também ofereceu aos pesquisadores experimentos melhores para discutir. Em 17 de outubro de 2026, a conclusão mais forte é mais restrita do que dizer que "a caixa-preta dos LLMs foi resolvida": algumas partes podem ser mais legíveis do que o esperado, e o caminho entre partes legíveis e explicações confiáveis do modelo inteiro continua em aberto. Para equipes que desenvolvem sobre APIs hospedadas, testes de comportamento e limites de permissões continuam sendo o ponto de partida prático.
Fontes principais: ensaio de pesquisa de Cammarata, resposta de Gao, discussão direta entre pesquisadores e estudo separado da Goodfire sobre monitoramento por ativações.