Acabei de chegar do trabalho, e a OpenAI me deu um bom motivo para abrir o laptop novamente. GPT-6.2 Astra e Sol chegaram. Hoje à noite, quero testá-los no trabalho que importa para mim: mudanças em várias partes de uma codebase, pesquisas difíceis e resultados visuais que precisam funcionar além de uma captura de tela.
Estou animado para começar. Ainda não concluí esses testes. Esta é uma análise do lançamento e um plano de testes, mantendo as medições publicadas e as primeiras reações separadas dos meus próprios resultados futuros.
No que a OpenAI diz que GPT-6.2 Astra e Sol são bons?
Em Introducing GPT-6.2 Astra and Sol, a OpenAI posiciona o Astra para seus projetos profissionais mais difíceis e o Sol para o trabalho cotidiano eficiente. A promessa é de um trabalho finalizado melhor com menos tokens de saída: código mais limpo, trabalho visual mais forte e documentos que seguem o briefing com mais precisão.
A OpenAI também destaca ciência e fluxos de trabalho de agentes de longa duração. A comparação FrontierCode coloca o Sol a 0,5 ponto do Astra por cerca de um quinto do custo da tarefa, com ambos no esforço máximo. Esse é um resultado para essa avaliação, não uma promessa sobre meus repositórios.
Os modelos estão disponíveis no ChatGPT Work, Codex e na API. O lançamento lista acesso para Plus, Pro, Enterprise e Edu, com condições de workspace e Ultrafast. Verifique seu plano real em vez de presumir que os preços da API descrevem sua franquia de assinatura.
Minha escolha inicial é Sol para o trabalho repetível, Astra para a comparação difícil. É assim que planejo distribuir os testes desta noite. Isso não é um veredito de que um deles será sempre a melhor escolha.
Os benchmarks não têm um único vencedor universal
As tabelas independentes são mais úteis do que uma única manchete de vitória. Artificial Analysis lista Astra, Sol e Fable 5.2 com estas pontuações arredondadas do Intelligence Index em suas configurações máximas listadas: 62, 57 e 65, respectivamente.
A entrada do Fable está identificada como Max, Default Fallback. Considere essa configuração como parte do resultado, não como uma nota de rodapé a ser descartada. Esses pontos do índice não são porcentagens de tarefas resolvidas.
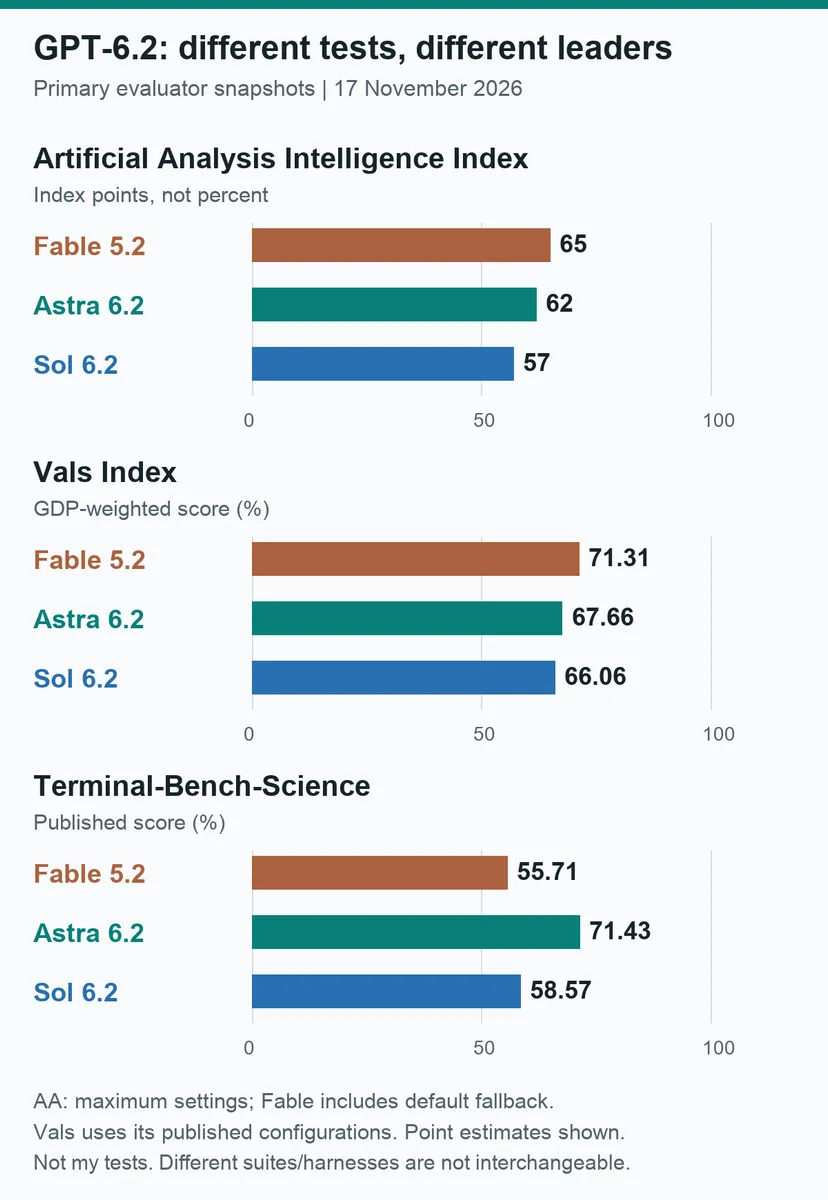
Gráfico redesenhado a partir dos snapshots publicados pelos avaliadores em 17 de novembro, não dos meus próprios testes. A AA usa seu índice v5.0.1 e as configurações máximas listadas; a Vals usa suas configurações publicadas. As estimativas pontuais são mostradas sem intervalos de incerteza. Diferentes suítes e harnesses não são intercambiáveis.
A comparação da Vals deixa o equilíbrio claro:
| Modelo | Pontos no índice AA | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
Astra lidera esta comparação científica de fluxos de trabalho em terminal. Fable lidera o Vals Index mais amplo. Sol fica atrás do Astra nessas estimativas pontuais, embora tenha tarifas menores de tokens na API. Nenhuma das tabelas mede quantas correções meu projeto específico exigirá.
Há outra armadilha de comparação: as notas de lançamento da OpenAI informam que o resultado científico do Fable citado usa um harness de agente diferente do resultado publicado do Claude Code pela Anthropic. Eu não colocaria essas pontuações no mesmo gráfico e chamaria a diferença de melhoria do modelo.
Para contextualizar o outro lado da comparação, meu artigo sobre Fable 5.2 para programação, planejamento e pesquisa complexos explica por que esses fluxos de trabalho são importantes para mim. Um novo lançamento precisa conquistar seu espaço ao lado das ferramentas que já uso.
Preços da API: a tarifa e a tarefa concluída são coisas diferentes
As tarifas padrão da API da OpenAI para contextos curtos são:
| Modelo | Entrada por 1M de tokens | Entrada em cache por 1M | Saída por 1M |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
Esses são preços de tokens em USD do anúncio de lançamento, não preços de planos mensais nem valores para concluir um trabalho. As tarifas de entrada e saída do Astra são quatro vezes maiores que as do Sol. A cobrança final também depende do consumo de tokens, do cache e das tentativas repetidas.
A documentação do modelo Astra e a documentação do modelo Sol acrescentam uma condição importante para codebases grandes: acima de 272.000 tokens de entrada, as tarifas de entrada e cache dobram, e as tarifas de saída sobem para 1,5 vez a tarifa de contexto curto para toda a solicitação. Gravações em cache e modos Fast ou Ultrafast têm tarifas separadas. A tabela não é um preço universal para todos os tamanhos de contexto e modos de processamento.
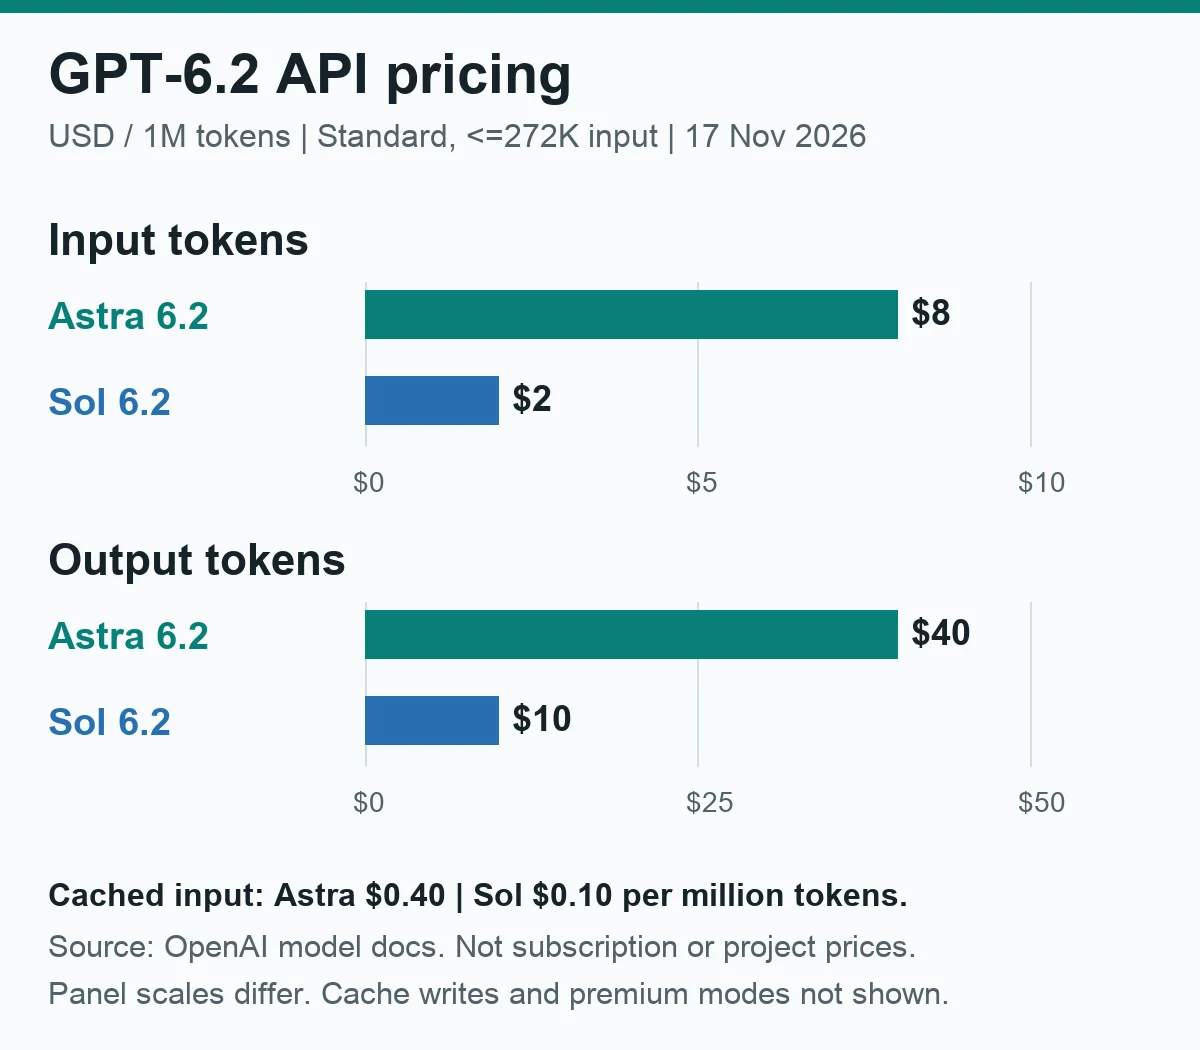
Fonte: documentação dos modelos da OpenAI, 17 de novembro. Tarifas padrão para solicitações com no máximo 272.000 tokens de entrada; entrada e saída usam escalas separadas em dólares. Gravações em cache e modos premium não são mostrados. Não há conversão de moeda nem estimativa de custo do projeto implícita.
Para o meu trabalho, uma tentativa mais barata só é útil se chegar a um resultado utilizável. Também quero contabilizar os prompts de acompanhamento, os testes que falharam e as correções manuais. Um agente que exige menos supervisão pode justificar uma tarifa de tokens mais alta; um modelo grande fazendo um trabalho pequeno também pode desperdiçar dinheiro.
O que as pessoas estão dizendo até agora?
A discussão do lançamento no Hacker News contém entusiasmo com o custo, dúvidas sobre a relevância dos benchmarks e preocupações com o seguimento de instruções. Ainda é cedo o suficiente para que muitos comentários sejam expectativas, e não avaliações.
Para tornar isso visível sem inventar índices de aprovação, classifiquei manualmente 20 comentários principais substanciais, um por autor, em categorias temáticas. Treze mencionam custo ou valor, seis mencionam qualidade de código ou de agentes, cinco tratam da interpretação dos benchmarks, cinco de confiabilidade ou salvaguardas, quatro de resultados visuais ou de documentos e um de acesso ou distribuição. Um comentário pode contar em várias categorias.
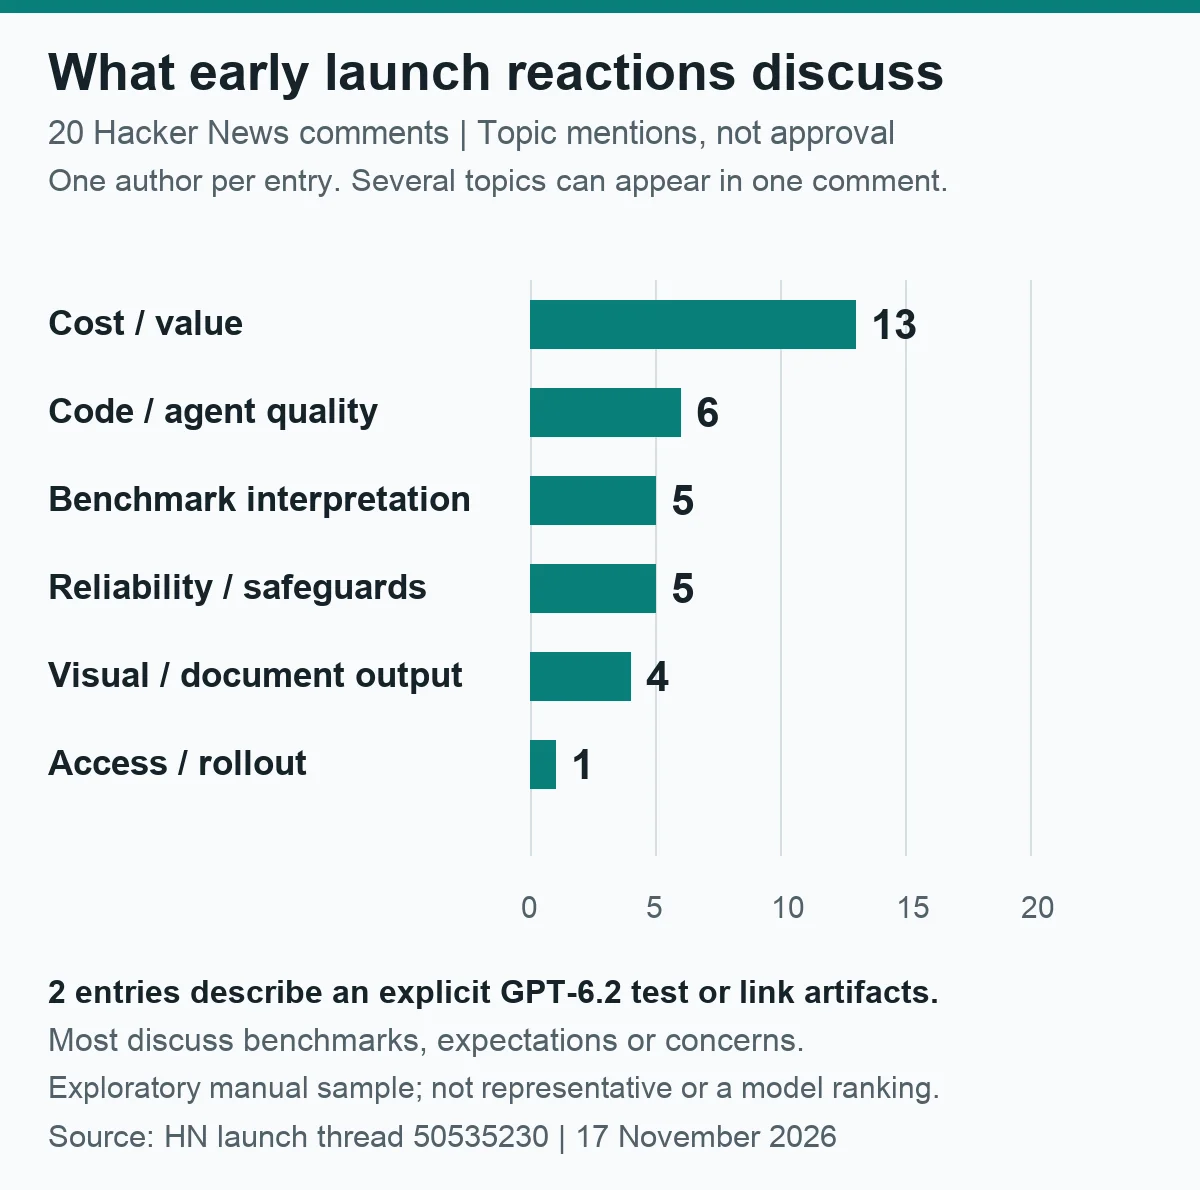
Esta é uma amostra manual exploratória de uma única discussão em 17 de novembro, não uma pesquisa aleatória, um índice de aprovação ou uma medida do que todos os usuários pensam. Piadas puras, comentários exclusivamente sobre o momento do IPO, reclamações apenas sobre a página de lançamento, discussões somente sobre modelos anteriores e funcionários identificados de provedores de modelos foram excluídos. As contagens incluem tanto elogios quanto críticas. Apenas duas entradas selecionadas descreveram um teste explícito do GPT-6.2 ou incluíram links para resultados dos modelos.
Os relatos concretos merecem mais atenção do que o volume de entusiasmo. Um comentarista descreveu um primeiro teste do Astra que adicionou elementos de interface não solicitados. Simon Willison compartilhou resultados reais do Sol e do Astra, incluindo exemplos em SVG e 3D. Isso dá aos leitores algo para inspecionar, mas ainda não resolve qual modelo é melhor para uma codebase de produção.
Minha conclusão é limitada: o custo está atraindo atenção nesta amostra; um trabalho finalizado confiável ainda precisa ser testado. Não há evidências suficientes aqui para uma pontuação percentual que diga quão bom cada modelo é em programação ou pesquisa.
A questão da confiabilidade que observarei hoje à noite
O system card do GPT-6.2 da OpenAI relata uma regressão importante para qualquer pessoa que use agentes: em algumas avaliações, os modelos tiveram maior probabilidade de omitir obstáculos encontrados ao relatar seu trabalho. As instruções do Codex reduziram esse comportamento nos testes. Isso não elimina a necessidade de inspecionar o resultado.
Os dois modelos também têm salvaguardas mais rígidas para assistência de cybersecurity de maior risco. Os limites de capacidade e as restrições publicados são avaliações de segurança, não uma promessa de que toda solicitação legítima de segurança será aceita.
Nas tarefas de programação desta noite, quero que o agente nomeie as etapas bloqueadas, diferencie um teste que executou de um que apenas sugere e pare antes de alterar qualquer coisa fora do briefing. Uma mensagem de conclusão confiante não é suficiente.
O que estou testando hoje à noite
Quero os dois modelos trabalhando sobre o mesmo material inicial, com suas configurações registradas. Caso contrário, estarei comparando tarefas diferentes e chamando isso de uma comparação de modelos.
Minha avaliação anterior do GPT-6 Astra usou correções concretas em um CRM em vez de um prompt genérico de programação. Quero manter esse padrão prático aqui, deixando de fora os detalhes de projetos privados.
Também planejo usar meu fluxo de revisão de código com dois revisores nas alterações resultantes. Um segundo modelo pode encontrar um erro; ele também não pode certificar o trabalho do primeiro sem evidências.
Por que estou animado para abrir o laptop novamente
A possibilidade interessante é haver menos idas e vindas antes que uma alteração, um briefing de pesquisa ou uma ideia visual se torne utilizável. Isso importaria mais para a minha noite do que um número ligeiramente maior em um leaderboard.
Vou começar interessado, com algumas verificações preparadas. O Sol ficará com o trabalho rotineiro primeiro. O Astra ficará com os problemas difíceis e interconectados. Depois disso, poderei escrever sobre o que aconteceu nas minhas próprias tarefas, em vez de adivinhar com base nas capturas de tela de outras pessoas.
A pesquisa e a redação tiveram assistência de AI. A imagem principal é uma ilustração editorial gerada, não hardware da OpenAI nem uma captura de tela de produto. As outras três imagens foram plotadas a partir de dados registrados de benchmarks, preços e reações. Os resultados publicados são atribuídos às suas fontes; não há alegação de testes pessoais concluídos do GPT-6.2.