Passei muito menos tempo com os modelos do Google do que com as outras ferramentas de AI no meu fluxo de trabalho. Gemini 4 Argon me dá um motivo para mudar isso. Os resultados de automação empresarial parecem úteis, e o preço introdutório anunciado fica ao lado do GPT-6.1 Sol, em vez de ser o de um modelo exclusivamente premium.
Quero testá-lo quando o acesso for liberado. Por enquanto, esta é uma análise das evidências publicadas, dos preços e das primeiras reações, não uma avaliação prática do Argon.
Verificação da fonte: 1º de outubro de 2026. A capa é uma arte editorial gerada por AI. Os gráficos abaixo reproduzem resultados numéricos citados; não são capturas de tela dos meus próprios testes.
O que é o Gemini 4 Argon e já posso usá-lo?
O Google anunciou o Argon em 30 de setembro de 2026, inicialmente para defensores cibernéticos confiáveis por meio do Fairwind. O acesso mais amplo começará com clientes pagos da API e assinantes do Google AI Ultra; o anúncio não informa uma data pública definitiva de lançamento. Veja o anúncio do Gemini 4 Argon pelo Google.
Eu esperaria o acesso efetivo à conta antes de comprar uma assinatura especificamente para o Argon. Um lançamento anunciado é diferente de um modelo que posso selecionar hoje, e o Google não prometeu uma data de disponibilidade na Suécia nesse anúncio.
O principal motivo para eu prestar atenção é a possibilidade de concluir tarefas mais longas com menos intervenção. Meu teste útil envolverá código existente, regras empresariais complicadas e evidências de que o resultado final funciona. Uma resposta bem elaborada, sozinha, não será suficiente para decidir.
Preço do Gemini 4 Argon: a tarifa introdutória tem uma ressalva
O Google anuncia US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. A nota de rodapé de preços define a tarifa posterior em US$ 4/US$ 20, sem informar a data de término do período introdutório. A entrada em cache recebe um desconto de 95%, resultando, por cálculo, em uma tarifa introdutória de US$ 0,10.
| Modelo ou período de preços | Entrada / 1 milhão de tokens | Saída / 1 milhão de tokens |
|---|---|---|
| Gemini 4 Argon, introdutório | US$ 2 | US$ 10 |
| Gemini 4 Argon, após a introdução | US$ 4 | US$ 20 |
| GPT-6.1 Sol, Standard | US$ 2 | US$ 10 |
| Claude Opus 5.5, Standard | US$ 4 | US$ 20 |
| GPT-6 Astra, Standard | US$ 10 | US$ 50 |
Fontes: anúncio do Google e nota de rodapé expandida sobre preços, preços do modelo GPT-6.1 Sol, preços do modelo GPT-6 Astra e preços da Claude Platform.
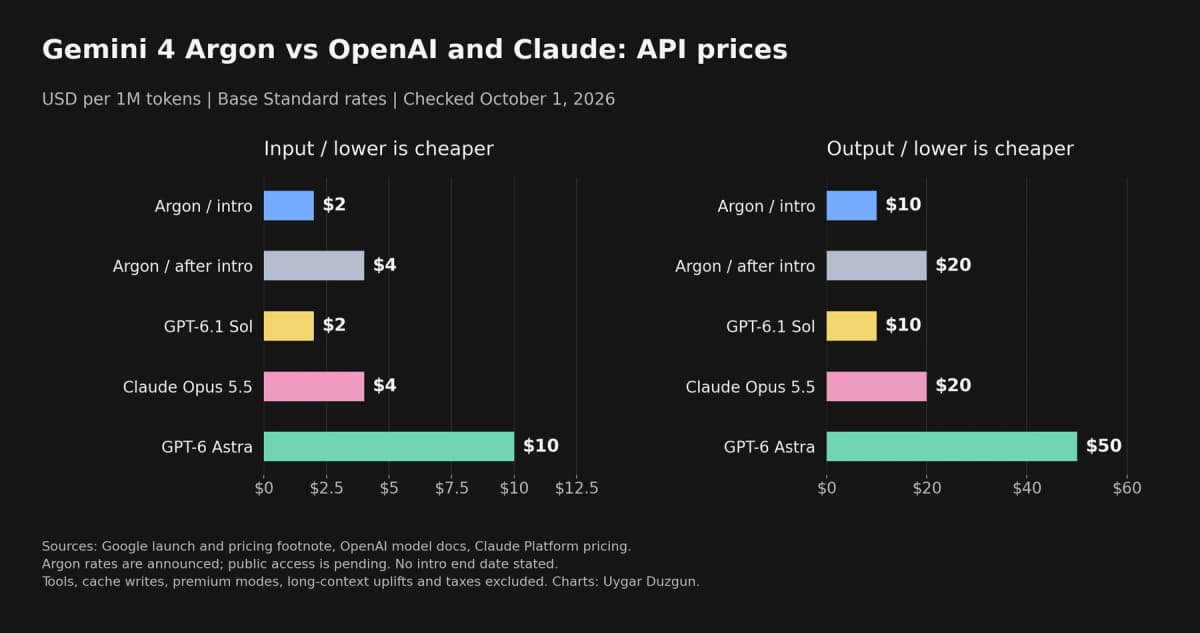
Tarifas-base em USD verificadas em 1º de outubro. Os preços do Argon são tarifas anunciadas, não uma prova de acesso geral à API. A comparação exclui ferramentas, gravações em cache, modos premium, cobranças regionais e impostos.
Em um exemplo simples de orçamento, um milhão de tokens de entrada sem cache mais 100.000 tokens de saída distribuídos por várias solicitações curtas custariam US$ 3 com as tarifas introdutórias do Argon, US$ 6 depois, US$ 3 com o Sol, US$ 6 com o Opus e US$ 15 com o Astra. Isso é uma operação aritmética usando uma combinação fixa de tokens, não uma carga de trabalho medida. A mesma tarefa pode consumir quantidades diferentes de tokens em modelos diferentes.
A OpenAI também aumenta os preços de solicitações completas acima de 272.000 tokens de entrada em um único prompt; a Anthropic lista preços padrão em toda a janela de contexto do Opus 5.5. Portanto, uma tabela de preços-base não consegue informar a conta de uma sessão com um repositório enorme. Minha comparação entre GPT-6.1 Sol e Opus 5.5 aborda essas compensações.
Eu faria o orçamento de uma integração usando a tarifa posterior do Argon e trataria a promoção como uma economia temporária. Isso evita construir um caso de negócio em torno de um desconto cuja data de expiração ainda não consigo programar.
Benchmarks do Gemini 4 Argon: automação forte, programação mista
Automação empresarial é o resultado que mais me importa
O AutomationBench 1.0.6 da Zapier testa trabalho de ponta a ponta em 47 ferramentas de seis funções empresariais. Ele verifica o ambiente resultante com asserções determinísticas, em vez de avaliar a mensagem final persuasiva de um agente.
As configurações selecionadas abaixo mantêm suas definições de esforço e seu comportamento de fallback.
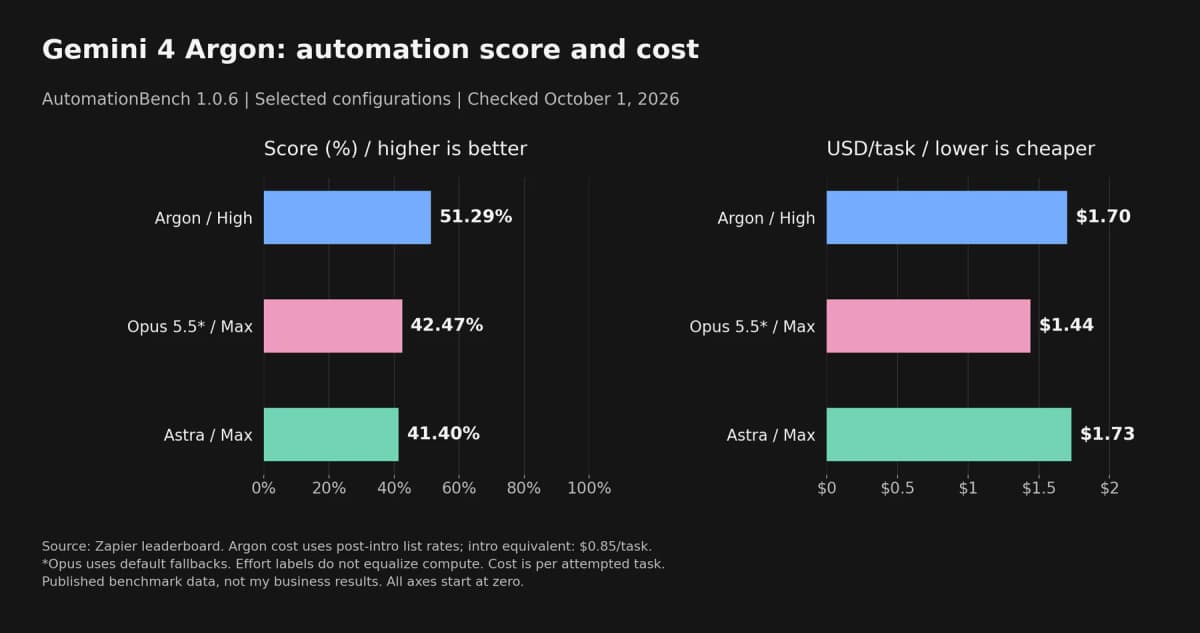
A Zapier informa que o Argon High alcança 51,29% e custa US$ 1,70 por tarefa tentada usando as tarifas de lista posteriores; seu equivalente introdutório custa US$ 0,85. O Opus 5.5 Max, com fallbacks padrão, alcança 42,47% a US$ 1,44, e o Astra Max alcança 41,40% a US$ 1,73. Os rótulos de esforço não correspondem aos orçamentos computacionais entre os provedores.
O Argon tem a pontuação mais alta nesta comparação, mas seu custo normal por tarefa não é o menor. Uma pontuação de benchmark de aproximadamente 51% também não justifica acesso à produção sem supervisão. Ainda quero aprovação para ações consequenciais, logs que eu possa inspecionar e uma forma de recuperar o sistema após uma conclusão parcial.
Essa distinção é importante para a automação empresarial. Eu me importo que o registro correto seja atualizado e que o destinatário correto receba uma mensagem. Um agente me dizer que terminou não pode substituir essas verificações.
Os resultados de programação dependem da tarefa
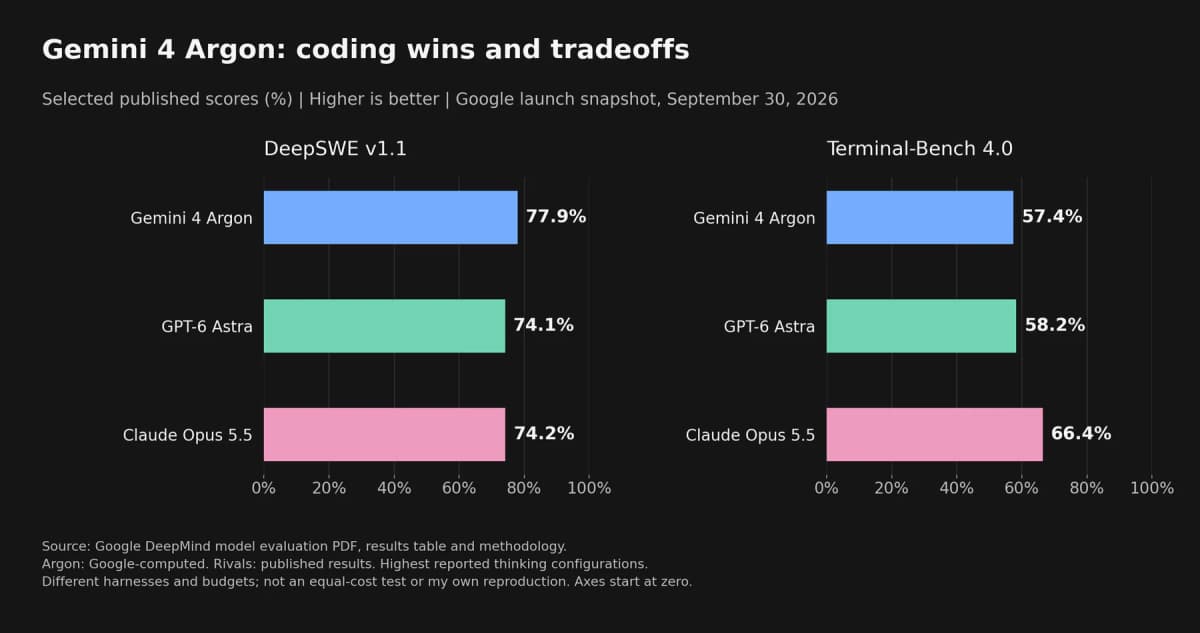
Pontuações selecionadas do relatório de avaliação de modelos do Google DeepMind. Isso combina resultados do Argon calculados pelo Google com resultados publicados de concorrentes, e não uma execução independente e uniforme entre os modelos.
O Argon alcança 77,9% no DeepSWE v1.1, contra 74,1% do Astra e 74,2% do Opus. No Terminal-Bench 4.0, o Opus lidera este trio com 66,4%, seguido pelo Astra com 58,2% e pelo Argon com 57,4%. O relatório também coloca o Astra à frente no FrontierSWE v2: 65,5% contra 55,0% do Argon.
O Google geralmente informa suas configurações mais altas de raciocínio e os resultados máximos ou melhores disponíveis dos concorrentes. Harnesses e orçamentos importam. Uma liderança em um benchmark de repositório não garante uma correção melhor na minha base de código, especialmente quando a diferença é de apenas alguns pontos percentuais.
Eu testaria separadamente uma correção de regressão limitada e uma alteração em vários arquivos. Ambas precisam de verificações comportamentais e de uma revisão do diff. Um modelo pode passar no teste e ainda adicionar uma abstração que eu não queira manter.
Evidências independentes sobre trabalho de conhecimento acrescentam contexto
O Vals Index 2.1, atualizado em 30 de setembro, lista o Argon com 68,90%, o Opus 5.5 com 66,97%, o Astra com 63,13% e o Sol 6.1 com 61,15%. O Vals combina tarefas financeiras, de programação, jurídicas e tributárias com pesos setoriais baseados no PIB dos EUA.
Sua coluna de custos complica o ranking: US$ 15,68 por teste para o Argon nas tarifas de tokens de US$ 4/US$ 20, contra US$ 3,24 para o Sol. Esses são custos específicos do benchmark, não cotações para o meu trabalho. Eles mostram por que eu manteria um modelo mais barato na avaliação, mesmo que outro modelo lidere a coluna de pontuação.
Eu encaminharia as tarefas depois de medi-las. Trabalho recorrente fácil e falhas caras não devem usar automaticamente o mesmo modelo.
O que outras pessoas estão dizendo sobre o Argon?
A discussão sobre o lançamento do Gemini 4 Argon contém entusiasmo, frustração com o acesso restrito e lembretes sobre o preço posterior. Essas são reações individuais ao lançamento, não uma pesquisa representativa nem evidência de que todas essas pessoas tenham experimentado o Argon. Comentários que preveem semanas ou meses de espera são especulação.
O debate mais útil para mim aparece na discussão da comunidade Rust sobre as migrações de bases de código do Google. Um comentarista, nicoburns, argumenta que a tradução entre linguagens pode funcionar melhor porque o design original já existe. Outros descrevem problemas de manutenção e o esforço que gastam corrigindo código gerado.
Essa discussão trata de engenharia assistida por agentes de forma ampla. Ela não estabelece a confiabilidade do Argon no mundo real. Levo a lição prática a sério: comparar o comportamento com o original, manter as alterações fáceis de revisar e medir o trabalho humano restante depois.
Como planejo testar o Gemini 4 Argon
Estou curioso o suficiente para dar ao Google uma chance justa. Começarei com tarefas que posso verificar, em vez de pedir ao modelo que assuma tudo de uma vez.
Quero registrar o tempo decorrido, o custo dos tokens, as tentativas, a correção e o esforço de revisão. A questão é saber se o Argon reduz meu trabalho total, incluindo a verificação e o reparo do resultado.
O anúncio do Google também eleva o limite de saída para um milhão de tokens. Isso é um teto, não uma meta. Eu ainda definiria orçamentos e condições de parada; um raciocínio mais amplo deve justificar seu custo. Meu artigo sobre tokens de raciocínio de AI e custos computacionais explica por que me importo com essa compensação.
O Gemini 4 Argon parece valer a pena testar. Ainda não usei o Google o suficiente para lhe dar um lugar justo no meu fluxo de trabalho. Esses resultados me fazem querer mudar isso quando eu puder acessar o modelo, mantendo Sol, Opus e Astra como alternativas reais até que meus próprios testes me mostrem mais.