Uso o Claude Haiku 5.5 para traduções, alterações rápidas de texto, correções e tarefas leves de deploy. Esses trabalhos precisam de um modelo que siga um briefing específico e conclua a tarefa sem transformar uma pequena edição em um projeto.
A configuração de esforço é importante porque esses trabalhos não têm o mesmo nível de dificuldade. Corrigir um erro de digitação e traduzir uma página com terminologia técnica merecem pontos de partida diferentes.
Esta é a parte 1 de AI Models in Practice, uma série sobre como escolher modelos para trabalhos reais. Os exemplos abaixo são prompts reutilizáveis e configurações propostas. Não fiz uma comparação controlada de todos os níveis de esforço, e as traduções de exemplo são referências editoriais, não saídas registradas do Haiku. Os detalhes e preços do modelo foram verificados na documentação da Anthropic em 12 de outubro de 2026.
Índice
O que é o Claude Haiku 5.5?
O Claude Haiku 5.5 é a opção de modelo pequeno da Anthropic para trabalhos de alto volume e sensíveis ao tempo. A Anthropic lançou o modelo em 7 de outubro de 2026 e o posiciona para resumos, classificação, extração, roteamento e tarefas delimitadas de subagentes. O ID do modelo na Claude API é claude-haiku-5-5. Consulte o anúncio de lançamento do Claude Haiku 5.5.
A visão geral do modelo Haiku 5.5 lista entrada de texto e imagem, saída de texto, uma janela de contexto de um milhão de tokens e até 128.000 tokens de saída na Messages API. Ele usa adaptive thinking por padrão. Uma janela de contexto grande descreve a capacidade; isso não significa que enviar todo o seu repositório seja útil ou econômico.
Eu forneceria ao Haiku um parágrafo, um glossário e uma tarefa de edição precisa antes de pedir que ele interpretasse uma empresa inteira. Um briefing mais específico torna o resultado mais fácil de inspecionar.
Para que o Haiku 5.5 é bom?
Minha lista prática começa pelos trabalhos para os quais já o utilizo:
Outras tarefas que valem ser avaliadas incluem extrair campos de um documento fornecido, classificar mensagens em categorias conhecidas e resumir uma conversa curta de suporte. Esses são usos propostos, não resultados do meu próprio benchmark.
Para trabalhos amplos de engenharia, a escolha do modelo merece outra análise. O material de lançamento da Anthropic recomenda Sonnet 5.5 e Opus 5.5 para programação agentic mais complexa. Aumentar o esforço do Haiku não garante a mesma capacidade de um modelo maior.
O que significam os cinco níveis de esforço?
O Haiku 5.5 oferece low, medium, high, xhigh e max. O padrão é medium. O esforço orienta quanto trabalho o modelo dedica a uma resposta; não é um orçamento fixo de tokens nem uma garantia de precisão. Ele afeta o raciocínio, o texto da resposta e as chamadas de ferramentas. Consulte a documentação de esforço da Anthropic.
| Esforço | Orientação oficial inicial | Meu uso proposto |
|---|---|---|
low | Tarefas curtas, simples e sensíveis à latência | Correção de um erro de digitação ou uma tradução curta e sem ambiguidades |
medium | Padrão para a maioria dos trabalhos, incluindo programação delimitada | Uma tradução normal ou uma pequena edição de texto com restrições |
high | Trabalho de conhecimento, tarefas agentic mais longas e seguimento rigoroso de instruções | Terminologia ambígua ou uma edição que precisa satisfazer várias regras |
xhigh | Use quando as avaliações demonstrarem ganho de qualidade | Um experimento em uma tarefa difícil e delimitada; compare com o Sonnet |
max | Use quando as avaliações justificarem o custo adicional | Um caso de teste excepcional, depois de verificar níveis inferiores |
Minha regra inicial seria medium e depois ajustar com base nos erros observados. Para uma correção trivial, tente low. Para uma tradução sensível ao glossário, compare medium com high. Mantenha o prompt e as entradas iguais para saber se a configuração ajudou.
Um deploy pode envolver apenas um comando e ainda assim trazer consequências significativas. Eu escolheria os requisitos de verificação e aprovação independentemente do esforço.
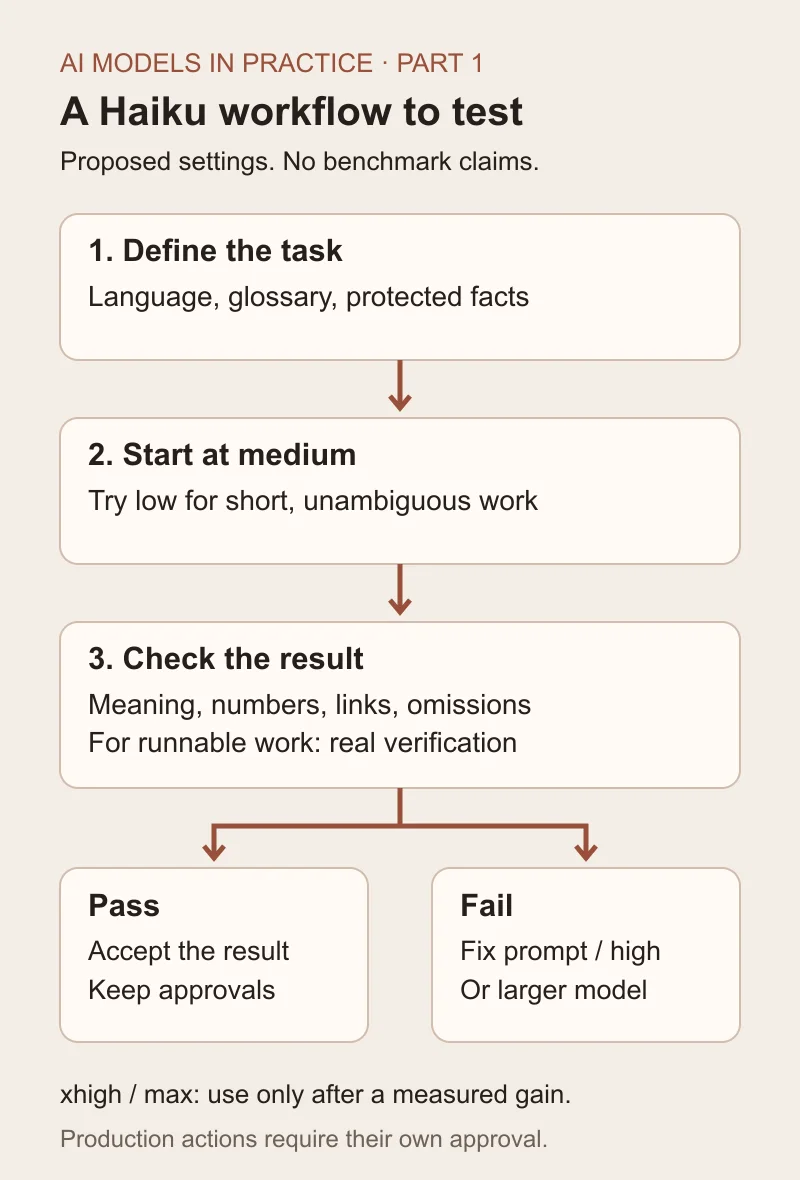
Fluxo de trabalho proposto, não evidência de benchmark. Aceitar significa que o resultado passou pelas verificações daquela tarefa; as ações de publicação e produção mantêm suas próprias etapas de aprovação.
Como eu definiria o esforço para traduções
A tradução é o exemplo mais claro de por que um único padrão não pode abranger tudo. Essas configurações são hipóteses iniciais para avaliação, não vencedores medidos.
Low para textos curtos e literais
Uma mensagem de status curta tem pouca ambiguidade:
text Translate from Swedish to British English. Return only the translation. Keep the order number and date unchanged.
Source: Din beställning 1842 skickades den 12 oktober 2026.
Uma referência editorial aceitável é: “Your order 1842 was dispatched on 12 October 2026.” As verificações importantes são o número do pedido, a data e o significado. Várias formulações em inglês podem ser aprovadas.
Eu tentaria low aqui e aumentaria o nível se algum detalhe fosse perdido. Acrescentar raciocínio extra a esse prompt deve se justificar por meio de um resultado melhor.
Medium para textos normais de sites
Para um parágrafo, eu começaria em medium e especificaria o público, o locale, o tom e os termos protegidos:
text Translate the supplied Swedish text into British English. Audience: customers reading a service page. Tone: direct and friendly. Avoid sales hype.
Preserve:
Do not add claims or remove limitations. Return only the translation.
Source: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
Uma referência editorial poderia ser: “We normally update the page within two working days. It may take longer if we need additional information.” Uma versão que promete uma atualização em até dois dias alterou a afirmação.
O guia de suporte multilíngue da Anthropic recomenda informar os idiomas de origem e destino e considerar o contexto regional. A tabela de idiomas publicada abrange modelos mais antigos, incluindo o Haiku 4.5; ela não é evidência da precisão de tradução do Haiku 5.5.
High quando a terminologia ou a ambiguidade exigem atenção
Alguns termos dependem do contexto da empresa. A palavra sueca “reklamation” não deve ser automaticamente traduzida como “advertising”. Uma tradução adequada para o inglês pode envolver uma reclamação ou uma reivindicação sobre um produto com defeito, dependendo da frase.
text Translate this product-support text from Swedish to British English. Use the supplied glossary and preserve every qualifier.
Glossary: reklamation = complaint about a faulty product återbetalning = refund
If a phrase remains ambiguous, flag it in a separate note. Do not resolve uncertainty by inventing a policy. Return two sections: Translation and Ambiguities.
Source: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
Eu compararia medium e high para esse tipo de tarefa. O critério de sucesso é saber se a tradução preserva a condição e usa a terminologia pretendida. Uma formulação fluente, por si só, não é suficiente.
Para conteúdo estruturado, eu enviaria strings traduzíveis com identificadores estáveis. Minha aplicação verificaria se cada identificador aparece uma vez e se os valores protegidos foram preservados. Pedir a um modelo que preserve um arquivo JSON grande não substitui parsing e validação.
Alterações rápidas e correções de texto
Um prompt de correção deve definir a edição permitida. Caso contrário, um pedido para corrigir a gramática pode se transformar em uma reescrita.
text Correct spelling, grammar, and punctuation in this English paragraph. Keep my voice, meaning, numbers, and level of certainty. Do not add examples, claims, headings, or promotional language. Return only the corrected paragraph.
Text: We has updated the page, but the payment tests is not finished yet.
A referência editorial é: “We have updated the page, but the payment tests are not finished yet.” Uma versão que diga que a página foi totalmente testada não atende ao briefing.
Low é uma configuração razoável para avaliar em uma frase como essa. Medium é meu ponto de partida proposto para vários parágrafos, links protegidos ou múltiplas restrições.
Para uma alteração de texto, peça o resultado específico: “Reduza isto para 80 palavras, preserve as duas limitações e mantenha o link.” A contagem de palavras e a preservação do link são verificações que você pode executar independentemente do modelo.
Tarefas leves de deploy: defina o que significa concluir
Incluo tarefas simples de deploy entre os usos que faço do Haiku, mas “simples” precisa de um escopo explícito. Um procedimento de deploy conhecido para uma alteração de texto aprovada é diferente de diagnosticar uma versão com problemas ou decidir como migrar um banco de dados.
Uma instrução reutilizável poderia ser:
text Prepare this approved text change for deployment. Read the project's current deployment procedure and target. Check the diff and run the required verification.
Report:
Do not change credentials, infrastructure, or the release scope. Stop before commit, push, or production deployment until I approve. After an approved deployment, inspect the public result. A successful command alone does not prove the change is live.
Para preparação e verificações, eu começaria em medium. Se o trabalho exigisse investigar falhas em vários sistemas, eu reavaliaria o modelo e o esforço em vez de chamá-lo de tarefa leve.
O guia de prompting específico para Haiku da Anthropic observa que agentes com baixo esforço e prompts longos podem parar cedo ou omitir verificações. Ele recomenda instruções explícitas de verificação. O guia também menciona respostas visíveis ocasionalmente vazias em conversas com várias etapas em xhigh e problemas de chamadas de ferramentas quando o thinking está desativado junto com saída estruturada. Uma integração deve detectar resultados incompletos em vez de aceitá-los silenciosamente.
Como altero o esforço no Claude ou na API?
No Claude app, abra o menu do modelo ao lado do botão de envio, selecione Haiku 5.5 e escolha Effort. As opções disponíveis podem depender das configurações da conta ou do administrador. A Anthropic informa que o thinking não pode ser desativado para o Haiku 5.5 no Claude app. Consulte Alterar as configurações de modelo, esforço e thinking.
A API oferece um controle mais direto. Um corpo de requisição mínimo se parece com isto:
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "Translate the supplied Swedish paragraph into British English. Preserve names, numbers, and links." } ] }
Este é um formato de requisição ilustrativo, não uma requisição que executei. Forneça o parágrafo na mensagem do usuário. max_tokens é um limite, não uma reserva nem uma instrução para produzir uma resposta longa.
O guia de migração do Haiku 5.5 da Anthropic explica que o thinking consome esse orçamento de saída, portanto um limite pequeno pode truncar a resposta antes que o texto visível apareça. Selecione os blocos de resposta pelo type, em vez de presumir que o primeiro bloco contém a resposta.
Para novas requisições da API, omita temperature, top_p e top_k. Substitua a configuração antiga de thinking habilitado com budget_tokens por adaptive thinking. A API permite thinking desativado em low, medium e high; xhigh e max exigem adaptive thinking. O guia também lista diferenças entre provedores, portanto valide sua plataforma real antes de migrar.
Mantenha a chave da API no servidor. O campo de esforço é uma configuração, não um motivo para colocar credenciais no código do frontend.
Quanto custa o Haiku 5.5?
A documentação de preços da API da Anthropic lista estas tarifas padrão em USD por milhão de tokens, verificadas em 12 de outubro de 2026:
| Tamanho do prompt | Entrada | Saída | Leitura do cache |
|---|---|---|---|
| Até 100.000 tokens | $0.10 | $0.50 | $0.01 |
| Mais de 100.000 tokens | $0.50 | $2.50 | $0.05 |
A tarifa mais alta se aplica à requisição, incluindo a entrada contabilizada como leituras ou gravações de cache. Estes são preços de tokens da API; uma assinatura do Claude é um produto separado. Gravações de cache, ferramentas de servidor e modificadores da plataforma podem adicionar custos.
Para uma requisição ilustrativa sem cache, com 2.000 tokens de entrada e 1.000 tokens totais faturados de saída:
text Input: 2,000 / 1,000,000 × $0.10 = $0.00020 Output: 1,000 / 1,000,000 × $0.50 = $0.00050 Total: $0.00070
Esse cálculo exclui cobranças adicionais e não representa um custo de tradução medido. Conte o thinking na saída faturada. Um esforço maior pode alterar o uso de tokens, portanto a tabela de preços, sozinha, não consegue prever o custo de uma tarefa concluída.
Boas práticas que eu manteria nesses trabalhos
Dê ao modelo a menor tarefa completa possível. Inclua o glossário ou o texto-fonte aprovado de que ele precisa e evite material não relacionado.
Defina o contrato de saída. Para uma tradução, informe os dois idiomas e o locale. Para uma edição, especifique quais fatos e elementos de formatação devem ser preservados. Para um agente, defina as verificações e o ponto de parada.
Trate o texto-fonte como conteúdo a ser transformado. Uma frase incorporada a um documento não deve ganhar autoridade para alterar a tarefa, acessar credenciais ou publicar conteúdo.
Valide o resultado em relação à tarefa. Verifique termos protegidos, números, links e trechos ausentes. Para trabalhos de código ou deploy, inspecione evidências reais de testes e execução.
Aumente o nível com base em uma falha concreta. Um qualificador ausente sugere um prompt ou nível de esforço diferente. Uma tarefa que continua se expandindo pode precisar do Sonnet ou do Opus. Falhas repetidas devem desencadear uma revisão, não um aumento interminável do esforço.
Como eu testaria as configurações antes de confiar nelas
Eu criaria um pequeno conjunto de avaliação com 20 exemplos aprovados e anonimizados: dez traduções, cinco correções e cinco edições de texto com restrições. Essas quantidades descrevem um teste proposto, não uma pesquisa concluída.
Executaria low, medium e high com as mesmas entradas e critérios de aceitação. Repetiria os casos para revelar comportamentos inconsistentes. Um revisor fluente avaliaria as traduções sem saber qual configuração foi usada.
Registraria o modelo exato, o esforço, a versão do prompt, o tempo decorrido, os tokens faturados e os defeitos. Contaria qualificadores perdidos, números alterados, links quebrados, texto omitido e reescritas desnecessárias. Compararia o custo por resultado aceito, incluindo o trabalho de correção.
Para assistência em deploy, avaliaria tarefas de preparação separadas em um ambiente não produtivo com um resultado esperado conhecido. As ações em produção continuam sujeitas ao procedimento de aprovação do projeto.
Meu guia existente sobre como fazer benchmark de modelos de AI para trabalhos reais→ aborda a estratégia de avaliação mais ampla. A comparação entre GPT-6.1 Sol e Opus 5.5→ fornece contexto para escolhas de modelos maiores; não é um teste de tradução do Haiku.
A série começa com os trabalhos pequenos
O Haiku é a primeira parte porque traduções, correções e edições curtas tornam os trade-offs visíveis. Você pode verificar se uma frase manteve seu significado e se um link foi preservado.
As próximas partes propostas abordarão o Sonnet para programação e análise diárias, o Opus para trabalhos mais difíceis e um guia final para encaminhar tarefas entre modelos. Cada parte usará a mesma distinção: capacidades documentadas, meu uso real e testes que ainda precisam ser executados.
---