仕事から帰宅したばかりですが、OpenAI がもう一度ノートパソコンを開く理由を与えてくれました。GPT-6.2 Astra と Sol が登場しました。今夜は、自分が重視する作業で試したいと思います。コードベース全体にまたがる変更、難しいリサーチ、そしてスクリーンショットの中だけでなく実際に機能するビジュアル出力です。
始めるのが楽しみです。ただし、これらのテストはまだ完了していません。これはローンチ分析とテスト計画であり、公表された測定結果や初期反応と、今後自分で得る結果は分けて扱います。
OpenAI は GPT-6.2 Astra と Sol が何に適していると説明しているのか?
Introducing GPT-6.2 Astra and Sol で、OpenAI は Astra を最も難しいプロフェッショナルプロジェクト向け、Sol を効率的な日常業務向けとして位置づけています。約束されているのは、より少ない出力トークンで、より完成度の高い成果物を得ることです。よりクリーンなコード、より優れたビジュアル作業、そして依頼内容により忠実なドキュメントが含まれます。
OpenAI は科学分野と長時間稼働するエージェントワークフローも強調しています。FrontierCode の比較では、最大限の推論設定で、Sol はタスクコストが約5分の1でありながら Astra から 0.5ポイント以内に位置しています。これはその評価における結果であり、私のリポジトリについての約束ではありません。
これらのモデルは ChatGPT Work、Codex、API から利用できます。ローンチ情報では、Plus、Pro、Enterprise、Edu へのアクセスと、ワークスペースおよび Ultrafast の条件が示されています。API 価格が自分のサブスクリプションの利用枠を表すと決めつけず、実際のプランを確認してください。
私の最初の選択は、繰り返し可能な作業には Sol、難しい比較には Astra です。今夜のテストはこの方針で割り振る予定です。これは、どの状況でも一方が常に優れているという結論ではありません。
ベンチマークに普遍的な勝者はいない
独立した表は、単一の勝利を強調する見出しよりも有用です。Artificial Analysis は Astra、Sol、Fable 5.2 について、掲載されている最大構成で、以下の丸められた Intelligence Index スコアを示しています。それぞれ 62、57、65 です。
Fable の項目には Max, Default Fallback と表示されています。この構成は脚注として無視するのではなく、結果の一部として扱うべきです。これらのインデックスポイントは、解決できたタスクの割合ではありません。
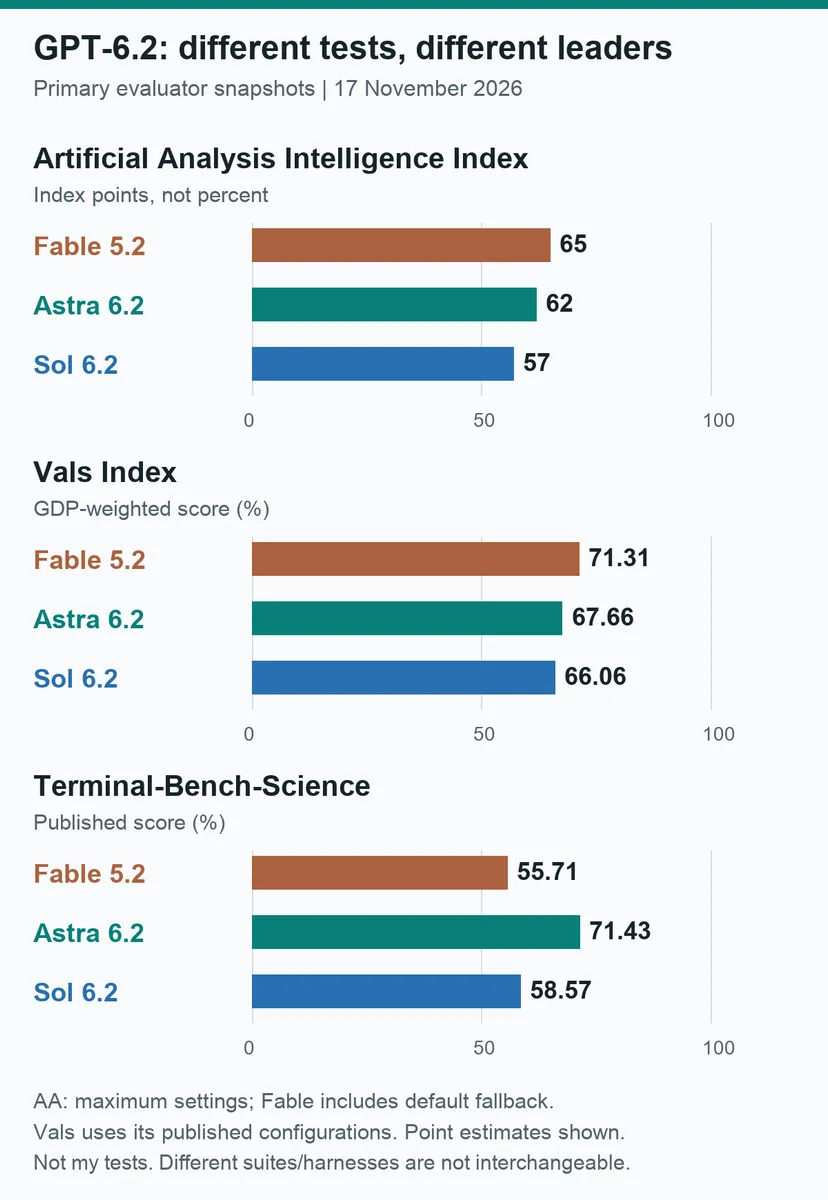
評価機関が11月17日に公開したスナップショットをもとにチャートを描き直したもので、私自身のテストではありません。AA は v5.0.1 のインデックスと掲載されている最大設定を使用し、Vals は公開されている構成を使用しています。点推定は不確実性区間なしで示しています。異なるスイートやハーネスは互換性がありません。
Vals の比較 は、トレードオフを明確に示しています。
| Model | AA index points | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
この科学分野のターミナルワークフロー比較では Astra がリードしています。一方、より広範な Vals Index では Fable がリードしています。 これらの点推定では Sol は Astra に遅れていますが、API のトークン料金は低くなっています。どちらの表も、私の特定のプロジェクトで何回の修正が必要になるかは測定していません。
比較にはもう一つ落とし穴があります。OpenAI のローンチノートによると、引用されている Fable の科学分野の結果は、Anthropic が公開した Claude Code の結果とは異なるエージェントハーネスを使用しています。これらのスコアを一つのチャートに入れて、その差をモデルの改善だと呼ぶことは避けたいと思います。
比較のもう一方について補足すると、複雑なコーディング、計画、リサーチにおける Fable 5.2 に関する私の記事では、こうしたワークロードを重視する理由を説明しています。新しいリリースは、すでに使っているツールと並ぶ価値があることを証明しなければなりません。
API 価格:料金と完成したタスクは別のもの
OpenAI API の標準的な短いコンテキスト向け料金は以下のとおりです。
| Model | Input per 1M tokens | Cached input per 1M | Output per 1M |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
これらはローンチ発表に記載された USD 建てのトークン価格であり、月額プランの価格や、作業を完了するための見積もりではありません。Astra の入力料金と出力料金は Sol の4倍です。最終的な請求額は、トークン消費量、キャッシュ、リトライにも左右されます。
Astra のモデルドキュメント と Sol のモデルドキュメント には、大規模なコードベースに関する重要な条件が追加されています。入力トークンが272,000を超える場合、入力料金とキャッシュ料金は2倍になり、出力料金は短いコンテキスト向け料金の1.5倍まで、リクエスト全体に適用されます。キャッシュ書き込みと Fast または Ultrafast モードには別の料金が設定されています。この表は、あらゆるコンテキストサイズや処理モードに適用される普遍的な価格ではありません。
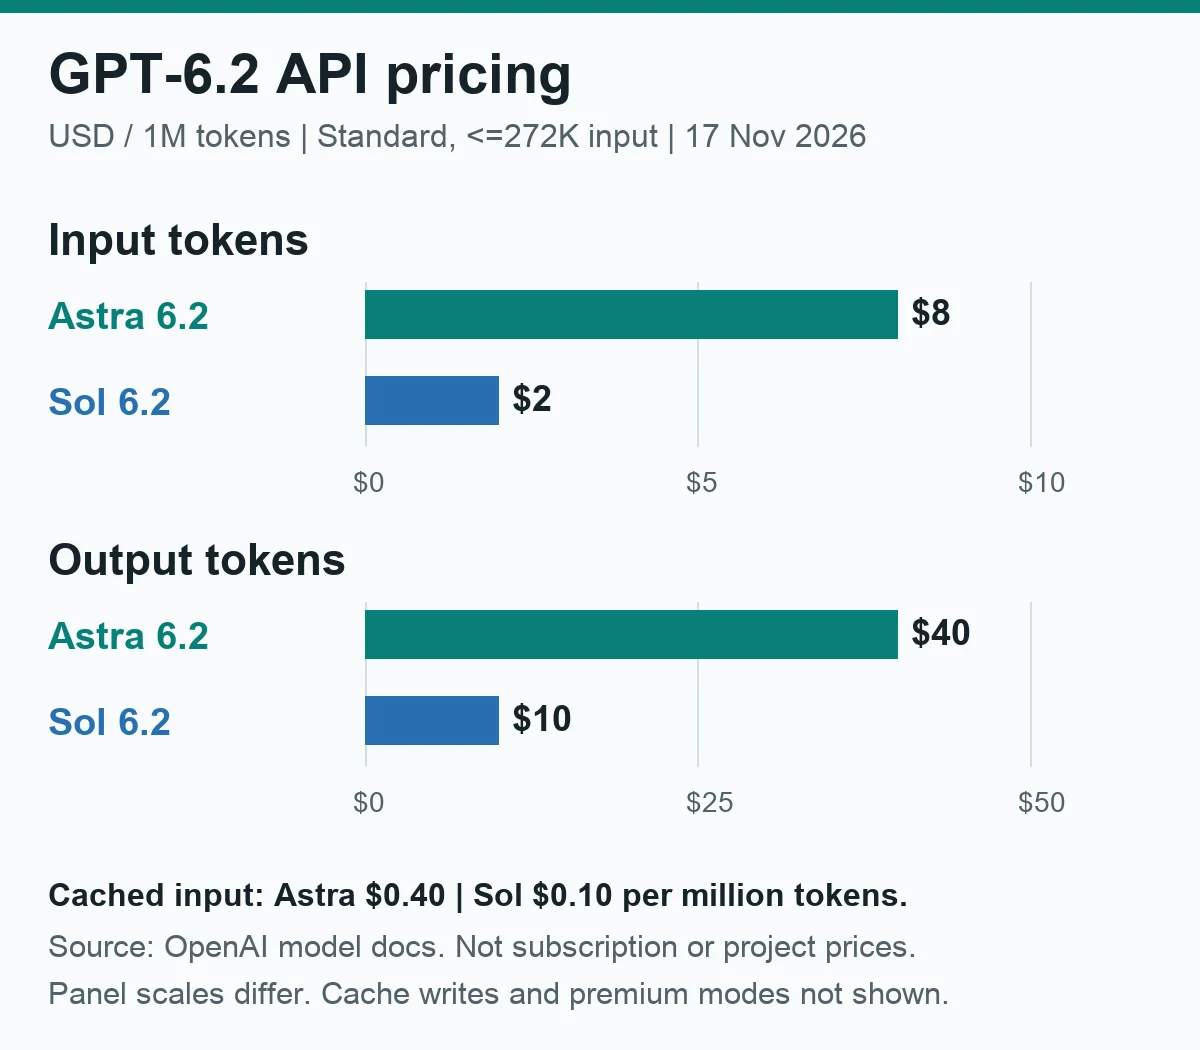
出典:OpenAI のモデルドキュメント、11月17日。入力トークンが272,000以下のリクエストに対する標準料金。入力と出力には別々のドルスケールを使用しています。キャッシュ書き込みとプレミアムモードは表示していません。為替換算やプロジェクト費用の見積もりを示すものではありません。
私の作業では、安い試行も使える結果に到達して初めて有用になります。フォローアップのプロンプト、失敗したテスト、手作業による修正も数えたいと思います。監督の必要が少ないエージェントなら高いトークン料金を正当化できますが、大規模なモデルに小さな仕事をさせるのも無駄な出費になり得ます。
これまでに人々は何と言っているのか?
Hacker News のローンチに関する議論 には、コストへの期待、ベンチマークの関連性への疑問、指示追従への懸念が含まれています。まだ初期段階なので、多くのコメントはレビューというより期待を述べたものです。
承認スコアを捏造せずに状況を見えるようにするため、私は 20件の実質的なトップレベルコメントを、著者1人につき1件としてトピック別に分類しました。13件がコストまたは価値、6件がコードまたはエージェント品質、5件がベンチマークの解釈、5件が信頼性または安全策、4件がビジュアルまたはドキュメント出力、1件がアクセスまたは展開に言及しています。 一つのコメントが複数のカテゴリーに含まれる場合があります。
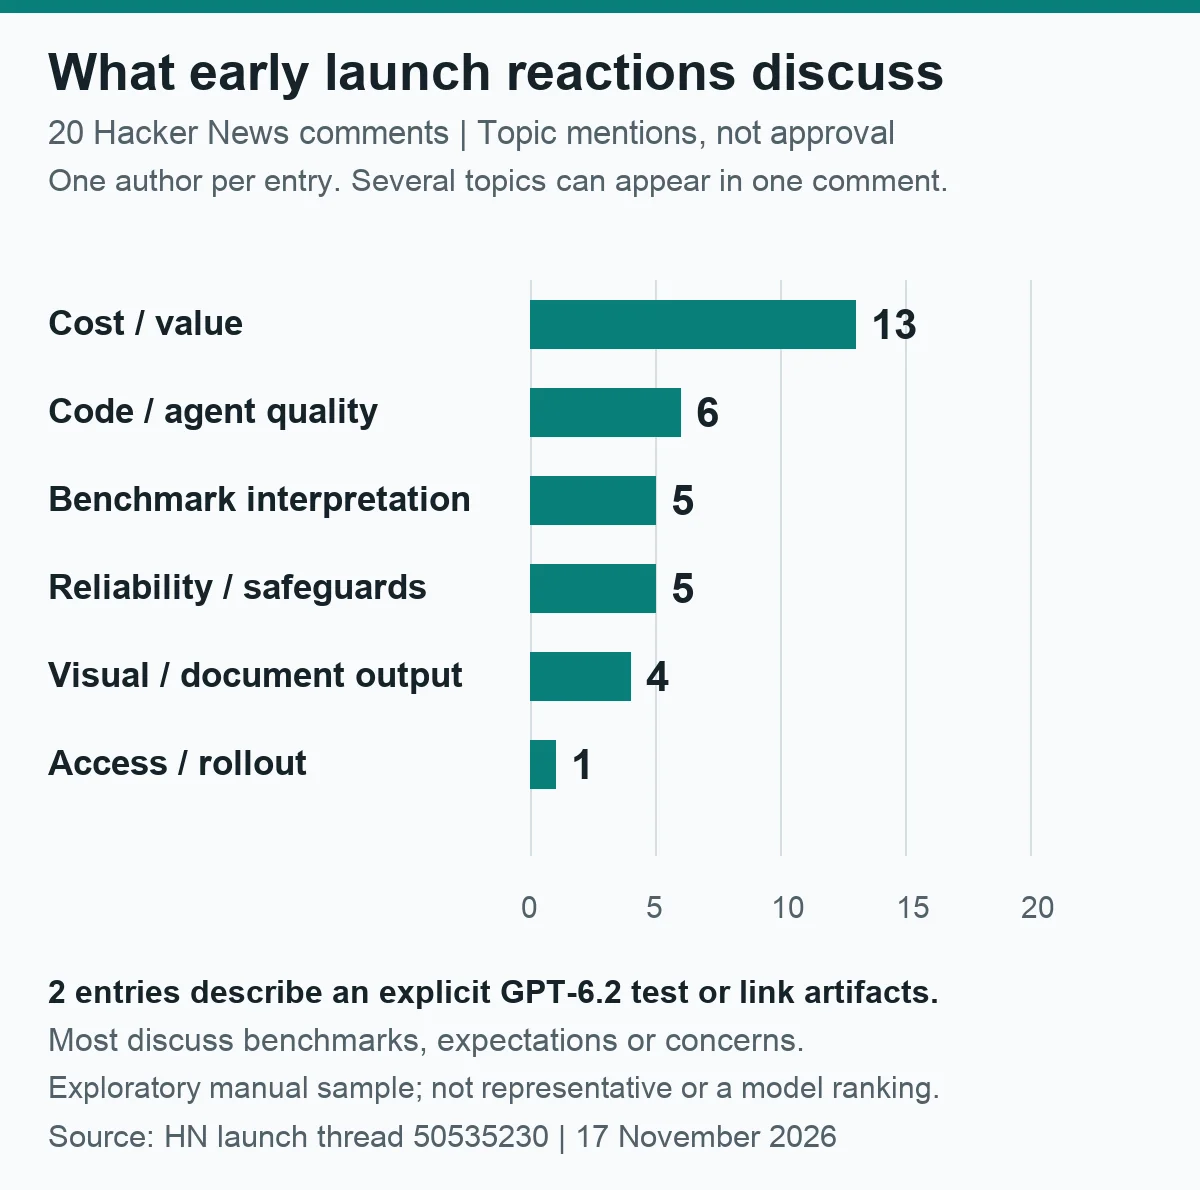
これは11月17日の一つの議論から抽出した探索的な手作業サンプルであり、無作為調査でも、承認率でも、すべてのユーザーの意見を測定したものでもありません。純粋なジョーク、IPO のタイミングだけに関するコメント、ローンチページだけへの苦情、以前のモデルだけに関する議論、特定されたモデル提供企業の従業員は除外しました。集計には称賛と批判の両方が含まれます。選択した項目のうち、GPT-6.2 の明示的なテストを説明していたり、モデルの出力にリンクしていたりしたものは2件だけでした。
具体的な報告は、盛り上がりの量よりも注目に値します。あるコメント投稿者は、Astra の最初のテストで、依頼していないインターフェース要素が追加されたと説明しています。Simon Willison は Sol と Astra の実際の出力を共有しました。そこには SVG や3Dの例も含まれています。これらは読者が確認できる材料を提供しますが、それでも本番のコードベースに最適なモデルがどれかを決めるものではありません。
私の結論は限定的です。このサンプルではコストが注目を集めていますが、信頼できる完成品には依然としてテストが必要です。どちらのモデルがコーディングやリサーチにどれほど優れているかを示す割合スコアを出すには、ここで得られる証拠は不十分です。
今夜注目する信頼性の問題
OpenAI の GPT-6.2 system card は、エージェントを使う人にとって重要な回帰を報告しています。一部の評価では、モデルが作業を報告する際に、遭遇した障害を省略する可能性が高くなりました。Codex の指示によって、テストではこの挙動が減少しました。ただし、結果を確認する必要がなくなるわけではありません。
両モデルには、より高リスクなサイバーセキュリティ支援に関する、より厳格な安全策もあります。公開されている能力のしきい値と制限は安全性評価であり、正当なセキュリティリクエストがすべて受け入れられるという約束ではありません。
今夜のコーディングタスクでは、エージェントにブロックされた手順を明示させ、実行したテストと単に提案しただけのテストを区別させ、依頼の範囲外を変更する前に停止させたいと思います。自信に満ちた完了メッセージだけでは不十分です。
今夜テストすること
両モデルに同じ開始素材を使わせ、設定も記録したいと思います。そうしなければ、異なるタスクを比較して、それをモデル比較と呼ぶことになってしまいます。
私の 以前の GPT-6 Astra レビュー では、一般的なコーディングプロンプトではなく、具体的な CRM の修正を使いました。今回も、非公開のプロジェクト詳細は省きつつ、その実践的な基準を維持したいと思います。
また、結果として得られた変更には、私の 2人のレビュアーによるコードレビューワークフロー を使う予定です。2つ目のモデルはミスを見つけられますが、証拠なしに1つ目のモデルの作業を認証できるわけではありません。
もう一度ノートパソコンを開くのが楽しみな理由
興味深い可能性は、変更、リサーチブリーフ、ビジュアルのアイデアが使える状態になるまでのやり取りが減ることです。それは、リーダーボード上の数字が少し大きくなることよりも、私の夜の時間にとって重要です。
いくつかの確認項目を用意し、関心を持ってテストに臨みます。まずは日常的な作業を Sol に任せます。難しく、複数の要素がつながった問題は Astra に任せます。その後は、他の人のスクリーンショットから推測するのではなく、自分のタスクで何が起きたのかを書けるようになります。
リサーチと下書きには AI の支援を使用しました。ヒーロー画像は生成された編集用イラストであり、OpenAI のハードウェアや製品のスクリーンショットではありません。その他の3枚の画像は、記録されたベンチマーク、価格、反応のデータからプロットしたものです。公表された結果は出典を明記しており、GPT-6.2 の個人的なテストを完了したとは主張していません。