Googleのモデルに触れてきた時間は、ワークフローで使っている他のAIツールよりもはるかに短いものでした。Gemini 4 Argonは、それを変える理由を与えてくれます。ビジネス自動化の結果は有用そうで、発表された導入価格は、プレミアム専用モデルではなくGPT-6.1 Solと同じ水準にあります。
アクセスが始まったらテストしたいと思っています。今のところ、これは実際にArgonを使ったレビューではなく、公開されている証拠、料金、初期の反応を確認する記事です。
情報確認日:2026年10月1日。カバー画像はAI生成の編集用アートワークです。以下のグラフは引用した数値結果を再構成したもので、私自身のテストのスクリーンショットではありません。
Gemini 4 Argonとは何か、もう使えるのか?
Googleは2026年9月30日にArgonを発表しました。当初はFairwindを通じて、信頼されたサイバー防御担当者向けに提供されます。より広いアクセスは、有料API顧客とGoogle AI Ultra加入者から始まる予定ですが、発表では一般公開の確定日を示していません。GoogleのGemini 4 Argon発表を参照してください。
Argon専用にサブスクリプションを購入する前に、実際にアカウントでアクセスできるようになるのを待ちたいと思います。発表された展開計画と、今日選択できるモデルは別物です。また、Googleはその発表でスウェーデンでの提供時期を約束していません。
私が注目する最大の理由は、介入を減らしながら、より長いタスクを完了できる可能性です。私にとって有用なテストでは、既存のコード、扱いにくいビジネスルール、そして最終結果が機能することを示す証拠を扱います。洗練された回答だけでは判断できません。
Gemini 4 Argonの料金:導入価格には注意点がある
Googleは、100万トークンあたり入力$2、出力$10を発表しています。料金に関する脚注では、その後の料金を$4/$20としていますが、導入期間の終了日は明示していません。キャッシュ入力には95%の割引が適用されるため、計算上の導入価格は$0.10です。
| モデルまたは料金期間 | 入力 / 100万トークン | 出力 / 100万トークン |
|---|---|---|
| Gemini 4 Argon、導入時 | $2 | $10 |
| Gemini 4 Argon、導入後 | $4 | $20 |
| GPT-6.1 Sol、Standard | $2 | $10 |
| Claude Opus 5.5、Standard | $4 | $20 |
| GPT-6 Astra、Standard | $10 | $50 |
出典:Googleの発表および拡張された料金脚注、GPT-6.1 Solのモデル料金、GPT-6 Astraのモデル料金、Claude Platformの料金。
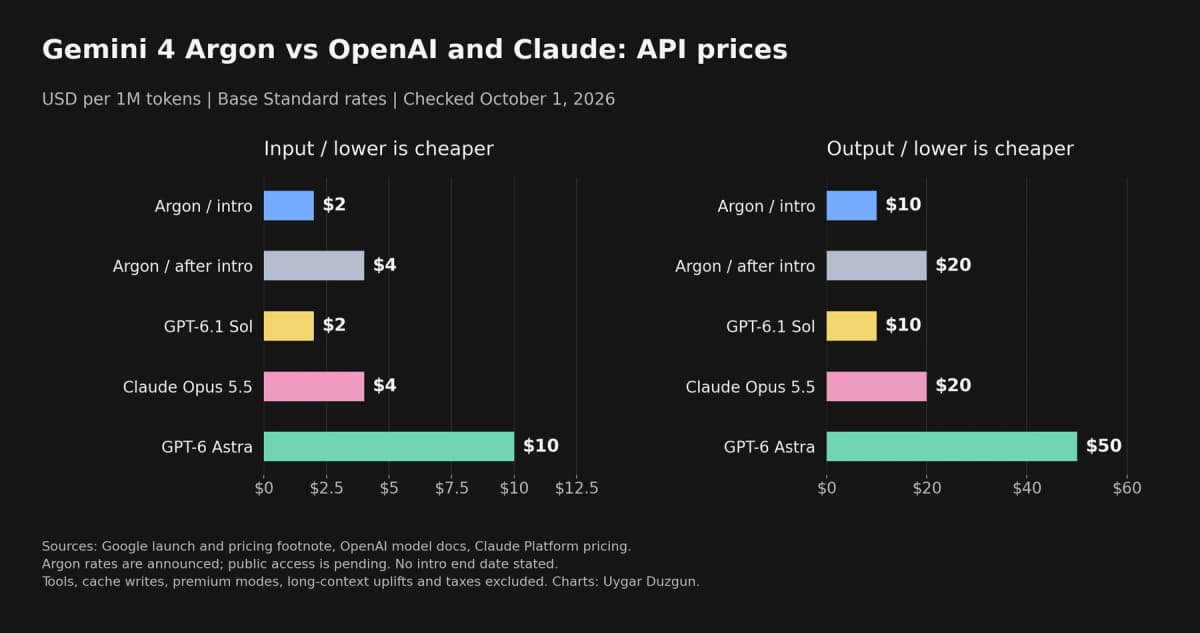
2026年10月1日に確認した米ドルの基本料金。Argonの料金は発表された料金であり、一般的なAPIアクセスを証明するものではありません。この比較には、ツール、キャッシュ書き込み、プレミアムモード、地域別料金、税金は含まれていません。
単純な予算例として、複数の短いコンテキストのリクエストにわたり、キャッシュされていない入力トークン100万個と出力トークン10万個を使う場合、Argonの導入料金では$3、その後は$6、Solでは$3、Opusでは$6、Astraでは$15になります。これは固定したトークン構成による算術であり、実測したワークロードではありません。同じタスクでも、モデルによって消費するトークン数は異なります。
OpenAIは、1つのプロンプトで入力トークンが272,000を超える場合、完全なリクエスト料金も引き上げています。一方、AnthropicはOpus 5.5のコンテキストウィンドウ全体に標準料金を掲載しています。したがって、基本料金の表だけでは、大規模なリポジトリのセッションにかかる請求額は分かりません。私のGPT-6.1 SolとOpus 5.5の比較では、こうしたトレードオフを扱っています。
Argonの導入を予算化する際は、後の料金を前提にし、プロモーションは一時的な節約として扱いたいと思います。そうすれば、終了時期をまだ予定できない割引を中心にビジネスケースを構築せずに済みます。
Gemini 4 Argonのベンチマーク:自動化は強いが、コーディングはまちまち
私が最も重視する結果はビジネス自動化
ZapierのAutomationBench 1.0.6は、6つのビジネス機能にまたがる47個のツールを使ったエンドツーエンドの作業をテストします。エージェントの説得力のある最終メッセージを評価するのではなく、決定論的なアサーションによって結果の環境を検証します。
以下で選択した構成では、努力量の設定とフォールバック動作を維持しています。
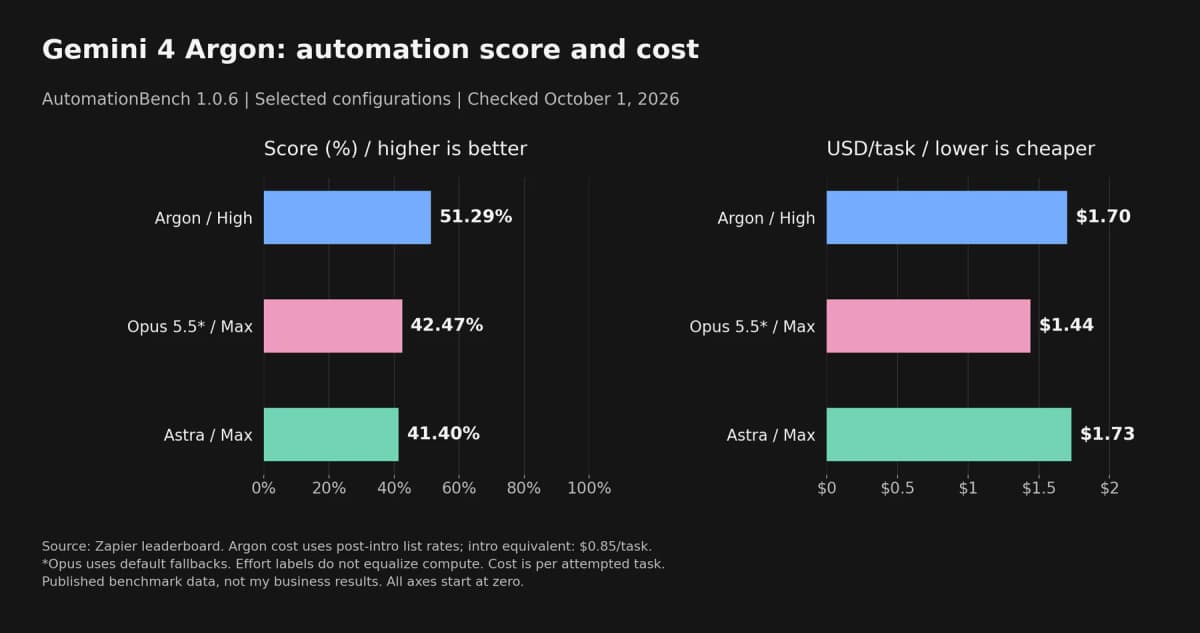
Zapierによると、Argon Highは51.29%、後のリスト料金で試行タスクあたり$1.70です。導入時の同等料金は$0.85です。デフォルトのフォールバックを使用したOpus 5.5 Maxは、$1.44で42.47%、Astra Maxは$1.73で41.40%でした。努力量のラベルは、プロバイダー間で計算予算が一致していることを意味しません。
この比較ではArgonのスコアが高いものの、通常のタスクコストが最も低いわけではありません。また、ベンチマークスコアが約51%だからといって、監視なしで本番環境にアクセスさせる根拠にはなりません。私は依然として、重大なアクションの承認、確認可能なログ、部分的な完了から復旧する方法が必要だと考えています。
この違いはビジネス自動化において重要です。私が重視するのは、正しいレコードが更新され、正しい受信者にメッセージが届くことです。エージェントが完了したと伝えるだけでは、こうした確認の代わりにはなりません。
コーディング結果はタスクによって異なる
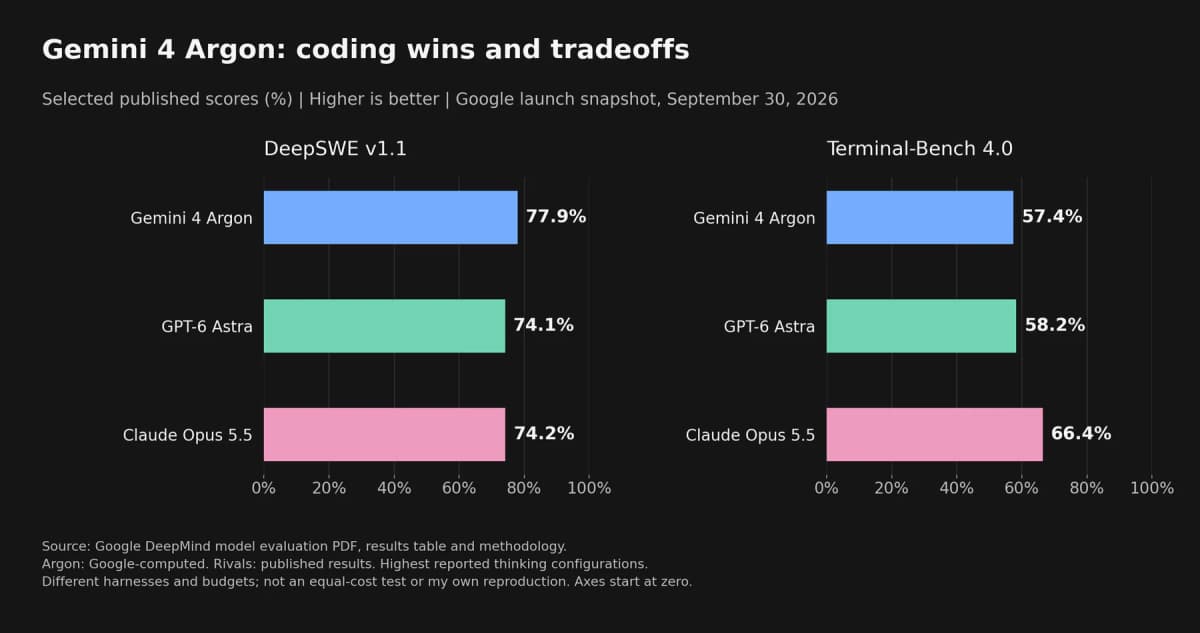
Google DeepMindのモデル評価レポートから選択したスコア。Googleが計算したArgonの結果と、公開されている競合モデルの結果を組み合わせたもので、統一された独立の直接対決テストではありません。
ArgonはDeepSWE v1.1で77.9%に達し、Astraの74.1%、Opusの74.2%を上回っています。Terminal-Bench 4.0では、この3モデルの中でOpusが66.4%で首位となり、Astraが58.2%、Argonが57.4%で続きます。レポートではFrontierSWE v2でもAstraがArgonを上回り、65.5%対55.0%となっています。
Googleは一般に、最高の思考設定と、競合モデルについて利用可能な最大または最良の結果を報告しています。ハーネスと予算は重要です。1つのリポジトリベンチマークでの優位性が、私のコードベースでより良い修正を保証するわけではありません。特に差が数ポイントしかない場合はなおさらです。
私は、範囲を限定した回帰修正と、複数ファイルの変更を別々にテストしたいと思います。どちらにも動作確認と差分のレビューが必要です。モデルがテストに合格しながら、私が保守したくない抽象化を追加する可能性もあります。
独立した知識労働の証拠が文脈を補う
Vals Index 2.1は9月30日に更新され、Argonを68.90%、Opus 5.5を66.97%、Astraを63.13%、Sol 6.1を61.15%としています。Valsは、米国GDPに基づくセクター別の重み付けを用いて、金融、コーディング、法律、税務のタスクを組み合わせています。
コスト欄を加えると順位は複雑になります。Argonは$4/$20のトークン料金でテストあたり$15.68なのに対し、Solは$3.24です。これはベンチマーク固有のコストであり、私の作業に対する見積もりではありません。別のモデルがスコア欄で首位になっていても、評価により安価なモデルを残す理由が分かります。
タスクを測定した後に振り分けたいと思います。簡単な反復作業と、失敗した場合のコストが高い作業を、必ずしも同じモデルで処理するべきではありません。
Argonについて、他の人は何と言っているのか?
初期のGemini 4 Argonリリースに関する議論には、期待の声、アクセス制限への不満、後の料金に関する注意喚起が含まれています。これらは個々のユーザーによるローンチ時の反応であり、代表性のある調査でも、全員がArgonを試した証拠でもありません。数週間または数か月待つことになるというコメントは推測です。
私にとってより有用な議論は、Googleによるコードベース移行についてのRustコミュニティの議論にあります。コメント投稿者の1人であるnicoburnsは、元の設計がすでに存在するため、言語間の変換のほうがうまくいく可能性があると主張しています。一方で、保守性の問題や、生成されたコードの修正に費やしている労力を説明する人もいます。
この議論は、広い意味でのエージェント支援エンジニアリングに関するものです。Argonの実環境での信頼性を証明するものではありません。私は実践的な教訓を重視しています。元のコードと動作を比較し、変更をレビュー可能な状態に保ち、その後に残る人間の作業量を測定することです。
Gemini 4 Argonをどのようにテストする予定か
Googleに正当な機会を与えるには十分な関心があります。最初からすべてを任せるのではなく、検証できるタスクから始めます。
経過時間、トークンコスト、再試行、正確性、レビューにかかる労力を記録したいと思います。問題は、結果の確認や修正まで含めた私の総作業量をArgonが減らせるかどうかです。
Googleの発表では、出力上限も100万トークンに引き上げられています。これは上限であって、目標ではありません。私は依然として予算と停止条件を設定します。より多くの推論が利用できるなら、そのコストに見合う成果を上げるべきです。AIの推論トークンと計算コストに関する私の記事では、このトレードオフを重視する理由を説明しています。
Gemini 4 Argonはテストする価値がありそうです。私はまだGoogleのモデルを十分に使っておらず、ワークフローの中で公平な位置づけを与えられていません。今回の結果を見て、モデルにアクセスできるようになったらそれを変えたいと思っています。ただし、自分のテストでさらに分かるまでは、Sol、Opus、Astraも現実的な選択肢として残します。