私は翻訳、短いテキスト変更、修正、軽微なデプロイ作業にClaude Haiku 5.5を使っています。これらの作業には、狭い依頼内容に従い、小さな編集を大きなプロジェクトに変えずに完了できるモデルが必要です。
Effort設定が重要なのは、これらの作業の難易度が同じではないからです。タイプミスの修正と、技術用語を含むページの翻訳では、開始点を変えるべきです。
これは、実際の作業に使うモデルの選び方を扱うシリーズ、AI Models in Practiceのパート1です。以下の例は再利用可能なプロンプトと、提案する設定です。すべてのEffortレベルについて管理された比較を実施したわけではなく、サンプル翻訳は編集上の例であり、Haikuの実際の出力を記録したものではありません。モデルの詳細と価格は、2026年10月12日にAnthropicのドキュメントで確認しました。
目次
Claude Haiku 5.5とは?
Claude Haiku 5.5は、大量かつ時間に敏感な作業向けのAnthropicの小型モデルです。Anthropicは2026年10月7日にリリースし、要約、分類、抽出、ルーティング、範囲を限定したサブエージェントタスク向けに位置付けています。Claude APIのモデルIDはclaude-haiku-5-5です。Claude Haiku 5.5のローンチ発表を参照してください。
Haiku 5.5のモデル概要には、テキストと画像の入力、テキスト出力、100万トークンのコンテキストウィンドウ、Messages APIで最大128,000出力トークンと記載されています。デフォルトではadaptive thinkingを使用します。大きなコンテキストウィンドウは容量を示すものであり、リポジトリ全体を送ることが有用または経済的だと示すものではありません。
私は、ビジネス全体を解釈させる前に、Haikuへ提供する段落、用語集、正確な編集タスクを渡します。依頼内容を狭くすることで、結果を確認しやすくなります。
Haiku 5.5は何に向いているか?
私が実際に使っている作業を起点にした、実践的な候補は次のとおりです。
その他に評価する価値がある作業として、提供されたドキュメントからのフィールド抽出、既知のカテゴリへのメッセージ分類、短いサポート会話の要約があります。これらは提案する用途であり、私自身のベンチマーク結果ではありません。
幅広いエンジニアリング作業では、モデルの選択を改めて検討する価値があります。Anthropicのローンチ資料では、より複雑なagentic codingにはSonnet 5.5とOpus 5.5を推奨しています。HaikuのEffortを上げても、大型モデルと同じ能力が保証されるわけではありません。
5つのEffortレベルは何を意味するか?
Haiku 5.5はlow、medium、high、xhigh、maxをサポートしています。デフォルトはmediumです。Effortは、モデルがレスポンスにどれだけ作業を費やすかを調整するものであり、固定トークン予算でも精度の保証でもありません。思考、回答テキスト、ツール呼び出しに影響します。AnthropicのEffortドキュメントを参照してください。
| Effort | 公式の開始時の指針 | 私が提案する用途 |
|---|---|---|
low | 短く、単純で、レイテンシーが重要なタスク | タイプミスの修正、または短く明確な翻訳 |
medium | 範囲を限定したコーディングを含む、ほとんどの作業のデフォルト | 通常の翻訳、または制約付きの小さなテキスト編集 |
high | 知識作業、長めのエージェントタスク、厳密な指示遵守 | 用語が曖昧な場合、または複数のルールを満たす必要がある編集 |
xhigh | 評価で品質向上が示された場合に使用 | 難しく範囲が限定されたタスクでの実験。Sonnetと比較する |
max | 評価で追加コストが正当化される場合に使用 | 低いレベルを確認した後の、例外的なテストケース |
私の開始ルールは、mediumから始め、見つかったエラーを使って調整することです。単純な修正ならlowを試します。用語集に敏感な翻訳なら、mediumとhighを比較します。設定が役立ったか判断できるよう、プロンプトと入力は同じにしてください。
デプロイは1つのコマンドだけで済む場合でも、大きな影響を伴うことがあります。私はEffortとは別に、検証と承認の要件を決めます。
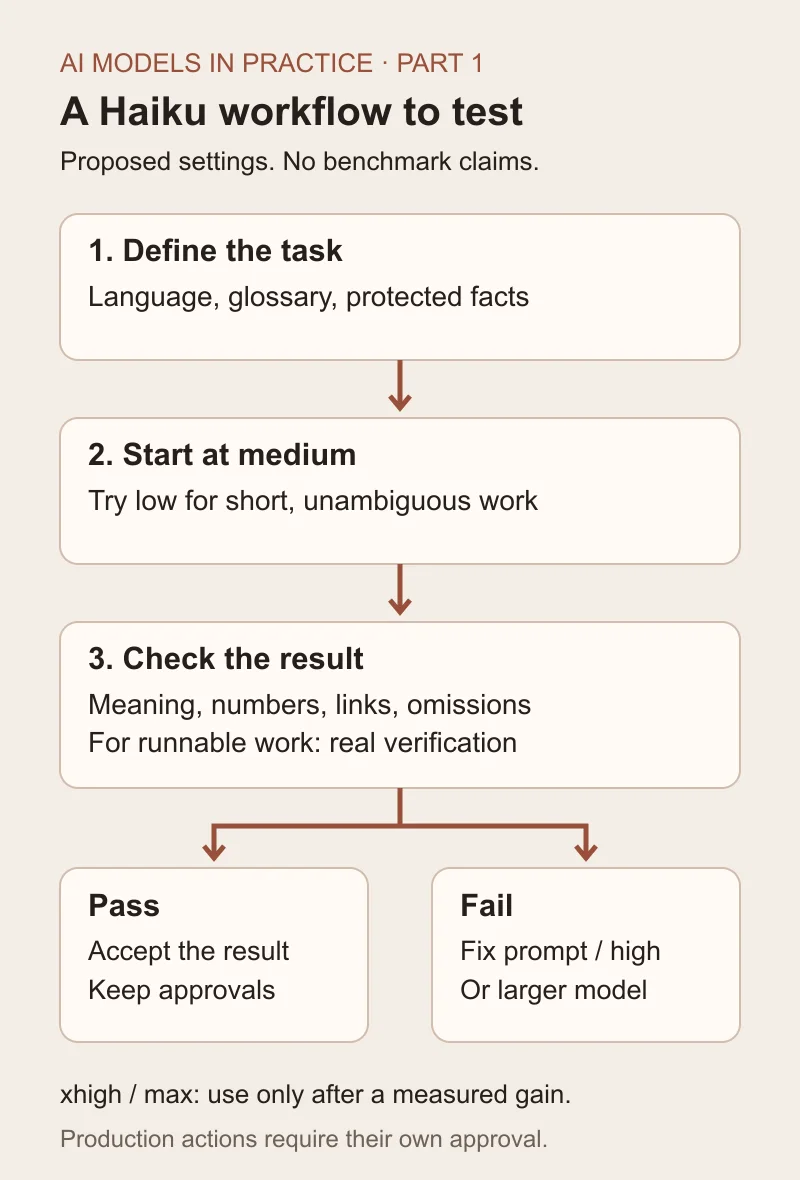
ベンチマークの証拠ではなく、提案するワークフローです。受け入れとは、そのタスクに必要なチェックを結果が通過したことを意味します。公開や本番環境での操作には、別途承認手順が残ります。
翻訳のEffortをどのように設定するか
翻訳は、1つのデフォルトですべてをカバーできない理由を示す最も明確な例です。これらの設定は評価のための開始仮説であり、測定済みの勝者ではありません。
短く、逐語的なテキストにはlow
短いステータスメッセージには曖昧さがほとんどありません。
text スウェーデン語からイギリス英語に翻訳してください。 翻訳のみを返してください。 注文番号と日付は変更しないでください。
原文: Din beställning 1842 skickades den 12 oktober 2026.
許容できる編集上の参照訳は、「Your order 1842 was dispatched on 12 October 2026.」です。重要なチェック項目は、注文番号、日付、意味です。英語として複数の表現が合格する可能性があります。
ここではlowを試し、詳細が抜けた場合に上げます。このプロンプトに余分な推論を加えるなら、より良い結果によってその価値が示されるべきです。
通常のWebサイトコピーにはmedium
段落の場合、私はmediumから始め、対象読者、ロケール、トーン、保護する用語を明示します。
text 提供されたスウェーデン語のテキストをイギリス英語に翻訳してください。 対象読者:サービスページを読む顧客。 トーン:直接的で親しみやすく。誇張したセールストークは避けてください。
保持するもの:
主張を追加したり、制限事項を削除したりしないでください。 翻訳のみを返してください。
原文: Vi uppdaterar normalt sidan inom två arbetsdagar. Tiden kan bli längre om underlaget behöver kompletteras.
編集上の参照訳は、「We normally update the page within two working days. It may take longer if we need additional information.」です。2日以内に更新すると約束するバージョンは、主張を変えています。
Anthropicの多言語サポートガイドでは、原言語と対象言語を明示し、地域的な文脈を考慮することを推奨しています。公開されている言語表はHaiku 4.5を含む旧モデルを対象としており、Haiku 5.5の翻訳精度の証拠ではありません。
用語や曖昧さに注意が必要な場合はhigh
用語によっては、ビジネス上の文脈に依存します。スウェーデン語の「reklamation」を自動的に「advertising」と訳すべきではありません。文によっては、不良品に関する苦情や申し立てを意味する適切な英訳になる可能性があります。
text この製品サポートテキストをスウェーデン語からイギリス英語に翻訳してください。 提供された用語集を使用し、すべての限定表現を保持してください。
用語集: reklamation = 不良品に関する苦情 återbetalning = 返金
表現が曖昧なままの場合は、別の注記で指摘してください。 方針を創作して不確実性を解消しないでください。 2つのセクションを返してください:TranslationとAmbiguities。
原文: Kontakta oss om du vill göra en reklamation. En återbetalning förutsätter att ärendet har godkänts.
この種のタスクではmediumとhighを比較します。成功基準は、翻訳が条件を保持し、意図した用語を使っているかどうかです。流暢な表現だけでは不十分です。
構造化コンテンツの場合、私は安定した識別子付きで翻訳対象の文字列を送ります。アプリケーション側で、すべての識別子が1回ずつ返され、保護された値が保持されていることを確認します。大きなJSONファイルを保持するようモデルに依頼しても、パースと検証の代わりにはなりません。
短いテキスト変更と修正
修正プロンプトでは、許可される編集を定義する必要があります。そうしないと、文法修正の依頼が書き直しに変わる可能性があります。
text この英語の段落のスペル、文法、句読点を修正してください。 私の文体、意味、数字、確実性の度合いを維持してください。 例、主張、見出し、宣伝的な表現を追加しないでください。 修正後の段落のみを返してください。
テキスト: We has updated the page, but the payment tests is not finished yet.
編集上の参照訳は、「We have updated the page, but the payment tests are not finished yet.」です。ページが完全にテスト済みだと述べるバージョンは、依頼内容に違反します。
このような文では、評価する設定としてlowが妥当です。複数の段落、保護されたリンク、複数の制約がある場合、私が提案する開始点はmediumです。
テキスト変更では、具体的な結果を依頼してください。「これを80語に短縮し、2つの制限事項を保持し、リンクを残してください」のようにします。語数とリンクの保持は、モデルとは別に実行できるチェックです。
軽微なデプロイ作業:完了の定義
私は単純なデプロイ作業をHaikuの用途に含めていますが、「単純」の範囲を明示する必要があります。承認済みのテキスト変更について既知のデプロイ手順を実行することは、壊れたリリースを診断したり、データベースの移行方法を決めたりする作業とは異なります。
再利用可能な指示は次のようになります。
text この承認済みのテキスト変更をデプロイ用に準備してください。 プロジェクトの現在のデプロイ手順と対象環境を確認してください。 差分を確認し、必要な検証を実行してください。
以下を報告してください:
認証情報、インフラストラクチャ、リリース範囲を変更しないでください。 私が承認するまで、commit、push、本番環境へのデプロイの前で停止してください。 承認済みのデプロイ後は、公開された結果を確認してください。 コマンドが成功しただけでは、変更が反映された証拠にはなりません。
準備とチェックにはmediumから始めます。複数のシステムにまたがる障害調査が必要な場合は、それを軽微なタスクと呼ぶのではなく、モデルとEffortを再評価します。
AnthropicのHaiku向けプロンプトガイドでは、長いプロンプトを使うlow-effortのエージェントは、早期に停止したりチェックを省略したりする可能性があると説明しています。明示的な検証指示を推奨しています。また、このガイドでは、xhighでのマルチターン会話において、表示される返信が空になることが時折ある点や、thinkingを無効にした状態で構造化出力を併用するとツール呼び出しに問題が起きる点にも触れています。統合側では、不完全な結果を検出し、黙って受け入れないようにする必要があります。
ClaudeまたはAPIでEffortを変更するには?
Claudeアプリでは、送信ボタンの横にあるモデルメニューを開き、Haiku 5.5を選択してからEffortを選びます。利用できる選択肢は、アカウントや管理者の設定によって異なる場合があります。Anthropicによると、ClaudeアプリではHaiku 5.5のthinkingをオフにできません。モデル、Effort、thinking設定の変更を参照してください。
APIでは、より直接的に制御できます。最小限のリクエストボディは次のようになります。
{ "model": "claude-haiku-5-5", "max_tokens": 16000, "thinking": { "type": "adaptive" }, "output_config": { "effort": "medium" }, "messages": [ { "role": "user", "content": "提供されたスウェーデン語の段落をイギリス英語に翻訳してください。名前、数字、リンクを保持してください。" } ] }
これはリクエスト形式の例であり、私が実行したリクエストではありません。段落はuserメッセージに含めてください。max_tokensは上限であり、予約枠でも長い回答を生成する指示でもありません。
AnthropicのHaiku 5.5移行ガイドでは、thinkingがその出力予算を消費するため、上限が小さいと表示テキストが現れる前にレスポンスが途中で切れる可能性があると説明しています。最初のブロックに回答が含まれると仮定せず、typeによってレスポンスブロックを選択してください。
新しいAPIリクエストでは、temperature、top_p、top_kを省略してください。以前のenabled-thinkingとbudget_tokensを組み合わせた設定は、adaptive thinkingに置き換えます。APIではlow、medium、highでthinkingを無効にできますが、xhighとmaxではadaptive thinkingが必要です。ガイドにはプロバイダーごとの差異も記載されているため、移行前に実際のプラットフォームを検証してください。
APIキーはサーバー上に保持してください。Effortフィールドは設定であり、フロントエンドコードに認証情報を置く理由にはなりません。
Haiku 5.5の料金は?
AnthropicのAPI料金ドキュメントには、2026年10月12日に確認した、100万トークンあたりの標準料金(USD)が次のように記載されています。
| プロンプト長 | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| 最大100,000トークン | $0.10 | $0.50 | $0.01 |
| 100,000トークン超 | $0.50 | $2.50 | $0.05 |
高い料金は、キャッシュ読み取りまたは書き込みとして計上される入力を含め、リクエストに適用されます。これらはAPIのトークン料金であり、Claudeのサブスクリプションは別の製品です。キャッシュ書き込み、サーバーツール、プラットフォームによる追加料金が発生する場合があります。
入力トークン2,000、請求対象となる出力トークン合計1,000の、キャッシュを使用しない例示的なリクエストでは次のようになります。
text 入力: 2,000 / 1,000,000 × $0.10 = $0.00020 出力: 1,000 / 1,000,000 × $0.50 = $0.00050 合計: $0.00070
この計算には追加料金が含まれておらず、測定済みの翻訳コストでもありません。thinkingも請求対象の出力に含まれます。Effortを高くするとトークン使用量が変わる可能性があるため、料金表だけでは完了したタスクのコストを予測できません。
これらの作業全体で維持したいベストプラクティス
モデルには、完全性を保った最小限のタスクを与えてください。必要な用語集や承認済みの原文を含め、関係のない資料は避けます。
出力の契約を明示してください。翻訳では、2つの言語とロケールを指定します。編集では、どの事実と書式を保持する必要があるかを指定します。エージェントでは、チェック項目と停止地点を定義します。
原文は変換対象のコンテンツとして扱ってください。ドキュメントに埋め込まれた文に、タスクを変更したり、認証情報へアクセスしたり、コンテンツを公開したりする権限を与えてはいけません。
タスクに照らして結果を検証してください。保護された用語、数字、リンク、抜け落ちた箇所を確認します。コードやデプロイ作業では、実際のテスト結果とランタイム上の証拠を確認してください。
具体的な失敗を基準にエスカレーションしてください。限定表現の欠落は、別のプロンプトやEffortレベルが必要であることを示します。拡大し続けるタスクには、SonnetやOpusが必要かもしれません。失敗が繰り返される場合は、Effortを際限なく上げるのではなく、見直しを行うべきです。
設定に依存する前に、どのようにテストするか
私は、承認済みで匿名化した20件の例から小規模な評価セットを作ります。内訳は翻訳10件、修正5件、制約付きテキスト編集5件です。これらの数は提案するテストを示すものであり、完了した研究ではありません。
同じ入力と合格基準でlow、medium、highを実行します。一貫性のない挙動を明らかにするため、ケースを繰り返します。設定を見せずに、流暢なレビュアーに翻訳を評価してもらいます。
正確なモデル、Effort、プロンプトのバージョン、経過時間、請求トークン、欠陥を記録します。失われた限定表現、変更された数字、壊れたリンク、省略されたテキスト、不要な書き直しを数えます。修正作業を含め、合格した結果1件あたりのコストを比較します。
デプロイ支援については、既知の期待結果がある非本番環境で、準備作業を個別に評価します。本番環境での操作は、引き続きプロジェクトの承認手順に従います。
私の既存の実際の作業向けAIモデルベンチマークガイド→では、より広い評価方法を扱っています。GPT-6.1 SolとOpus 5.5の比較→は、大型モデルを選ぶ際の背景を提供しますが、Haikuの翻訳テストではありません。
シリーズは小さな作業から始まる
Haikuを最初のパートにしたのは、翻訳、修正、短い編集によってトレードオフが見えやすくなるからです。文が意味を保っているか、リンクが残っているかを確認できます。
次のパートでは、日常的なコーディングと分析にSonnetを使う方法、より難しい作業にOpusを使う方法、そしてモデル間でタスクを振り分けるための最終ガイドを扱う予定です。各パートで同じ区別を用います。つまり、文書化された能力、私自身の利用実績、そして今後実施するテストです。