GPT-6.1 Sol retient mon attention parce que je veux exécuter davantage de tâches agentiques utiles sans considérer chaque tâche comme une dépense réservée aux modèles premium. La vraie question est de savoir quelle quantité de travail correct et vérifiable je peux obtenir avec ce budget.
Ma première impression : Sol mérite sa place dans la discussion sur le modèle utilisé au quotidien. Claude Opus 5.5 mérite toujours une comparaison sérieuse, surtout lorsque la qualité compte davantage que le temps de réponse initial. Je testerai les deux sur du travail réel. Pour l’instant, je sépare les benchmarks publiés, les retours des premiers utilisateurs et mes propres attentes.
*Vérification des sources : 29 septembre 2026. L’image principale est une illustration éditoriale générée par AI. J’ai créé les graphiques de données à partir des valeurs publiées citées ; il ne s’agit pas de captures d’écran de mes propres tests.*
À quoi GPT-6.1 Sol est-il destiné ?
OpenAI positionne GPT-6.1 Sol pour le codage complexe, l’utilisation d’un ordinateur et le travail professionnel, avec l’objectif de se rapprocher d’Astra à un prix inférieur. Son identifiant de modèle API est gpt-6.1-sol, avec une fenêtre de contexte de 1 050 000 tokens et jusqu’à 128 000 tokens de sortie. Consultez la documentation officielle du modèle GPT-6.1 Sol.
Pour mon travail, cela suggère trois points de départ utiles :
Ce sont des candidats à l’évaluation, et non des promesses que le modèle les gérera sans supervision. Je continuerais à maintenir les écritures en production derrière une approbation et à exiger que l’agent présente ses éléments de preuve.
Cela reprend la même question pratique que dans mon analyse de GPT-6 Astra : le modèle aide-t-il à terminer le travail une fois qu’il est intégré à un système existant ?
Prix de GPT-6.1 Sol contre Claude Opus 5.5
La comparaison standard des API est simple. Il s’agit de prix en USD par million de tokens, avant les outils, les écritures de cache, les suppléments de vitesse ou les modificateurs régionaux.
| Type de token | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Entrée | $2.00 | $4.00 |
| Entrée mise en cache | $0.10 | $0.20 |
| Sortie | $10.00 | $20.00 |
Sources : tarification de l’API OpenAI et tarification de Claude Platform.
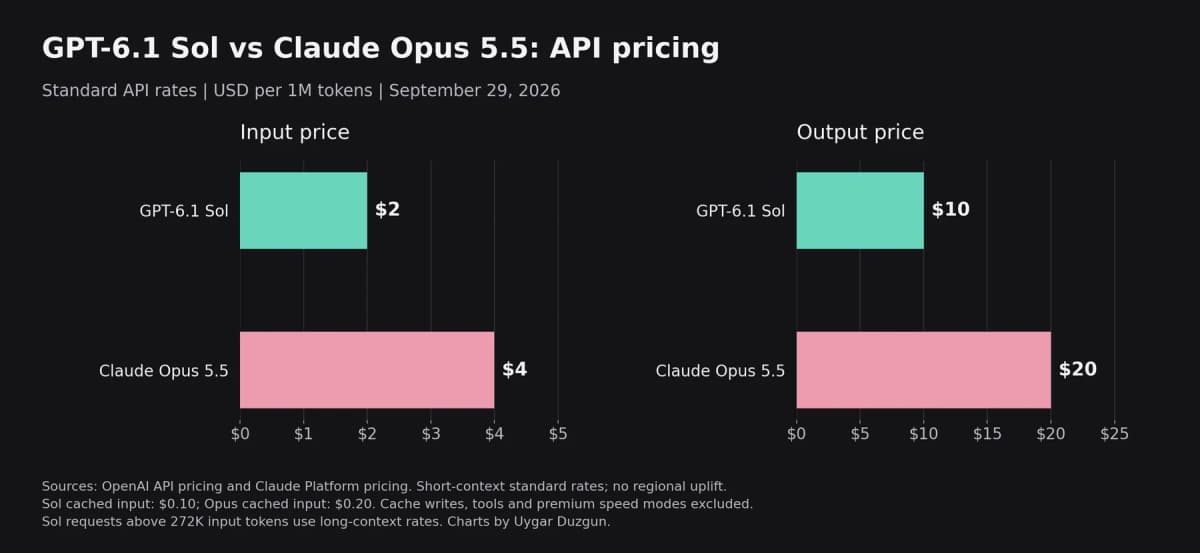
*Tarifs standard pour un contexte court. Le tableau inclut les lectures mises en cache ; le graphique montre les prix ordinaires de l’entrée et de la sortie.*
Sol coûte deux fois moins cher par token dans ces catégories. Cela ne signifie pas que chaque tâche terminée coûte deux fois moins cher. Les modèles peuvent utiliser des quantités différentes de raisonnement, appeler des outils différents et nécessiter un nombre différent de nouvelles tentatives.
Le contexte long modifie également la comparaison. Sol applique des tarifs plus élevés à l’intégralité de la requête au-delà de 272 000 tokens d’entrée dans un même prompt : deux fois le tarif de l’entrée et de l’entrée mise en cache, et 1,5 fois le tarif de sortie. Anthropic indique une tarification standard pour l’ensemble de la fenêtre de contexte d’Opus 5.5. Le compteur cumulé de tokens d’une session longue n’est pas la même chose qu’un prompt qui franchit ce seuil.
Pour le contexte de la sortie précédente, mon aperçu de GPT-6 Sol et Luna couvre la gamme précédente.
Benchmarks de GPT-6.1 Sol : score et coût ensemble
AutomationBench : Sol est moins cher ; Opus atteint un score supérieur au maximum
AutomationBench 1.0.6 teste des workflows professionnels de bout en bout à travers 47 outils. Zapier évalue l’état obtenu avec des vérifications déterministes, plutôt que de demander à un autre modèle de langage de juger la réponse.
| Configuration | Score | USD par tâche tentée |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, moyen | 31.7% | $0.19 |
| Opus 5.5, moyen, replis par défaut | 29.5% | $0.65 |
| Sol 6.1, maximum | 36.1% | $0.30 |
| Opus 5.5, maximum, replis par défaut | 42.5% | $1.44 |
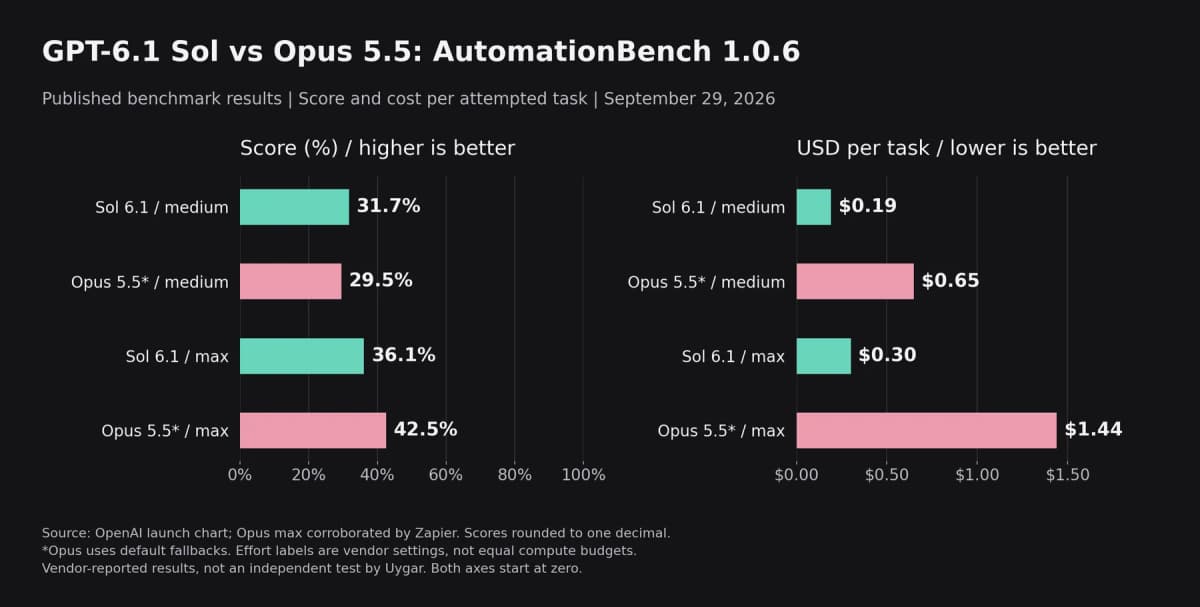
*Valeurs issues des graphiques de lancement d’OpenAI, avec des scores arrondis à une décimale. Zapier confirme le résultat maximal d’Opus. La configuration d’Opus inclut des replis par défaut ; les labels d’effort des fournisseurs ne représentent pas des budgets de calcul équivalents.*
À effort moyen, Sol offre une avance modeste au niveau du score et un coût par tâche rapporté inférieur. Au maximum, Opus obtient le score le plus élevé. Je choisirais entre ces compromis en fonction du coût d’un échec du workflow, y compris le temps passé par quelqu’un à le vérifier.
Ces coûts couvrent les tâches tentées, y compris les échecs. Il ne s’agit pas de prix garantissant un résultat professionnel réussi.
DeepSWE : une amélioration utile par rapport au Sol précédent
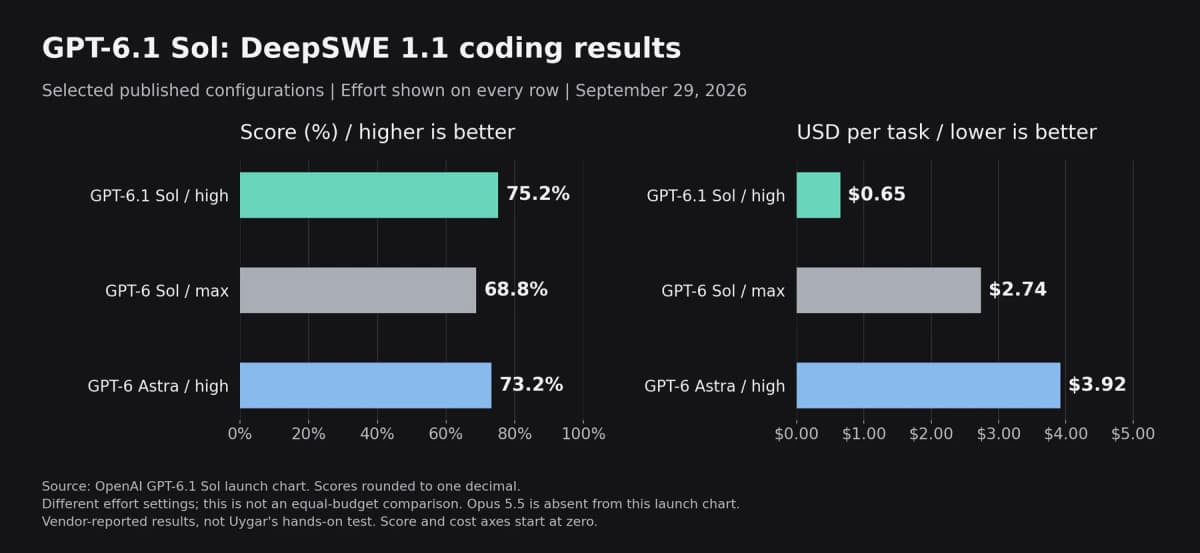
*Valeurs sélectionnées de DeepSWE 1.1 issues des mêmes graphiques de lancement d’OpenAI : Sol 6.1 élevé, 75.2% à $0.65 ; Sol précédent maximal, 68.8% à $2.74 ; Astra élevé, 73.2% à $3.92 par tâche. Les différents niveaux d’effort sont explicitement indiqués.*
Le benchmark DeepSWE utilise des tâches de dépôt à long horizon et des vérificateurs comportementaux. OpenAI n’inclut pas Opus 5.5 dans ce graphique de lancement. Je ne placerai pas à côté un score FrontierCode sans rapport en prétendant qu’ils mesurent la même chose.
OpenAI combine ses propres évaluations avec les résultats de concurrents rapportés publiquement. Considérez cela comme des éléments publiés, et non comme un test indépendant en face-à-face réalisé par moi.
Pourquoi Claude Opus 5.5 reste important
Anthropic positionne Opus 5.5 pour le codage et le travail de connaissance de longue durée. Son rapport de lancement indique un score de 54.6% à FrontierCode v1.1 Main avec l’effort moyen par défaut et décrit des progrès dans le codage multi-fichiers. Ces résultats utilisent un benchmark différent de DeepSWE. Anthropic inclut également les premiers retours de partenaires concernant une réduction du nombre d’étapes et de tokens ; il s’agit toujours de retours attribués, et non d’une comparaison contrôlée avec Sol 6.1. Consultez l’annonce d’Opus 5.5.
Je conserverais Opus dans la comparaison pour les modifications difficiles, la revue et le travail visuel, lorsqu’un passage supplémentaire pourrait améliorer le résultat final. Je testerais cette hypothèse plutôt que d’attribuer au modèle un rôle de spécialiste permanent sur la base de sa semaine de lancement.
Mon analyse des benchmarks et des réactions concernant Claude Opus 5.5 couvre sa sortie plus en détail.
Que disent les autres utilisateurs ?
Les premières réactions sont mitigées. Dans une discussion de lancement sur Reddit, certains utilisateurs ont apprécié les lectures de cache moins coûteuses ; d’autres se sont demandé à quel point le modèle semblerait proche d’Astra et ont préféré Claude. Il s’agit de réactions individuelles, et non d’une enquête représentative.
Un autre test concret de trois modèles réalisé par digitalml a utilisé le même prompt de scène cinématique Three.js avec un effort moyen. Les temps rapportés étaient de 8 minutes 42 secondes pour Sol 6.1, 9 minutes 37 secondes pour Astra et 38 minutes 54 secondes pour Opus 5.5. L’auteur a préféré le résultat cinématique d’Opus et a signalé des problèmes de caméra et de son dans la version de Sol.
Cet exemple unique illustre un compromis qui mérite d’être étudié : terminer en premier peut compter, mais le niveau de finition et le comportement après le chargement de la page comptent également. Il n’établit pas de classement général en matière de vitesse ou de qualité.
Comment je vais tester GPT-6.1 Sol
Je donnerai à Sol et à Opus la même tâche, les mêmes fichiers de départ, le même accès aux outils et les mêmes vérifications d’acceptation. Je veux enregistrer la correction, le temps écoulé, les nouvelles tentatives, le coût en tokens et le travail de vérification qu’il me reste à effectuer. Une réponse rapide qui me laisse corriger des régressions n’est pas un résultat bon marché.
Pour les intégrations API, Sol nécessite la Responses API pour les appels d’outils ; Chat Completions les prend en charge sans outils. Il prend en charge les niveaux d’effort de raisonnement low, medium, high, xhigh et max, medium étant la valeur par défaut. La documentation du modèle ci-dessus définit ces contraintes.
Mon point de départ pratique est un effort moyen, un brief délimité et des vérifications exécutables. J’augmenterai l’effort lorsqu’une tâche l’exigera, puis je comparerai le résultat. Un raisonnement plus approfondi doit justifier le temps et le coût supplémentaires.
J’ai hâte d’essayer GPT-6.1 Sol, car le rapport prix-performance publié semble utile pour un travail agentique répétitif. Opus 5.5 reste une alternative solide. Je déciderai de la place de chacun après avoir obtenu des éléments concrets à partir des tâches que je dois terminer.
---