Mon objectif Codex de longue durée : quatre jours et toujours en cours
Le 9 octobre 2026, mon objectif Codex de longue durée affichait 4 jours, 14 heures, 8 minutes et 22 secondes. J’ai pris une capture d’écran alors que Codex travaillait encore sur un produit SEO que je n’ai pas encore lancé. L’objectif était toujours ouvert et il restait des tâches à accomplir.
Je lui avais demandé de réaliser l’intégralité du plan du produit SEO non publié que je construis. À ce stade, je lui avais également demandé d’utiliser davantage d’agents, de réduire l’effort de raisonnement, de faire des pauses pour fournir des mises à jour, de reprendre après un redémarrage et de consacrer moins de temps à répéter les tests.
Voici mon récit d’un objectif Codex de longue durée : le travail produit, celui qui l’a ralenti et les décisions que je devais encore prendre. Il s’agit d’une construction inachevée, pas d’un benchmark ni d’une annonce de lancement.
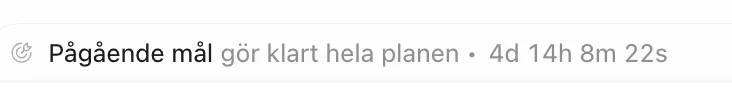
Le minuteur ci-dessus correspond à l’objectif. Il ne prouve pas quatre jours de calcul ininterrompu du modèle. Ma session comprend des pauses et reprises explicites, une mise à jour de l’application, un redémarrage de l’ordinateur, l’exécution d’outils et des temps d’attente.
Ce que j’ai demandé à Codex de construire
La conversation a commencé le 3 octobre par une question plus limitée : les utilisateurs disposent-ils de leurs propres identifiants de connexion, peuvent-ils se connecter avec Google et peuvent-ils générer des clés MCP personnelles ?
J’ai ensuite élargi les exigences. Chaque utilisateur devait voir ses propres projets. Les utilisateurs devaient pouvoir inviter des personnes dans un espace de travail. Je voulais des paramètres pour les préférences personnelles et la concurrence du crawler. La plateforme serait finalement commerciale, avec un lancement initial gratuit.
J’ai fourni un catalogue de produits SEO beaucoup plus vaste pour orienter la construction. Le plan qui en a résulté couvrait 15 domaines de produits, 42 références d’applications et 19 outils gratuits publics, ainsi qu’une fonctionnalité de classement du trafic des sites web. Il comprenait le SEO technique, la recherche de mots-clés, les classements, les backlinks, la visibilité dans l’AI, le contenu, l’analytics, le SEO local et, plus tard, des fonctionnalités pour les entreprises.
Je voulais également que le produit commande des articles auprès du moteur de contenu qui alimente mon propre site web.
L’instruction de terminer l’intégralité du plan faisait donc référence à une feuille de route produit substantielle. C’est moi qui ai contribué à définir cette portée. Un minuteur de quatre jours pour corriger un petit bug raconterait une tout autre histoire.
Quel modèle et quels paramètres j’ai utilisés
Le journal principal de la session identifie le modèle comme GPT-6.1 Sol, avec l’identifiant gpt-6.1-sol. Les tours enregistrés utilisent des paramètres de raisonnement ultra, medium et, dans une moindre mesure, high. Cela identifie la session principale ; cela ne permet pas d’établir quel modèle se trouvait derrière chaque réviseur ou outil externe.
Le 5 octobre, j’ai explicitement réglé l’effort sur medium pour économiser des tokens. J’ai ensuite désactivé turbo pour la même raison. Il s’agissait de mes intentions, et non d’économies mesurées : je ne dispose pas d’une comparaison des coûts auditée pour les deux configurations.
J’ai également demandé davantage d’agents parallèles. La session a utilisé du travail délégué et des évaluations par les pairs avec Claude pour certaines parties de l’implémentation. Cela a permis à des tâches distinctes d’avancer, mais a également créé du travail pour rapprocher leurs résultats et vérifier l’ensemble obtenu.
Mon précédent comparatif GPT-6.1 Sol→ couvre les données publiées sur les modèles. Cette construction constitue un autre type de preuve : un projet réel avec une portée et des paramètres changeants, plutôt qu’une comparaison contrôlée entre modèles.
Combien de temps un objectif Codex peut-il continuer à travailler ?
Dans ce cas, l’interface a affiché plus de quatre jours pour le même objectif en cours. C’est l’observation que je peux étayer. Il ne s’agit pas d’une garantie de durée d’exécution maximale, et je ne peux pas calculer le temps d’inférence actif à partir de la capture d’écran.
OpenAI décrit les objectifs dans Codex comme des objectifs qui persistent d’un tour à l’autre. Codex peut continuer à avancer vers un résultat, tandis que l’utilisateur peut le mettre en pause ou le reprendre. L’achèvement, les interruptions, les budgets et les blocages influencent la poursuite du travail.
Mon expérience correspond à ce flux de travail persistant. Je pouvais revenir au même objectif après des pauses et orienter le travail suivant. Il était utile de conserver la cible disponible. Cela ne rendait pas la cible plus petite et ne garantissait pas que chaque nouveau tour rapprocherait le produit du lancement.
Qu’avait-il livré au 9 octobre ?
Le journal de livraison du 9 octobre indiquait 30 exigences partiellement terminées, 39 non évaluées et zéro exigence pleinement acceptée sur une liste de suivi de 69 points.
Ce décompte doit être replacé dans son contexte. La liste mesure l’acceptation globale du produit. Zéro exigence pleinement acceptée ne signifie pas qu’il n’existe aucun code fonctionnel. De même, 30 exigences partielles ne signifient pas que le produit est terminé à 43 %.
Le journal consigne un test smoke local et jetable d’une base de comptes prise en charge : créer le premier compte, se connecter avec un mot de passe, lire la session et l’espace de travail privé de son propriétaire, puis se déconnecter et rejeter l’ancienne session. Il s’agit d’un parcours utilisateur concret avec un résultat de test limité. Cela ne prouve pas que la dernière version complète de l’application est prête pour les clients.
Les autres avancées comprenaient l’intégration locale du code source de réinitialisation du mot de passe, des brouillons d’examen des backlinks, le travail sur des rapports Search Console enregistrés, le transport d’un rapport GA4 avec le token du client et le travail sur des brouillons d’articles destinés à LinkedIn. Plusieurs de ces éléments avaient encore une activation désactivée, une intégration incomplète ou une vérification reportée.
Les points de contrôle datés indiquaient explicitement qu’aucun commit, push ou déploiement n’avait été effectué. La connexion Google et la préparation complète pour les clients restaient non vérifiées. Je disposais d’une implémentation locale croissante, accompagnée d’éléments de preuve utiles, plutôt que d’une plateforme publiée.
Qu’est-ce qui a ralenti mon objectif Codex de longue durée ?
J’ai transformé l’objectif en feuille de route produit
Ajouter la connexion Google semble être une seule fonctionnalité. Ajouter des clients privés modifie les personnes autorisées à accéder aux projets, aux rapports, aux tâches en arrière-plan et aux intégrations. Je voulais que cette séparation soit respectée dans toute l’application.
J’ai ensuite ajouté la recherche de mots-clés, les backlinks, la génération de contenu et un catalogue beaucoup plus vaste. Une partie du temps écoulé reflète le travail nécessaire sur une cible étendue. Mon objectif initial permettait facilement de continuer à ouvrir la prochaine zone inachevée.
Le processus de vérification est devenu trop répétitif
J’ai demandé des décisions étayées par les sources, des modifications limitées, des revues et des preuves explicites. Ces instructions ont contribué à éviter les affirmations vagues selon lesquelles quelque chose était terminé.
Mais la session a accumulé des vérifications répétées des sources, la préparation des revues et le travail sur les fixtures de test. Mon jugement est que l’équilibre a trop penché vers la preuve de chaque élément avant de terminer le prochain parcours utilisable.
Le 9 octobre, je lui ai demandé de consacrer moins de temps aux tests, de travailler à l’achèvement et de laisser un test plus vaste pour plus tard. Cela n’a pas supprimé la nécessité de vérifier l’isolation des comptes. Cela a modifié l’ordre des opérations : des vérifications ciblées pendant l’implémentation, suivies d’une validation plus large du parcours assemblé.
Certains échecs provenaient de la configuration des tests
Une tentative sur la base de données de réinitialisation du mot de passe a échoué parce qu’un enregistrement de compte synthétique ne comportait pas un champ obligatoire de nom d’affichage. Réparer cette fixture était nécessaire pour exécuter le test, mais il ne s’agissait pas d’une nouvelle fonctionnalité produit.
Une tentative ultérieure de longue durée sur la base de données s’est terminée lorsque le poste de travail a redémarré. Le journal de livraison n’a pas affirmé que cette tentative avait réussi. Le diagnostic ultérieur a révélé le recalcul répété de contrats de vérification précédents et la mise en mémoire tampon de la sortie de progression, ce qui rendait le processus en cours plus difficile à évaluer.
Ces détails sont importants, car l’attente est ambiguë. Un processus actif peut être en train de travailler, de recalculer la même condition préalable ou de produire une sortie que je ne peux pas encore voir. Le minuteur seul ne peut pas me dire lequel de ces cas se produit.
Davantage d’agents a ajouté de la coordination
Le travail parallèle a été utile pour les tâches séparables. La session principale devait tout de même examiner les résultats, résoudre les dépendances et intégrer les modifications dans une seule application. Je ne peux pas attribuer d’accélération à l’ajout d’agents, car je n’ai pas exécuté le même projet avec et sans eux.
La question pratique est devenue de savoir si un autre agent pouvait terminer une partie indépendante ou s’il allait créer une nouvelle transmission à gérer pour la session principale.
Ce que je fais encore en tant qu’humain
Je choisis l’orientation du produit et je décide quelles fonctionnalités sont prioritaires. Je vérifie si les progrès rapportés décrivent un comportement fonctionnel, du code source local ou une proposition non vérifiée. Je mets le travail en pause lorsque je dois mettre Codex à jour ou redémarrer l’ordinateur, puis je lui demande de reprendre à partir de son état sauvegardé.
Je remets également le rythme en question. Pendant cette construction, j’ai :
Le plan et le journal de livraison me donnent quelque chose à examiner au-delà des messages de chat. Ils exigent également de la rigueur : un point de contrôle daté n’est utile que s’il indique ce qui a changé et ce qui reste à prouver.
Cette expérience prolonge le compromis que j’ai décrit dans Je pensais que l’AI me donnerait plus de temps libre→. Je peux tenter une construction plus ambitieuse, mais je consacre toujours du temps à décider ce qui mérite d’être construit et à vérifier le résultat.
Les avantages et les inconvénients jusqu’à présent
D’après mon expérience avec cette construction, le principal avantage est la continuité. Je peux conserver un objectif substantiel ouvert et le reprendre après des interruptions. Codex a produit des implémentations locales, étudié des échecs et conservé des comptes rendus détaillés qui m’aident à examiner le travail.
Il peut également gérer plusieurs types de tâches au sein d’un même projet : modifications de base de données, comportement de l’API, parcours frontend, transports d’intégration et documentation. Cela rend possible pour moi la direction d’une construction étendue.
L’inconvénient est que l’activité peut ressembler à du progrès. De nombreuses vérifications réussies peuvent coexister avec un produit inachevé. Un effort de raisonnement élevé et davantage d’agents introduisent des choix budgétaires et de coordination sans garantir une livraison plus rapide.
Les longues exécutions rendent également la discipline de portée plus difficile. Une feuille de route partiellement terminée offre à l’agent de nombreuses prochaines actions défendables. Je dois décider laquelle fournit le prochain résultat utile.
Je réutiliserais un objectif persistant, mais je donnerais à chaque étape d’implémentation une cible d’acceptation plus petite. Par exemple : créer un compte, se connecter, voir son espace de travail privé et rejeter l’accès d’un deuxième compte. Conserver la feuille de route plus vaste comme contexte, terminer ce parcours, puis passer au suivant.
Ce que je mesurerai ensuite
Le produit SEO est toujours en développement et n’avait pas été lancé au 9 octobre. La prochaine mesure utile est un parcours utilisateur complet sur l’application actuellement assemblée, avec la liste explicite des blocages restants.
Ensuite, je veux des preuves concernant la connexion Google, les intégrations liées aux clients, les clés MCP personnelles et une mise en production sûre. Codex continue de traiter les tâches ; cet article consigne la situation au 9 octobre. J’évaluerai la construction en fonction de ces résultats plutôt qu’en fonction de la durée pendant laquelle l’objectif reste ouvert.
Sources et limites de ce récit
Le minuteur provient de ma capture d’écran ci-dessus. L’identifiant du modèle, les modifications des paramètres et mes interventions proviennent de l’historique de la session principale. La portée et les chiffres de progression proviennent du plan du projet et de son journal de livraison daté. Ces documents de projet sont des documents de travail privés ; je n’ai pas publié les journaux ni les données clients.
Le guide d’OpenAI Using Goals in Codex explique le flux de travail fondé sur un objectif persistant. Il étaye la description des Goals, mais pas les affirmations de livraison concernant mon projet.
Le décompte de 69 points constitue un instantané général de l’acceptation, et non une mesure du nombre d’heures restantes. La capture d’écran ne prouve pas une inférence ininterrompue, les modifications de paramètres ne prouvent pas d’économies de coûts et les vérifications locales n’établissent pas la préparation à la production. Cette construction est toujours en cours.
*Cet article a été rédigé avec l’aide de l’AI à partir de ma capture d’écran, de l’historique de la session et des documents de livraison du projet. Il décrit une construction en cours. Il n’établit ni une limite générale de durée d’exécution de Codex, ni un classement des modèles, ni un coût audité, ni une préparation à la production.*