GPT-6.1 Sol hat meine Aufmerksamkeit, weil ich mehr nützliche Agentenarbeit erledigen möchte, ohne jede Aufgabe als Ausgabe für ein Premium-Modell zu behandeln. Die interessante Frage ist, wie viel korrekte und überprüfbare Arbeit ich für mein Budget bekomme.
Mein erster Eindruck: Sol verdient einen Platz in der Diskussion um den täglichen Einsatz. Claude Opus 5.5 verdient weiterhin einen ernsthaften Vergleich, besonders wenn Qualität wichtiger ist als die erste Antwortzeit. Ich werde beide mit echter Arbeit testen. Vorerst trenne ich veröffentlichte Benchmarks, erste Nutzerberichte und meine eigenen Erwartungen.
*Quellenprüfung: 29. September 2026. Das Hero-Bild ist eine von AI erzeugte redaktionelle Illustration. Die Datencharts habe ich aus den zitierten veröffentlichten Werten erstellt; sie sind keine Screenshots meiner eigenen Tests.*
Wofür eignet sich GPT-6.1 Sol?
OpenAI positioniert GPT-6.1 Sol für komplexe Programmierung, Computernutzung und professionelle Arbeit und zielt dabei auf eine Leistung näher an Astra zu einem niedrigeren Preis. Die API-Modell-ID lautet gpt-6.1-sol, mit einem Kontextfenster von 1.050.000 Tokens und bis zu 128.000 Ausgabe-Tokens. Siehe die offizielle GPT-6.1-Sol-Modelldokumentation.
Für meine Arbeit deutet das auf drei sinnvolle Ausgangspunkte hin:
Das sind Kandidaten für eine Evaluierung, keine Versprechen, dass das Modell diese Aufgaben unbeaufsichtigt erledigt. Produktionsänderungen würde ich weiterhin nur nach Freigabe zulassen und vom Agenten verlangen, seine Belege zu zeigen.
Das folgt derselben praktischen Frage wie meine GPT-6-Astra-Review: Hilft das Modell dabei, die Arbeit abzuschließen, sobald es auf ein bestehendes System trifft?
GPT-6.1-Sol-Preise im Vergleich zu Claude Opus 5.5
Der standardmäßige API-Vergleich ist unkompliziert. Dies sind USD-Preise pro einer Million Tokens, vor Tools, Cache-Schreibvorgängen, Geschwindigkeitsaufschlägen oder regionalen Anpassungen.
| Tokentyp | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Eingabe | $2.00 | $4.00 |
| Zwischengespeicherte Eingabe | $0.10 | $0.20 |
| Ausgabe | $10.00 | $20.00 |
Quellen: OpenAI-API-Preise und Claude-Platform-Preise.
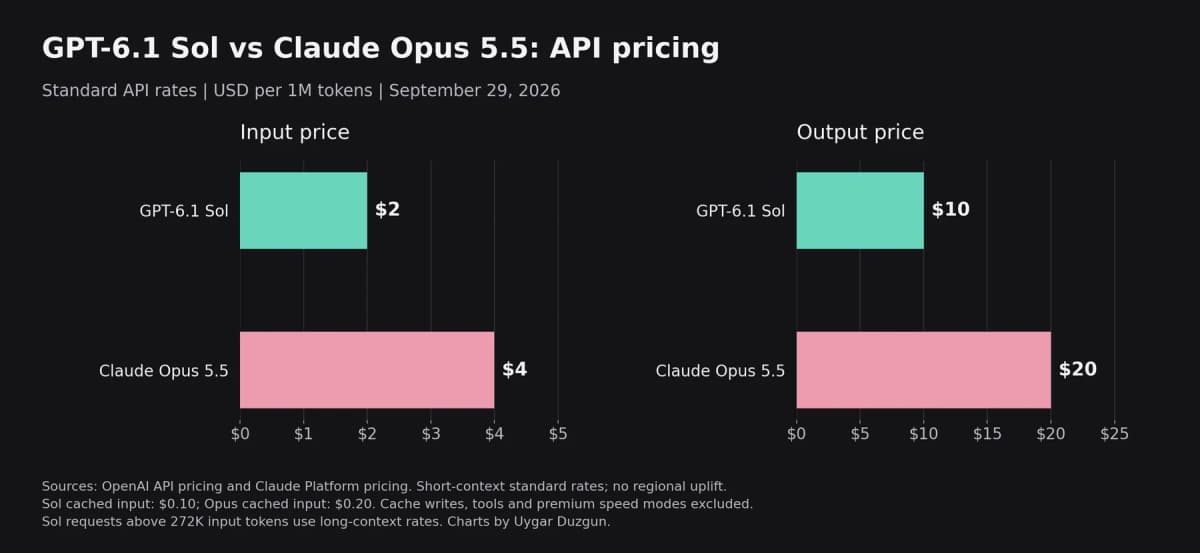
*Standardtarife für kurze Kontexte. Die Tabelle enthält zwischengespeicherte Lesevorgänge; der Chart zeigt die normalen Preise für Eingabe und Ausgabe.*
Sol kostet in diesen Kategorien pro Token halb so viel. Das bedeutet nicht, dass jede abgeschlossene Aufgabe halb so viel kostet. Modelle können unterschiedlich viel Reasoning verwenden, verschiedene Tools aufrufen und unterschiedlich viele Wiederholungsversuche benötigen.
Auch der lange Kontext verändert den Vergleich. Sol wendet auf die gesamte Anfrage oberhalb von 272.000 Eingabe-Tokens in einem Prompt höhere Tarife an: den doppelten Satz für Eingaben und zwischengespeicherte Eingaben sowie den 1,5-fachen Satz für Ausgaben. Anthropic führt Standardpreise über das gesamte Kontextfenster von Opus 5.5 hinweg auf. Der aggregierte Token-Zähler einer langen Sitzung ist nicht dasselbe wie ein einzelner Prompt, der diese Schwelle überschreitet.
Als Hintergrund zur früheren Veröffentlichung behandelt meine Übersicht zu GPT-6 Sol und Luna die vorherige Modellreihe.
GPT-6.1-Sol-Benchmarks: Score und Kosten gemeinsam betrachten
AutomationBench: Sol ist günstiger; Opus erreicht bei maximalem Aufwand mehr
AutomationBench 1.0.6 testet durchgängige Geschäfts-Workflows über 47 Tools hinweg. Zapier bewertet den resultierenden Zustand mit deterministischen Prüfungen, statt ein anderes Sprachmodell um die Beurteilung der Antwort zu bitten.
| Konfiguration | Score | USD pro versuchter Aufgabe |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, mittel | 31.7% | $0.19 |
| Opus 5.5, mittel, standardmäßige Fallbacks | 29.5% | $0.65 |
| Sol 6.1, maximal | 36.1% | $0.30 |
| Opus 5.5, maximal, standardmäßige Fallbacks | 42.5% | $1.44 |
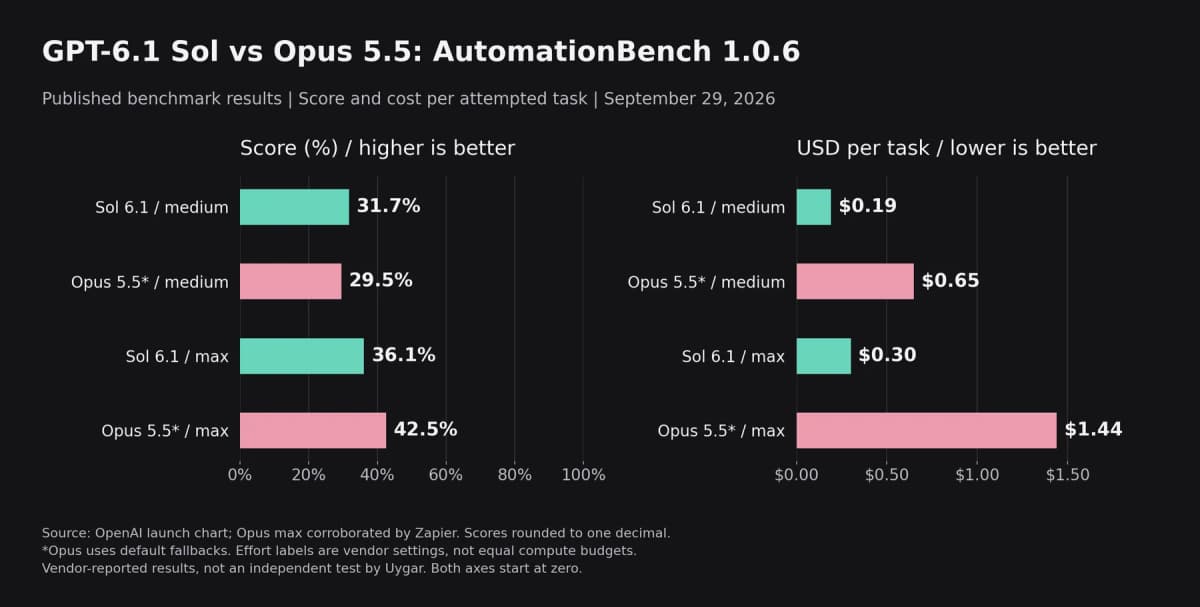
*Werte aus OpenAIs Launch-Charts, wobei die Scores auf eine Dezimalstelle gerundet wurden. Zapier bestätigt das Opus-Ergebnis bei maximalem Aufwand. Die Opus-Konfiguration enthält standardmäßige Fallbacks; die Aufwandsbezeichnungen der Anbieter stehen nicht für gleich große Compute-Budgets.*
Bei mittlerem Aufwand bietet Sol einen moderaten Score-Vorsprung und niedrigere gemeldete Aufgabenkosten. Bei maximalem Aufwand hat Opus den höheren Score. Zwischen diesen Abwägungen würde ich anhand der Fehlerkosten des Workflows entscheiden, einschließlich der Zeit, die jemand für die Prüfung aufwendet.
Diese Kosten decken versuchte Aufgaben einschließlich Fehlern ab. Es handelt sich nicht um Preise für ein garantiert erfolgreiches Geschäftsergebnis.
DeepSWE: ein nützliches Upgrade gegenüber dem vorherigen Sol
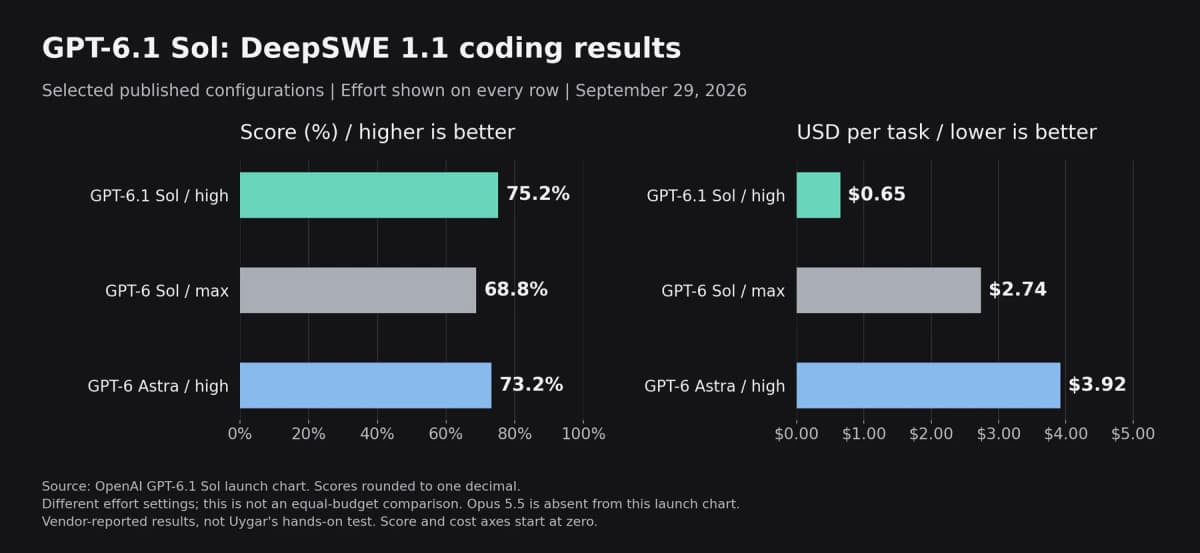
*Ausgewählte DeepSWE-1.1-Werte aus denselben OpenAI-Launch-Charts: Sol 6.1 hoch, 75.2% bei $0.65; vorheriger Sol maximal, 68.8% bei $2.74; Astra hoch, 73.2% bei $3.92 pro Aufgabe. Die unterschiedlichen Aufwandsstufen sind ausdrücklich angegeben.*
Der DeepSWE-Benchmark verwendet Repository-Aufgaben mit langem Zeithorizont und Verhaltensprüfungen. OpenAI nimmt Opus 5.5 in diesen Launch-Chart nicht auf. Ich werde keinen unabhängigen FrontierCode-Score danebenstellen und so tun, als würden beide dasselbe messen.
OpenAI kombiniert eigene Evaluierungen mit öffentlich gemeldeten Ergebnissen von Wettbewerbern. Betrachte dies als veröffentlichte Belege, nicht als unabhängigen direkten Vergleichstest von mir.
Wo Claude Opus 5.5 weiterhin relevant ist
Anthropic positioniert Opus 5.5 für lang laufende Programmier- und Wissensarbeit. Der Launch-Bericht nennt einen FrontierCode-v1.1-Main-Score von 54.6% bei standardmäßig mittlerem Aufwand und beschreibt Verbesserungen bei der Programmierung über mehrere Dateien hinweg. Diese Ergebnisse verwenden einen anderen Benchmark als DeepSWE. Anthropic führt außerdem frühes Feedback von Partnern zu weniger Schritten und Tokens an; dabei handelt es sich weiterhin um zugeschriebenes Feedback und nicht um einen kontrollierten Vergleich mit Sol 6.1. Siehe die Ankündigung von Opus 5.5.
Ich würde Opus bei schwierigen Änderungen, Reviews und visueller Arbeit im Vergleich behalten, wenn ein weiterer Durchlauf das Endergebnis verbessern könnte. Diese Hypothese würde ich testen, statt dem Modell aufgrund der Launch-Woche dauerhaft eine Spezialistenrolle zuzuweisen.
Meine Benchmarks und Reaktionen zu Claude Opus 5.5 behandeln die Veröffentlichung ausführlicher.
Was sagen andere Nutzer?
Die ersten Reaktionen sind gemischt. In einer Launch-Diskussion auf Reddit begrüßten einige Nutzer günstigere Cache-Lesevorgänge; andere stellten infrage, wie nah sich das Modell an Astra anfühlen würde, und bevorzugten Claude. Das sind individuelle Reaktionen, keine repräsentative Umfrage.
Ein weiterer konkreter Test mit drei Modellen von digitalml verwendete denselben Prompt für eine filmische Three.js-Szene bei mittlerem Aufwand. Die gemeldeten Zeiten betrugen 8 Minuten und 42 Sekunden für Sol 6.1, 9 Minuten und 37 Sekunden für Astra sowie 38 Minuten und 54 Sekunden für Opus 5.5. Der Autor bevorzugte das filmische Ergebnis von Opus und berichtete über Kamera- und Soundprobleme in Sols Version.
Dieses einzelne Beispiel zeigt eine Abwägung, die es zu untersuchen lohnt: zuerst fertig zu werden kann wichtig sein, aber ebenso die Ausarbeitung und das Verhalten nach dem Laden der Seite. Es begründet kein allgemeines Ranking bei Geschwindigkeit oder Qualität.
Wie ich GPT-6.1 Sol testen werde
Ich werde Sol und Opus dieselbe Aufgabe, dieselben Ausgangsdateien, denselben Tool-Zugriff und dieselben Abnahmekriterien geben. Ich möchte Korrektheit, verstrichene Zeit, Wiederholungsversuche, Tokenkosten und den Prüfaufwand erfassen, der mir noch bleibt. Eine schnelle Antwort, nach der ich Regressionen beheben muss, ist kein günstiges Ergebnis.
Für API-Integrationen benötigt Sol für Tool-Aufrufe die Responses API; Chat Completions unterstützt dies ohne Tools. Es unterstützt die Reasoning-Aufwandsstufen low, medium, high, xhigh und max, wobei medium der Standard ist. Die oben verlinkte Modelldokumentation definiert diese Einschränkungen.
Mein praktischer Ausgangspunkt ist medium, ein klar abgegrenztes Briefing und ausführbare Prüfungen. Ich werde den Aufwand erhöhen, wenn eine Aufgabe dies erfordert, und anschließend das Ergebnis vergleichen. Mehr Reasoning sollte die zusätzliche Zeit und die zusätzlichen Kosten rechtfertigen.
Ich freue mich darauf, GPT-6.1 Sol auszuprobieren, weil das veröffentlichte Preis-Leistungs-Verhältnis für wiederholte Agentenarbeit nützlich aussieht. Opus 5.5 bleibt eine starke Alternative. Ich werde entscheiden, wo jedes Modell hingehört, sobald ich Belege aus den Aufgaben habe, die ich erledigen muss.
---