多模态 Embeddings:生产环境前测试每种模态
受众: 面向文本、图像、视频和视觉文档构建搜索、RAG、推荐或 agent 系统的高级实践者。
多模态 Embeddings 可以将多个检索管道缩减到一个向量空间中,但不会将评估缩减为一个分数。某个模型可能在综合基准测试中领先,却无法捕捉生产系统所需的短视频事件、精确术语、图表标签或页面局部证据。
生产环境规则很简单:分别保留文本、图像、视频和视觉文档的结果;在适用的地方比较 dense、sparse 和 hybrid 检索;测量编码器从未看到的内容;并将每次模型变更视为一次索引迁移。
五天内发布的三篇论文让这一边界格外清晰。UEmbed 在一次前向处理中生成 dense 和 sparse 表示。Douyin 的 DME 训练紧凑向量以保留检索证据。ReLoop-UME 在不生成 rationale token 的情况下增加 recurrent depth。三者都报告了更强的检索效果,但它们的失败模式指向不同的运营风险。
什么是多模态 Embeddings?
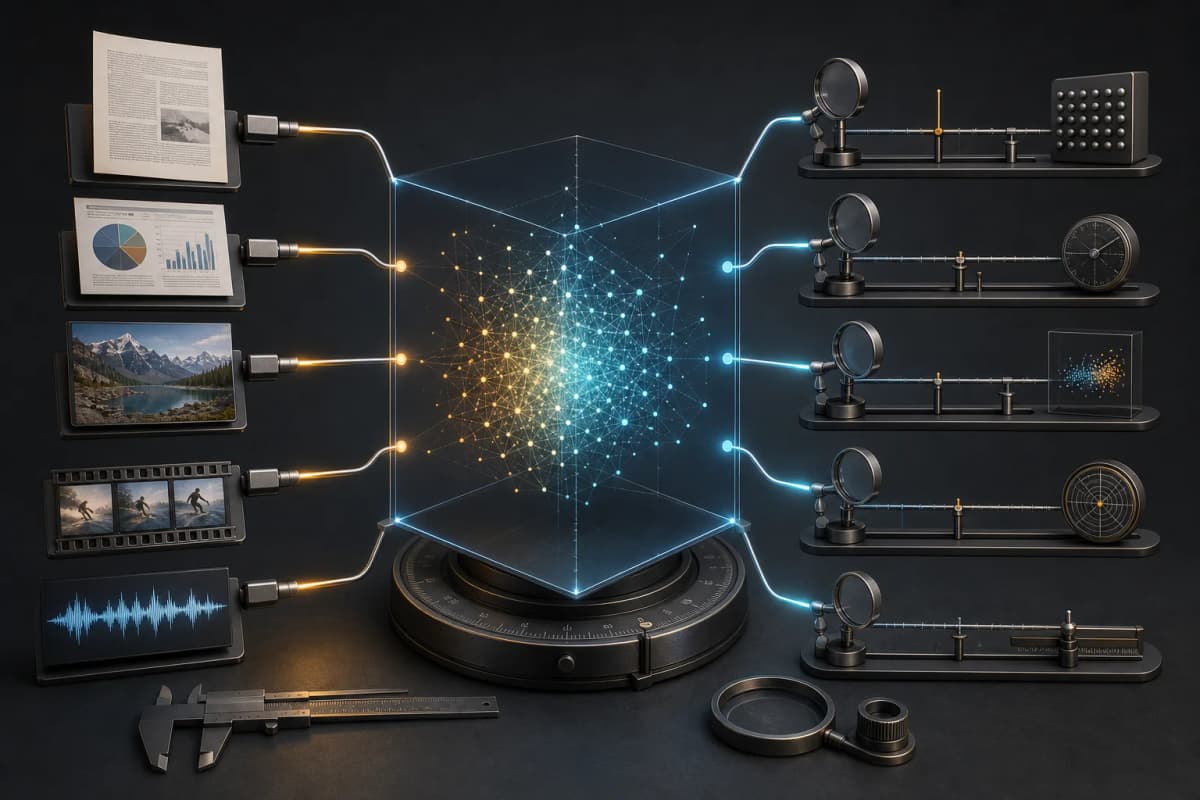
多模态 Embeddings 将不同输入类型映射为可以在共享空间中比较的向量。文本查询可以检索照片,视频可以匹配文本描述,截图也可以检索视觉上相似的文档页面。
这种共享接口很有用,因为检索系统可以使用 approximate nearest-neighbor search,而不必对每个候选运行生成式模型。但它也掩盖了有意义的差异。文本包含精确的词法信号。图像包含局部对象和关系。视频增加了事件时间和帧选择。视觉文档则结合了布局、OCR、表格、图表和页面上下文。
当前系统的自身限制体现了这些差异。Google 的 Gemini Embedding 2 文档 将文本、图像、视频、音频和 PDF 映射到同一空间,但每个视频最多处理 32 帧,并且不会处理视频的音轨。每次请求的 PDF 最多限制为六页。Qwen3-VL-Embedding-2B model card 支持文本、图像、截图、视频和混合输入,具有 32K 上下文,并支持从 64 到 2,048 的可配置维度。
这些能力是评估计划的输入,而不是证明每种模态都能在特定语料库上同样良好运行的证据。
三篇新论文实际测量了什么
这些论文优化的是同一个检索约束的不同部分:在不让每个查询都变成缓慢的生成任务的情况下,保留足够的证据以进行区分。
| 系统 | 机制 | 报告结果 | 重要边界 |
|---|---|---|---|
| --- | --- | --- | --- |
| UEmbed | 一次 causal pass 生成 dense 和 learned sparse 向量 | UEmbed-9B 在 MMEB-V2 上报告 dense 71.8、sparse 71.0 | sparse 的跨语言质量较弱;视频的 dense-sparse 差距更大 |
| DME | 对比预训练,加上仅训练阶段的 latent reasoning 和 reconstruction | DME-2B 在 MMEB-V2 上报告 74.8,DME-9B 报告 78.4 | 内部生产数据、评估集和 0.1% Lifetime 指标并未公开 |
| ReLoop-UME | 通过 retrieval registers 复用共享的 middle-to-late block | ReLoop-UME 在其 H20 配置中报告比 UME-R1 低 44.9× 的延迟 | 增加训练成本,且无法恢复帧采样时遗漏的视频证据 |
这些数字来自作者的实验。它们不是来自共同的生产环境,不应被当作硬件、数据、模型规模和 serving stack 都受控的结果进行比较。
UEmbed:一次前向处理中的 dense 和 sparse 检索
UEmbed 向 decoder-only 多模态模型追加 16 个可学习的 special token。每个 token 预测一个独立词表分区上的 sparse 权重;最终的 end-of-sequence 状态提供 dense 向量。作者发布了使用公开数据训练的 2B、4B 和 9B 版本。
UEmbed-9B 在 MMEB-V2 上报告 dense 检索得分 71.8、sparse 检索得分 71.0。与 dense 检索相比,hybrid 结果在文本上提升 0.3 分,在视觉文档上提升 0.5 分,而图像和视频几乎没有变化。这一结果支持一个有限的推断:在精确术语或文档文本重要的场景中,learned sparse 信号可以补充 dense 检索。但它并未表明 hybrid search 能改善每种模态。
这些限制具有实际意义。训练数据偏向英语和中文,论文报告了较弱的跨语言 sparse 泛化能力。其 sparse 表示也保留了词表伪影。视频在 dense 和 sparse 性能之间表现出更大的差距,而论文没有提供完整的 inverted-index 效率研究。
在 2026 年 8 月 4 日检查时,UEmbed repository 仅创建了几天。它有两次提交、六颗 star、没有 fork,也没有 release。这些数字描述的是成熟度,而不是模型质量。实现仍处于早期阶段,因此生产团队应预期接口和 serving 会发生变化。
DME:训练向量以保留检索证据
Douyin Multimodal Embedding technical report 将学习分为两个阶段。大规模对比预训练首先创建广泛的共享空间。仅在训练阶段使用的 latent reasoning 和 cross-conditional reconstruction,随后促使紧凑 embedding 保留关于其对应对象的细粒度证据。
对于 2B 模型,报告的 MMEB-V2 分数从 70.9 的 baseline,在第一阶段预训练后升至 72.5,在 evidence-grounded latent reasoning 后升至 73.8,并在 reconstruction 后升至 74.8。9B 模型报告 78.4。论文还报告了内部离线集上 2.92% 的相对提升,以及在线 A/B 测试中内部 Lifetime 指标 0.1% 的提升。
作者在 Douyin 内部测量了这些生产结果。论文推断,保留证据的训练可以在不产生生成式 serving 开销的情况下改善工业检索。读者无法仅凭该报告独立复现内部数据集、指标定义、流量构成或部署条件。因此,实际解读应有所限制:reconstruction 可以是有用的训练目标,但在线数字并不是可迁移的预测。
ReLoop-UME:沿深度增加计算
ReLoop-UME 探讨了模型是否可以在不生成中间 token 的情况下,执行更多面向检索的计算。它识别出正负样本发生分离的 middle-to-late 区域,将参数共享的 block 重复使用四次,并通过五个可学习的 retrieval register 传递证据。
在 MMEB-V2 上,论文对比中 2B 模型报告总体得分 63.2,而 VLM2Vec-V2 为 58.0,UME-R1 为 60.1。7B 模型报告 65.9。在单个 H20 GPU 上,作者测得每个样本 201 毫秒:比 UME-R1 快 44.9×,比 PLUME 快 1.5×,但比非 recurrent 的 VLM2Vec-V2 baseline 慢 1.3×。
综合提升掩盖了一个警告。ReLoop-UME-2B 在论文的视频切片上得分 40.5,低于 PLUME 的 44.1;7B 结果在视频上也落后于 UME-R1。该方法采样八帧。其自身限制指出,recurrent 无法恢复采样遗漏的证据,并且 temporal-boundary smoothing 可能错过短事件。
为什么一个基准平均分还不够
MMEB-V2 与 VLM2Vec-V2 一同推出,覆盖 78 个数据集:36 个图像数据集、18 个视频数据集和 24 个视觉文档数据集。这种广度使其适合模型开发。但这些任务的平均值仍然使用了可能与生产工作负载几乎没有关系的权重。
设想三个获得相同综合分数的系统:
第一个系统需要词法精度和截图理解。第二个系统成败取决于时间覆盖。第三个系统需要页面局部 OCR、布局和修饰语准确性。将它们的失败取平均会得到一个整洁的数字,却会导致糟糕的决策。
同一原则也适用于通用模型基准测试。可复现的任务集应代表系统将要执行的工作,正如 How to Benchmark AI Models for Real Work→ 所述。对于检索而言,该任务集必须保留每个查询的模态和失败类型。
可复现的多模态 embedding 评估
从冻结的语料库快照和包含已知相关证据的查询集开始。将原始源对象、embedding 输入和相关性判断放在一起保存。否则,编码器失败和摄取失败将无法区分。
1. 在选择指标前建立模态切片
为文本、图像、视频和视觉文档创建独立切片。然后根据重要行为进一步拆分:
为每个示例添加 coverage 字段。记录源证据是否到达编码器。遗漏的帧、被裁剪的图表图例或未包含的 PDF 页面,不应被计为 embedding 错误。
2. 比较完整的检索管道
至少使用相同的相关性判断测试以下候选方案:
hybrid baseline 很重要,因为 UEmbed 的结果显示,提升主要集中在文本和视觉文档,而不是每种模态。text baseline 也很重要,因为 captions、OCR 和结构化 metadata 可能比原生多模态向量更便宜、更容易调试,并且在精确术语方面表现更好。
如果系统已经有 RAG test harness,请复用其查询、相关性和回归结构。RAG evaluation workflow→ 将检索遗漏与答案生成失败区分开来。
3. 同时测量质量、覆盖率和成本
按切片报告指标,并报告分布,而不只是一个平均值。
| 维度 | 最低测量要求 |
|---|---|
| --- | --- |
| 检索质量 | 每个切片的 Recall@k、nDCG@k 和 evidence hit rate |
| 细粒度准确性 | 精确标识符、修饰语、表格单元格、图表标签和事件边界检查 |
| 输入覆盖率 | 提供给编码器的帧、页面、区域、音频和 metadata |
| 运行时 | 查询延迟 p50 和 p95、编码吞吐量、reranker 延迟 |
| 存储 | 向量维度、sparse postings、每个对象的索引字节数 |
| 迁移 | 完整重新 embedding 时间、写放大、双索引持续时间 |
| 可靠性 | 空输出、超时、格式错误的媒体和模型版本失败率 |
有效的总结应保留最差的重要切片。例如,只有在加权综合指标提升并且没有受保护切片超过回归预算时,才晋级候选方案。
text promote = aggregate_gain > 0 and text_regression <= budget.text and image_regression <= budget.image and video_regression <= budget.video and visual_doc_regression <= budget.visual_doc and p95_latency <= budget.latency
这些预算属于产品决策。上述结构可以防止在视频搜索产品中,图像占比较高的基准测试抵消视频失败。
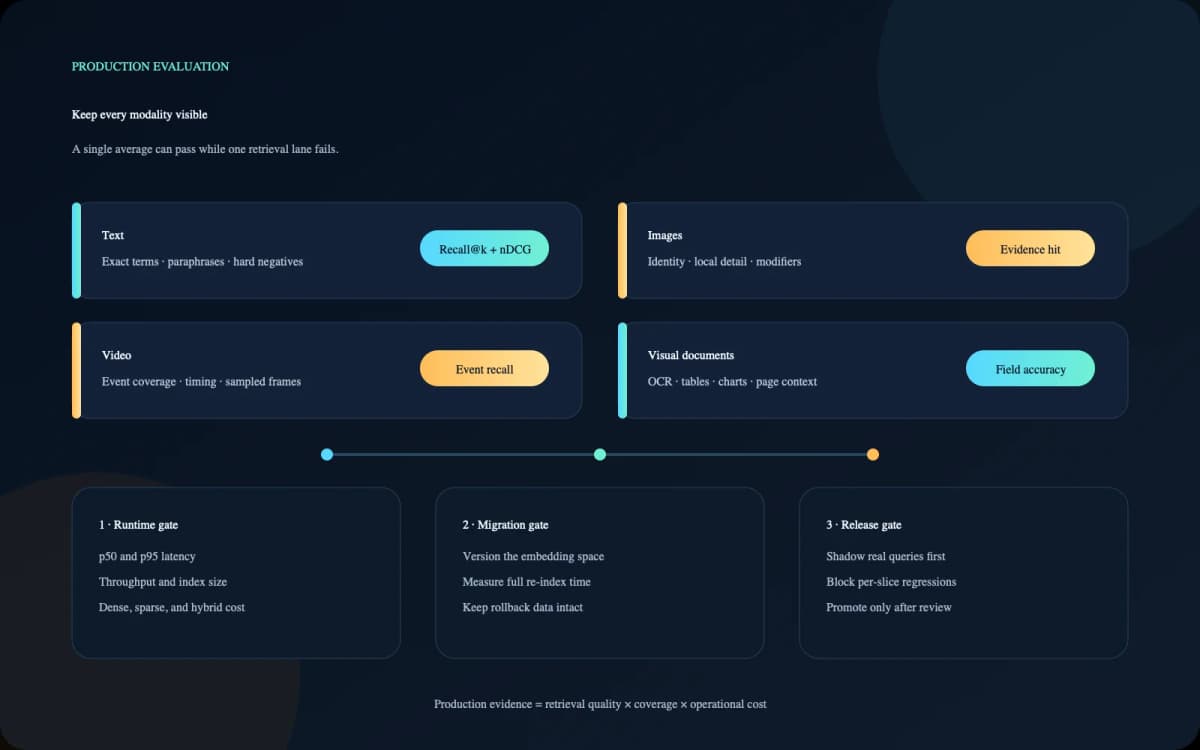
*先评估每条检索通道,再应用统一的运行时、迁移和发布门槛。*
4. 对 embedding 空间进行版本管理
embedding 模型版本是存储数据格式的一部分。Google 的迁移指南指出,gemini-embedding-001 和 gemini-embedding-2 生成不兼容的空间,因此升级需要对所有现有数据重新 embedding。来自一个空间的查询向量不能直接与另一个空间的文档向量进行比较。
使用类似 corpus-model-dimension-preprocess-date 的不可变索引版本。在旧索引旁构建新索引,重放固定查询集,对真实流量进行 shadow,并在质量和延迟稳定前保留回滚能力。在 AI bill of materials→ 中记录编码器、维度、prompt 或 task instruction、帧采样器、PDF renderer、OCR 版本和分数融合逻辑。
5. 切换前对生产查询进行 shadow
离线评估控制已知案例。Shadow traffic 在不改变用户可见结果的情况下测试实际分布。记录两个候选列表、延迟、空结果,以及每次分歧对应的切片或输入类型。在部分发布前审查这些分歧。
不要仅将点击作为相关性真值。位置偏差和当前 ranker 会影响用户能够点击的内容。应结合抽样人工判断、下游任务成功率和行为信号。
生产环境决策框架
当原始视觉或时间证据会改变相关性,而文本表示会丢失这些证据时,应使用多模态 embedding 模型。当语料库主要由 prose 构成、精确标识符占主导,或可靠的 captions 和 OCR 已经捕捉到有用信号时,应保留更简单的文本或 hybrid pipeline。
| 工作负载 | 优先尝试的候选方案 | 原因 |
|---|---|---|
| --- | --- | --- |
| 包含名称、SKU 和图像的商品搜索 | Dense multimodal + lexical fusion | 视觉相似性和精确术语都很重要 |
| 截图或视觉文档 RAG | Multimodal dense + OCR/BM25 + reranker | 布局和局部文本需要独立信号 |
| 长视频搜索 | 具有明确帧和音频覆盖的 segment-level index | 为完整视频使用一个向量会掩盖短事件 |
| 主要是文本文档、偶尔包含图像 | 先使用 text dense + BM25 baseline | 索引和迁移复杂度更低 |
| 跨模态 agent memory | 具有严格 provenance 的版本化多模态索引 | 检索需要明确来源、时间和模态边界 |
在测试 preprocessing 之前,不要先选择更大的模型。帧选择、页面分割、OCR、查询指令和负例可能主导结果。开源活动可以揭示实现摩擦,但不是质量基准。截至 2026 年 8 月 4 日,Qwen3-VL-Embedding repository 有 32 次提交和 55 个 open issue;近期 issue 包括 serving endpoint 和 representation mismatch。这些是需要调查的工程信号,而不是接受或拒绝该模型的理由。
证据支持的结论
这些论文支持三个具体结论。
第一,紧凑的多模态向量可以比单次未经修改的 forward pass 保留更多面向检索的计算。DME 增加了仅训练阶段的目标;ReLoop-UME 增加了 recurrent depth;UEmbed 同时生成 dense 和 sparse 视图。
第二,表示机制会改变失败模式。Sparse retrieval 带来词法和跨语言风险。Recurrent depth 带来训练和延迟成本。视频在 embedding 模型运行之前,仍然容易受到采样影响。
第三,生产证据必须是本地化的。作者测量了有价值的基准和系统结果,但没有任何论文测量你的语料库、查询构成、延迟预算、索引迁移或错误检索的成本。
有用的结论是运营层面的:只有在每种模态都通过自身的检索和覆盖率测试后,才采用多模态 embeddings。共享向量空间可以简化 serving,但评估应有意保持不均衡。
FAQ
文本和图像 embedding 应使用同一个索引吗?
当模型经过训练,能够将这些模态放入兼容的统一空间,并且跨模态检索属于任务的一部分时,它们可以共享索引。当 lexical retrieval、模态专属过滤、不同更新频率或独立回滚很重要时,应保留独立字段或索引。应在真实相关性判断上测试分数融合,而不是假设某种布局一定更好。
更换模型时需要重新 embedding 数据吗?
通常需要。不同模型或不兼容版本的 embedding 空间不能安全地进行比较。构建版本化的替代索引,对语料库重新 embedding,同时对两个索引进行 shadow query,并在新索引通过每个切片的质量和延迟门槛前保留旧索引。
Claim checks
| Claim | Status | Evidence boundary |
|---|---|---|
| --- | --- | --- |
| UEmbed-9B 在 MMEB-V2 上报告 dense 71.8、sparse 71.0。 | 已验证 | UEmbed 论文,第 1 版,2026 年 8 月 3 日。 |
| UEmbed 的 hybrid 提升集中在文本和视觉文档。 | 已验证 | 论文报告文本提升 +0.3、视觉文档提升 +0.5,其他模态变化很小。 |
| DME-2B 报告其各训练阶段的分数从 70.9 累计提升至 74.8。 | 已验证 | DME 消融表;该结果属于作者的实验设置。 |
| DME 的 0.1% 在线提升可以预测另一种部署的影响。 | 已否定 | 内部指标、流量、数据和部署条件未公开。 |
| ReLoop-UME 比 UME-R1 快 44.9×。 | 有限定条件 | 在论文的单个 H20 配置中测量;不是普遍适用的 serving 比率。 |
| Recurrent depth 可以恢复帧采样遗漏的视频事件。 | 已否定 | 论文指出无法恢复未见过的证据。 |
| 一个 MMEB-V2 平均分足以做出生产决策。 | 已否定 | 该基准覆盖 78 个数据集和不同模态;生产权重与失败成本各不相同。 |
| Gemini Embedding 2 会处理视频的每一帧及其音轨。 | 已否定 | 官方文档将处理上限设为 32 帧,并排除视频音频。 |
| 从 Gemini Embedding 001 升级到 2 需要对现有数据重新 embedding。 | 已验证 | Google 将这些空间记录为不兼容。 |
| Repository star 数或 open issue 可以证明检索质量。 | 已否定 | 它们是采用率和维护信号,而不是受控的质量测量。 |