GPT-6.1 Sol 引起了我的注意,因为我希望在不把每项任务都当作高级模型开销的情况下,运行更多有用的代理工作。真正值得关注的问题是:在预算范围内,我能获得多少正确且可复核的工作成果。
我的初步看法是:Sol 值得进入日常主力模型的讨论。Claude Opus 5.5 仍然值得认真比较,尤其是在质量比首次响应速度更重要的时候。我会在真实工作中测试两者。目前,我将已发布的基准测试、早期用户报告和我自己的预期分开来看。
*来源核查:2026 年 9 月 29 日。主视觉是一幅 AI 生成的编辑插图。数据图表由我根据引用的已发布数值绘制;它们不是我自己测试的截图。*
GPT-6.1 Sol 适合做什么?
OpenAI 将 GPT-6.1 Sol 定位于复杂编码、计算机使用和专业工作,目标是以更低价格接近 Astra 的表现。其 API 模型 ID 为 gpt-6.1-sol,上下文窗口为 1,050,000 个 token,最多可输出 128,000 个 token。请参阅官方 GPT-6.1 Sol 模型文档。
对我的工作而言,这意味着可以从以下三个方向开始:
这些是评估候选方向,并不意味着模型能够在无人监管的情况下处理它们。我仍然会让生产环境中的写入操作经过审批,并要求代理展示其证据。
这延续了我在 GPT-6 Astra 评测中提出的同一个实际问题:当模型接入现有系统后,它是否能帮助完成工作?
GPT-6.1 Sol 与 Claude Opus 5.5 的价格比较
标准 API 比较很直接。以下是每百万 token 的美元价格,不包括工具、缓存写入、速度溢价或区域调整因素。
| Token 类型 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| 输入 | $2.00 | $4.00 |
| 缓存输入 | $0.10 | $0.20 |
| 输出 | $10.00 | $20.00 |
来源:OpenAI API 定价和 Claude Platform 定价。
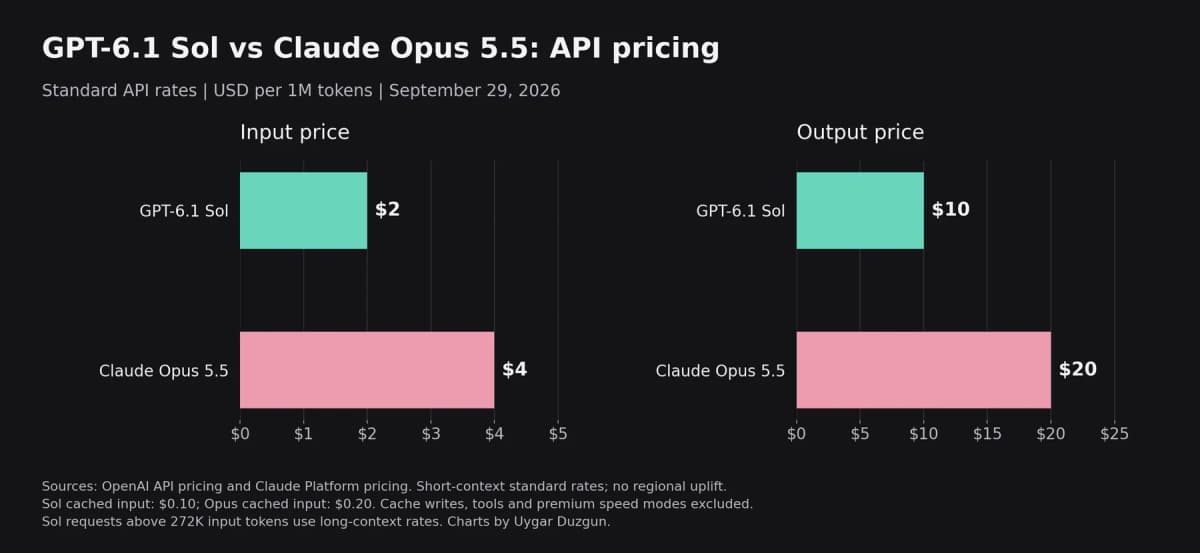
*标准短上下文价格。表格包含缓存读取价格;图表展示普通输入和输出价格。*
在这些类别中,Sol 的每 token 成本是 Opus 的一半。但这并不意味着每个完成的任务成本也只有一半。不同模型可能使用不同数量的推理 token、调用不同的工具,并需要不同次数的重试。
长上下文也会改变比较结果。当单个请求中的输入 token 超过 272,000 时,Sol 会对超出部分采用更高价格:输入和缓存输入价格翻倍,输出价格提高至 1.5 倍。Anthropic 列出的标准价格适用于 Opus 5.5 的完整上下文窗口。长时间运行的会话累计 token 数,并不等同于单个请求跨过这一阈值。
如需了解更早的版本,我的 GPT-6 Sol 与 Luna 概览介绍了此前的产品阵容。
GPT-6.1 Sol 基准测试:同时看分数和成本
AutomationBench:Sol 更便宜;Opus 在最高设置下达到更高分数
AutomationBench 1.0.6 测试跨越 47 个工具的端到端业务工作流。Zapier 使用确定性检查对最终状态评分,而不是让另一个语言模型来判断答案。
| 配置 | 分数 | 每次尝试任务的美元成本 |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1,中等 | 31.7% | $0.19 |
| Opus 5.5,中等,默认回退 | 29.5% | $0.65 |
| Sol 6.1,最高 | 36.1% | $0.30 |
| Opus 5.5,最高,默认回退 | 42.5% | $1.44 |
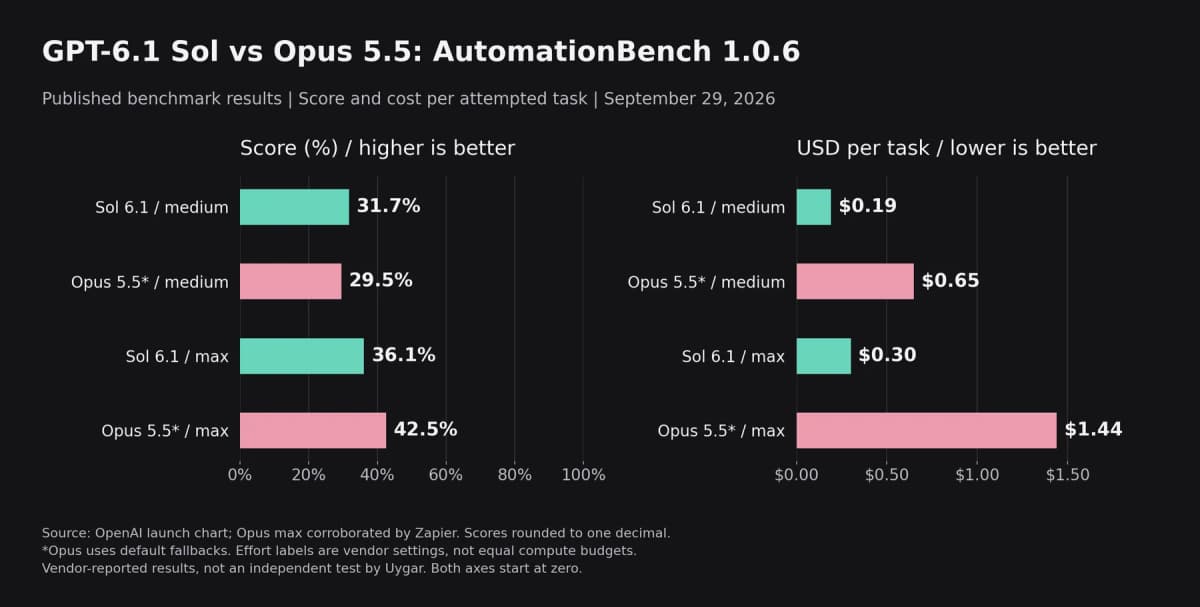
*数据来自 OpenAI 的发布图表,分数四舍五入至小数点后一位。Zapier 对 Opus 最高设置的结果进行了佐证。Opus 配置包含默认回退;厂商的工作强度标签并不代表相同的计算预算。*
在中等设置下,Sol 取得了小幅分数领先,报告的任务成本也更低。在最高设置下,Opus 的分数更高。我会根据工作流失败的代价来选择其中的权衡,包括人工检查所需的时间。
这些成本涵盖尝试执行的任务,包括失败任务。它们并不是保证业务结果成功的价格。
DeepSWE:相比上一代 Sol 的有用升级
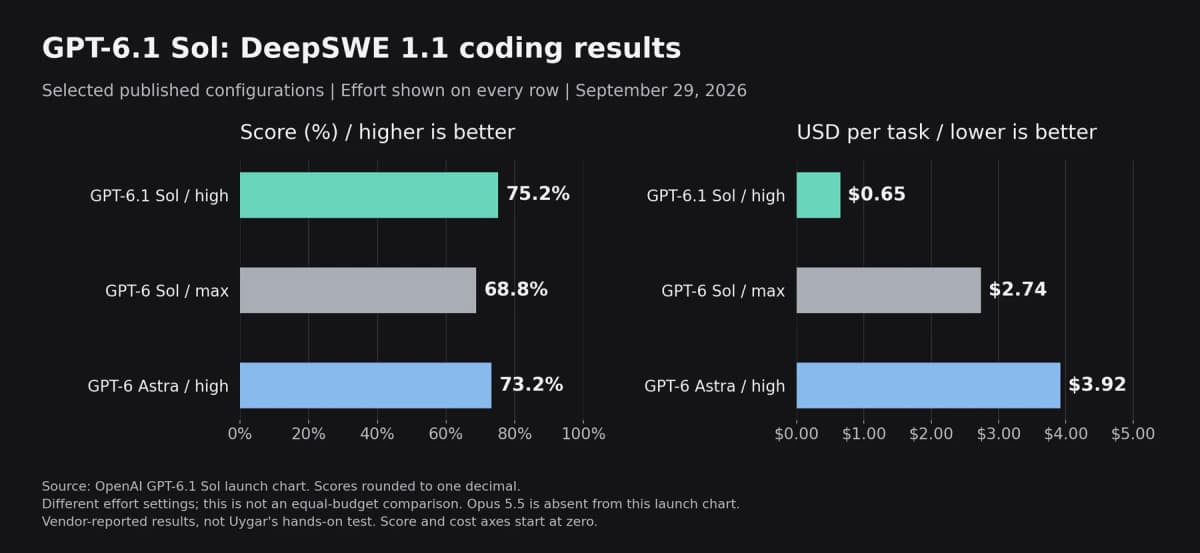
*来自同一组 OpenAI 发布图表的 DeepSWE 1.1 部分数据:Sol 6.1 高设置,75.2%,每个任务 $0.65;上一代 Sol 最高设置,68.8%,每个任务 $2.74;Astra 高设置,73.2%,每个任务 $3.92。不同的工作强度设置已明确标注。*
DeepSWE 基准测试使用长周期代码仓库任务和行为验证器。OpenAI 没有在这张发布图表中纳入 Opus 5.5。我不会把一个无关的 FrontierCode 分数放在旁边,然后假装它们衡量的是同一件事。
OpenAI 将自己的评估结果与公开报告的竞争对手结果结合在一起。应将其视为已发布的证据,而不是我亲自进行的独立正面对比测试。
Claude Opus 5.5 仍然重要的地方
Anthropic 将 Opus 5.5 定位于长时间运行的编码和知识工作。其发布报告给出了默认中等工作强度下 FrontierCode v1.1 Main 的 54.6% 分数,并描述了多文件编码方面的提升。这些结果使用的基准测试与 DeepSWE 不同。Anthropic 还收录了早期合作伙伴关于步骤和 token 数量减少的反馈,但这仍然是有来源归属的反馈,并非与 Sol 6.1 进行的受控比较。请参阅 Opus 5.5 公告。
对于困难的修改、审查和视觉工作,我仍会把 Opus 纳入比较,因为额外的一轮处理可能会改善最终结果。我会验证这一假设,而不是仅凭发布周的表现就给模型安排一个永久的专门角色。
我的 Claude Opus 5.5 基准测试与反应对其发布情况进行了更详细的介绍。
其他用户怎么说?
早期反馈褒贬不一。在 Reddit 上的一则发布讨论中,一些用户欢迎更便宜的缓存读取;另一些人则质疑该模型的体验会有多接近 Astra,并更偏好 Claude。这些是个人反应,并不代表具有代表性的调查结果。
另一个更具体的由 digitalml 进行的三模型测试使用了相同的电影感 Three.js 场景提示词,并采用中等工作强度。报告的用时分别为:Sol 6.1 用时 8 分 42 秒,Astra 用时 9 分 37 秒,Opus 5.5 用时 38 分 54 秒。作者更喜欢 Opus 的电影感结果,并报告称 Sol 的版本存在摄像机和声音问题。
这个单一案例体现了一个值得研究的权衡:率先完成可能很重要,但页面加载后的精致程度和行为同样重要。它并不能确立普遍的速度或质量排名。
我将如何测试 GPT-6.1 Sol
我会给 Sol 和 Opus 相同的任务、起始文件、工具访问权限和验收检查。我希望记录正确性、耗时、重试次数、token 成本,以及我仍然需要完成的审查工作。一个留下回归问题让我修复的快速答案,并不是真正便宜的结果。
对于 API 集成,Sol 需要使用 Responses API 进行工具调用;Chat Completions 在不使用工具时支持它。它支持 low、medium、high、xhigh 和 max 推理工作强度,默认值为 medium。上面的模型文档定义了这些限制。
我的实际起点是 medium、范围明确的任务说明和可运行的检查。我会在任务需要时提高工作强度,然后比较结果。更多推理应该配得上它额外消耗的时间和成本。
我很期待尝试 GPT-6.1 Sol,因为已发布的性价比数据看起来很适合重复性的代理工作。Opus 5.5 仍然是一个强大的替代方案。在获得需要完成的任务证据后,我会决定两者分别适合放在哪些位置。
---