我持续运行的 Codex 目标:四天过去了,仍在工作
2026 年 10 月 9 日,我持续运行的 Codex 目标显示为 4 天 14 小时 8 分 22 秒。当时 Codex 仍在开发一个我尚未发布的 SEO 产品,我截下了这张截图。目标仍处于开启状态,还有更多任务需要完成。
我曾要求它完成我正在构建的这个尚未发布的 SEO 产品的完整计划。到那时,我还要求它使用更多代理、降低推理强度、暂停以便更新、重启后继续工作,并减少重复测试所花的时间。
这是我对一个长期运行的 Codex 目标的记录:它产出了什么、哪些工作拖慢了进度,以及我仍然需要做出哪些决定。这是一个尚未完成的构建过程,不是基准测试,也不是发布公告。
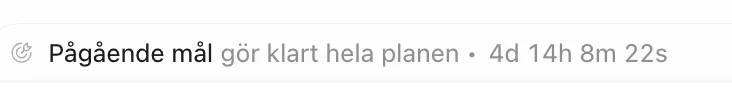
上面的计时器属于这个目标。它不能证明模型连续计算了四天。我的会话包含明确的暂停和恢复、应用更新、电脑重启、工具执行以及等待时间。
我要求 Codex 构建什么
这次对话始于 10 月 3 日的一个较小问题:用户是否拥有自己的登录凭据,能否使用 Google 登录,以及能否生成个人 MCP 密钥?
随后我扩大了需求。每位用户都应该看到自己的项目。用户应该能够邀请他人加入工作区。我希望设置中包含个人偏好和爬虫并发数。这个平台最终会商业化,但初始版本将免费推出。
我提供了一个规模大得多的 SEO 产品目录来指导构建。最终形成的计划涵盖 15 个产品领域、42 个应用参考和 19 个公开免费工具,此外还包括网站流量排名功能。其中包括技术 SEO、关键词研究、排名、反向链接、AI 可见性、内容、分析、本地 SEO 以及后续的企业功能。
我还希望该产品能够从我自己网站背后的内容引擎订购文章。
因此,完成整个计划这一指令指向的是一份规模可观的产品路线图。这个范围是我参与制定的。在一个小型 bug 修复上运行四天,会是完全不同的故事。
我使用的模型和设置
主会话日志将模型标识为 GPT-6.1 Sol,其标识符为 gpt-6.1-sol。记录中的各轮使用了 ultra、medium,以及少量 high 推理设置。这只能确定主会话;无法证明每个审查者或外部工具背后的模型。
10 月 5 日,我明确将工作强度切换为 medium,以节省 token。随后我也出于同样原因关闭了 turbo。这些是我的意图,而不是经过测量的节省:我没有针对这两种配置进行经过审计的成本比较。
我还要求增加并行代理。该会话使用了委派工作,并让 Claude 对部分实现进行同行审查。这让独立任务能够向前推进,但也增加了协调其输出并验证合并结果的工作。
我之前的 GPT-6.1 Sol 对比→介绍了已发布的模型数据。这次构建提供的是另一种证据:一个范围和设置不断变化的真实项目,而不是模型之间受控的比较。
Codex 目标可以持续工作多久?
在这次经历中,界面针对同一个持续进行的目标显示了超过四天。这是我能够支持的观察结果。它不是最长运行时间保证,我也无法从截图计算出实际的主动推理时间。
OpenAI 将 Codex 中的 Goals 描述为能够跨轮次持续存在的目标。Codex 可以继续朝着某个结果推进,而用户可以暂停或恢复它。完成情况、中断、预算和阻塞因素都会影响工作是否继续。
我的经历符合这种持久化工作流。暂停后,我可以回到同一个目标,并引导下一步工作。让目标保持可用很有帮助。但这并不会让目标变小,也不能确保每个新轮次都会让产品更接近发布。
到 10 月 9 日,它交付了什么?
10 月 9 日的交付日志记录显示,在一份包含 69 个跟踪项目的清单中,有 30 项部分完成、39 项尚未评估,以及 0 项完全验收。
这个数字需要结合背景理解。该清单衡量的是宽泛的产品验收情况。0 项完全验收并不意味着没有可运行的代码。30 项部分完成也不意味着产品完成了 43%。
日志记录了一次针对受支持账户基线的临时本地冒烟测试:创建第一个账户、使用密码登录、读取会话及其私有所有者工作区,然后退出登录并拒绝旧会话。这是一个有明确测试结果的具体用户流程。但它不能证明最新的完整应用已经准备好服务客户。
其他进展包括本地密码重置源代码集成、反向链接审查草稿、已保存的 Search Console 报告工作、客户 token 的 GA4 报告传输,以及文章到 LinkedIn 的草稿工作。其中几项仍然禁用了激活功能、集成不完整或推迟了验证。
带日期的检查点明确报告称,没有进行 commit、push 或部署。Google 登录和完整的客户就绪状态仍未验证。我拥有的是一个不断扩大的本地实现,以及一些有用的证据,而不是一个已经发布的平台。
什么拖慢了我长期运行的 Codex 目标?
我把目标扩展成了产品路线图
添加 Google 登录听起来像一个功能。添加私有客户会改变谁可以访问项目、报告、后台任务和集成。我希望这一边界能够贯穿整个应用。
随后我又加入了关键词研究、反向链接、内容生成以及规模大得多的产品目录。部分耗时反映了针对广泛目标所必需的工作。最初的目标让它很容易不断打开下一个尚未完成的领域。
验证过程变得过于重复
我要求基于源代码做出决策、进行小范围修改、开展审查并提供明确证据。这些指令有助于避免含糊地声称某件事已经完成。
但会话积累了重复的源代码检查、审查准备工作和测试夹具工作。我的判断是,平衡已经过度偏向于在继续下一个可用流程之前证明各个独立部分。
10 月 9 日,我告诉它不要再花那么多时间测试,转而推进完成,并把更大规模的测试留到之后。这并没有取消验证账户隔离的必要性,而是改变了顺序:实现过程中进行有针对性的检查,随后再对组装完成的流程进行更广泛的验证。
一些失败源于测试设置
一次密码重置数据库尝试失败,是因为合成账户记录遗漏了必需的显示名称字段。修复这个夹具是运行测试所必需的,但它并不是一个新的产品功能。
后来一次长期运行的数据库尝试因工作站重启而结束。交付日志没有声称这次尝试通过了。后续诊断发现,它反复计算之前的验证契约,并且进度输出被缓冲,这使得运行中的进程更难评估。
这些细节很重要,因为等待本身含义不明确。一个实时进程可能正在工作,也可能正在重新计算同一个前置条件,或者正在生成我暂时还看不到的输出。仅凭计时器无法告诉我是哪一种情况。
更多代理增加了协调工作
并行工作有助于处理可以分开的任务。主会话仍然需要检查结果、解决依赖关系,并将修改整合到一个应用中。我无法将速度提升归因于增加代理,因为我没有在不使用代理的情况下运行同一个项目进行对照。
实际问题变成了:另一个代理能否完成一个独立部分,还是会为主会话增加一次新的交接工作。
我作为人类仍然要做什么
我选择产品方向,并决定接下来哪些功能最重要。我会检查报告中的进展究竟描述的是可运行的行为、本地源代码,还是未经验证的提案。当我需要更新 Codex 或重启电脑时,我会暂停工作,然后要求它从保存的状态继续。
我也会质疑进度。在这次构建过程中,我:
计划和交付日志让我能够检查聊天消息之外的内容。但它们也需要纪律:带日期的检查点只有在说明发生了什么变化以及哪些内容仍未得到证明时才有用。
这次经历延续了我在 我原以为 AI 会给我更多空闲时间→ 中描述的权衡。我可以尝试构建更大的产品,但仍然需要花时间决定什么值得构建,并检查结果。
到目前为止的优点和缺点
根据我对这次构建的体验,最大的优点是连续性。我可以让一个规模可观的目标保持开启,并在中断后恢复。Codex 产出了本地实现、调查了失败原因,并维护了详细记录,帮助我审查工作。
它还可以在同一个项目中处理多种工作:数据库修改、API 行为、前端流程、集成传输和文档。这让由我来指导一个广泛的构建成为可能。
缺点是,活动可能看起来像进展。许多成功的检查可以与一个尚未完成的产品并存。更高的推理强度和更多代理会带来预算与协调方面的选择,但并不能保证更快交付。
长期运行也会让范围控制变得更困难。一份部分完成的路线图会为代理提供许多合理的下一步行动。我需要决定哪一步能够交付下一个有用的结果。
我还会再次使用持久化目标,但会为每个实现阶段设定更小的验收目标。例如:创建账户、登录、查看其私有工作区,并拒绝第二个账户的访问。将更大的路线图作为背景,先完成这个流程,然后再继续下一步。
我接下来会衡量什么
截至 10 月 9 日,这个 SEO 产品仍在开发中,尚未发布。下一项有用的衡量标准,是针对当前组装完成的应用运行一个完整用户流程,并明确列出剩余阻塞因素。
之后,我希望获得关于 Google 登录、绑定客户的集成、个人 MCP 密钥以及安全发布的证据。Codex 仍在继续处理任务;本文记录的是 10 月 9 日的快照。我会根据这些结果,而不是目标保持开启的时间,来判断这次构建。
来源和这份记录的局限
计时器来自上面的截图。模型标识符、设置变化以及我的干预来自主会话历史。范围和进度统计来自项目计划及其带日期的交付日志。这些项目记录是私人的工作文档;我没有公开日志或客户数据。
OpenAI 的 在 Codex 中使用 Goals 解释了持久化目标工作流。它支持对 Goals 的描述,但不能证明我的项目交付声明。
69 项的统计是一个宽泛的验收快照,不是剩余小时数的衡量标准。截图不能证明连续推理,设置变化不能证明成本节省,本地检查也不能证明已具备生产环境就绪状态。这次构建仍在进行中。
*本文在 AI 的协助下,根据我的截图、会话历史和项目交付记录起草。它描述的是一次正在进行的构建,不能证明 Codex 的通用运行时间限制、模型排名、经过审计的成本或生产环境就绪状态。*