即使模型做出了错误决策,AI agent 权限也应当能够遏制错误。生产环境中的设计很直接:为每次运行分配一组狭窄的能力,在模型之外执行权限控制,仅对具有重大影响的操作保留人工审批,并记录足够的证据来验证实际发生了什么。
受众: 构建工具调用 agent、编码 agent 或 MCP server 的高级实践者。
这个答案很重要,因为“删除前先询问”这样的提示只是指导,而不是访问控制边界。模型可能误解它,注入的指令可能与它竞争,工具的行为也可能与其描述不同。授权必须能够经受这三种失败。
AI agent 权限必须控制什么
AI agent 权限系统需要决定:特定调用方在当前条件下,是否可以对特定资源执行特定操作。“该 agent 可以使用 GitHub”过于宽泛。一个有用的决策至少应包括:
权限检查应位于工具或服务边界。模型可以提出操作并解释原因,但不应决定自己的提议是否获得授权。
分离这些角色也能让机密隔离更加可靠。凭证代理可以向模型隐藏 API key,但仍可能暴露该 key 所允许的每一项操作。代理保护机密;以操作为范围的策略保护资源。
最新权限研究测量了什么
2026 年 7 月的一篇预印本 *How Agents Ask for Permission* 回顾了 2024 至 2026 年间发布或公开的 21 个 agent 权限系统和方案。作者还在 5 月下旬和 6 月上旬,对五个商业 agent 进行了隔离环境下的演练。
他们的分类揭示了三方面的工程张力:
这些数量描述的是作者的样本,而不是整个市场。该评审采用滚雪球抽样,包含预印本和商业产品,并且无法检查闭源内部实现。尽管如此,这篇论文仍然有用,因为它将权限界面、策略和执行机制区分开来。精致的审批对话框无法弥补含糊的策略或未执行的决策。
商业工具已经体现了这种部分分离。Claude Code 文档允许、询问和拒绝规则,而其沙箱文档描述了操作系统级的文件系统和网络边界。OpenAI 的 Codex 安全指南同样将沙箱视为技术边界,将审批策略视为可能向用户发起询问的环节。这些是特定于产品的控制措施,并不能证明每种部署都进行了安全配置。
审批疲劳是路由问题
当用户必须做出真正的决策时,审批提示很有用。当每条常规命令看起来都同样紧急时,它们就会失效。
反复出现的低风险提示会训练人们直接点击通过。Anthropic 报告称,其内部沙箱部署使权限提示减少了 84%,但这是一项供应商报告的运营结果,而不是独立基准测试。更持久的结论范围更窄:在强制执行的边界内预先批准工作,可以减少中断,同时不向 agent 授予全局访问权限。
将操作路由到四种结果:
| 结果 | 适用情况 | 示例 |
|---|---|---|
| --- | --- | --- |
| 自动允许 | 操作有范围、可逆且受到限制 | 读取一个代码仓库内的文件 |
| 限制后允许 | 操作是常规操作,但需要硬性边界 | 在禁用网络并设置时间限制的情况下运行测试 |
| 询问人工 | 操作具有重大影响或对外可见 | 发送邮件、发布内容、合并、消费或删除 |
| 拒绝 | 能力超出本次运行的目的 | 读取其他客户的数据或更改 IAM 角色 |
风险应根据操作及其影响范围计算,而不是根据模型的置信度计算。高置信度并不会让不可逆操作变得更安全。
五层权限架构
最小的可信架构包含五个不同层次。将它们合并会使审计更加困难,并产生故障开放路径。
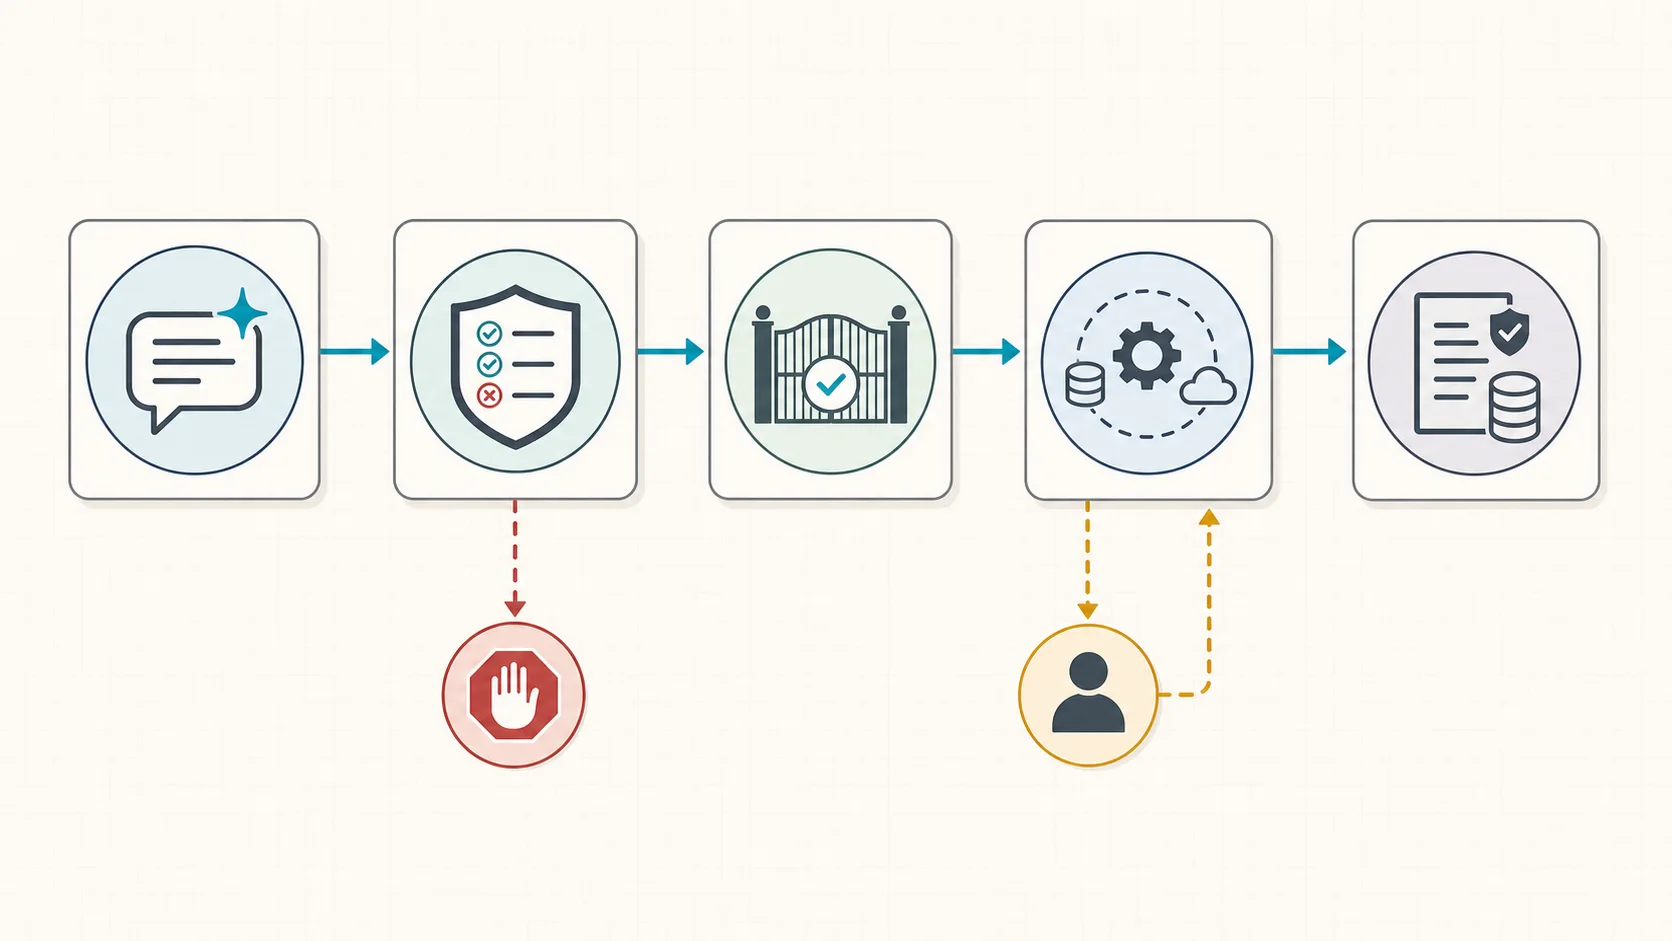
*模型提出操作。策略、执行、运行和证据保持分离。*
1. 规范化提议的操作
在授权之前,将模型生成的工具调用转换为类型化请求:
{ "actor": "agent-run-7f3", "on_behalf_of": "user-42", "action": "blog.publish", "resource": "post:ai-agent-permissions", "constraints": { "environment": "production", "language": "en" } }
这是一个说明性契约,而不是标准。重要的是,授权评估的是一个稳定对象,而不是自由形式的推理。
2. 在模型之外评估策略
返回确定性决策:allow、ask 或 deny。同时包含策略规则和过期时间。模型可以帮助分类新颖请求,但这种分类本身不应授予访问权限。未知操作应默认安全失败。
3. 在执行时强制执行决策
工具处理程序或下游服务必须再次验证该决策。不要依赖 agent 遵守拒绝结果。将能力绑定到确切的操作、资源、调用方和短时间窗口,使其无法针对其他目标重放。
MCP 授权规范将同一原则应用于访问令牌:server 必须验证令牌是否是为预期受众签发的。MCP 的安全指南明确禁止令牌透传,因为这可能破坏该边界。
4. 通过狭窄工具执行
优先使用 publish_draft(post_id),而不是 run_sql(query);优先使用 send_invoice(invoice_id),而不是 http_request(url, body)。狭窄工具使策略更易读,并缩小意外操作的空间。
《MCP Developer Workflows: The Real Control Layer》中也提出了相同的控制层论点:工具形态、审批门和可重放操作决定了 agent 能够安全执行什么。
5. 记录回执并支持撤销
记录请求的操作、策略决策、审批身份、工具输入摘要、结果类别和后置条件。对机密和敏感载荷进行脱敏。用户应能够撤销长期授权,而无需重新构建 agent。
回执必须区分“工具已返回”和“预期状态已存在”。HTTP 200、成功的 SDK 调用或自信的最终消息,都不是后置条件。
将记忆写入视为特权操作
持久化记忆会改变未来的行为,因此记忆写入需要独立的权限和验证路径。
2026 年 7 月的 MemGhost 论文介绍了 WhisperBench,这是一个包含 108 个案例、用于测试通过电子邮件工作流进行隐蔽记忆注入的基准。作者报告称,在一种 OpenClaw 配置中,留出测试的端到端攻击成功率为 87.5%;在一种 Claude Code SDK 配置中为 71.4%。他们还报告了攻击向其他记忆系统的迁移。
这些数字并不能确立普遍的攻陷率。实验覆盖特定模型、agent 架构和以电子邮件为中心的工作流;部分评估使用了 LLM 评审,而且论文没有测试持续数周的记忆衰减。实际含义仍然成立:未经信任的内容不应在没有来源信息、模式验证、租户隔离和明确写入策略的情况下成为持久化 agent 记忆。
一条记忆记录应携带:
权限必须经受工具故障
如果权限设计假设工具描述和响应始终稳定,那么它就是不完整的。
ToolBench-X评估了 agent 在规范漂移、调用错误、执行失败、输出漂移和跨来源冲突下的表现。论文报告称,在工具正常时表现良好的 agent,在这些风险下会退化;而有针对性的恢复提示比单纯增加测试时计算量更有帮助。这是基准测试结果,而不是生产事故率。
AgentTether研究了失败轨迹和受保护的运行时干预。在 261 个 tau-bench 任务中,作者报告称修复了最初失败的 Qwen 运行中的 69.11%,比盲目重试高出 26.02 个百分点。结果会因领域而异,辅助判断依赖另一个模型,而且 tau-bench 无法代表每一种生产工具链。
这些论文支持两项控制措施:
重试是一次新的执行决策,而不是上一次操作安全的证明。
可复现的权限测试工作流
在启用自主写入之前,运行以下测试:
确定性的 agent 指标开始出现在开源评估工具中。2026 年 7 月 12 日发布的 DeepEval 4.1.3新增了确定性的 ToolPermissionMetric 和 AgentLoopDetectionMetric。该版本是采用趋势的信号,并不能证明这些指标覆盖每一种滥用场景。
独立验证在安全之外同样重要。《This hybrid AI code review loop》使用独立审查者和真实构建结果作为证据。更广泛的系统性经验再次出现在《Code Agents After 21.54 Billion Tokens》中:模型质量无法取代验证和运营边界。
生产环境检查清单
OWASP 的 AI Agent Security Cheat Sheet得出了类似的运营结论:应用最小权限,将决策与不可逆执行分离,验证外部输入,强制执行循环限制,并保留结构化操作日志。
这些证据无法证明什么
这里引用的论文都是近期预印本,而不是已经确立的标准。它们的样本、模型、工具和基准限制了每一项数值结果。商业文档描述的是可用控制措施,而不是某个具体部署是否正确使用了这些措施。GitHub 发布记录和 issue 报告显示了活跃的工程压力,但不能代表整个生态系统的故障率。
因此,这套架构是一种决策框架,而不是认证。它的价值在于让安全边界可检查:模型提出;策略决策;基础设施执行;工具操作;独立证据验证。
声明核查
| 声明 | 状态 | 证据 | 局限 |
|---|---|---|---|
| --- | --- | --- | --- |
| 权限评审没有发现同时具备三个目标属性的实现 | 已验证 | Michael 和 Roesner,arXiv:2607.13718 | 21 项、滚雪球抽样、快速变化的语料 |
| MCP server 必须验证令牌受众,且不得透传客户端令牌 | 已验证 | MCP 授权规范,2025-06-18 | 适用于受保护的 HTTP 传输授权 |
| MemGhost 报告了两个测试配置中 87.5% 和 71.4% 的留出端到端成功率 | 有限定条件 | Yao 等,arXiv:2607.05189 | 特定模型、agent、电子邮件工作流和评估设置 |
| AgentTether 在主要的 261 任务评估中修复了 69.11% 的初始失败运行 | 有限定条件 | arXiv:2607.06273 | 仅限 tau-bench;辅助模型判断;领域差异 |
| DeepEval 4.1.3 新增了确定性的循环和工具权限指标 | 已验证 | DeepEval v4.1.3 发布说明 | 指标可用不代表覆盖完整 |