GPT-6.1 Sol привернув мою увагу, тому що я хочу виконувати більше корисної агентної роботи, не сприймаючи кожне завдання як витрату на преміум-модель. Цікаве питання полягає в тому, скільки правильної роботи, яку можна перевірити, я можу отримати за свій бюджет.
Мій перший висновок: Sol заслуговує на місце в розмові про моделі для щоденного використання. Claude Opus 5.5 також заслуговує на серйозне порівняння, особливо коли якість важливіша за швидкість першої відповіді. Я протестую обидві моделі на реальній роботі. Поки що я розділяю опубліковані бенчмарки, перші звіти користувачів і власні очікування.
*Перевірка джерел: 29 вересня 2026 року. Головне зображення — редакційна ілюстрація, створена за допомогою AI. Діаграми даних я побудував на основі наведених опублікованих значень; це не скриншоти моїх власних тестів.*
Для чого підходить GPT-6.1 Sol?
OpenAI позиціонує GPT-6.1 Sol для складного програмування, роботи з комп’ютером і професійних завдань, прагнучи наблизити його до Astra за нижчою ціною. Його ідентифікатор моделі API — gpt-6.1-sol, контекстне вікно має 1 050 000 токенів, а максимальна кількість вихідних токенів — 128 000. Дивіться офіційну документацію моделі GPT-6.1 Sol.
Для моєї роботи це підказує три корисні напрямки для початку:
Це кандидати для оцінювання, а не обіцянки, що модель виконуватиме такі завдання без нагляду. Я все одно залишив би операції запису у production за схваленням і вимагав би від агента показувати свої докази.
Це продовжує те саме практичне питання, яке я порушував у своєму огляді GPT-6 Astra: чи допомагає модель завершити роботу після підключення до наявної системи?
Ціна GPT-6.1 Sol проти Claude Opus 5.5
Стандартне порівняння API є простим. Це ціни в USD за мільйон токенів без урахування інструментів, записів у кеш, надбавок за швидкість або регіональних коефіцієнтів.
| Тип токенів | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Вхідні | $2.00 | $4.00 |
| Кешовані вхідні | $0.10 | $0.20 |
| Вихідні | $10.00 | $20.00 |
Джерела: ціни OpenAI API і ціни Claude Platform.
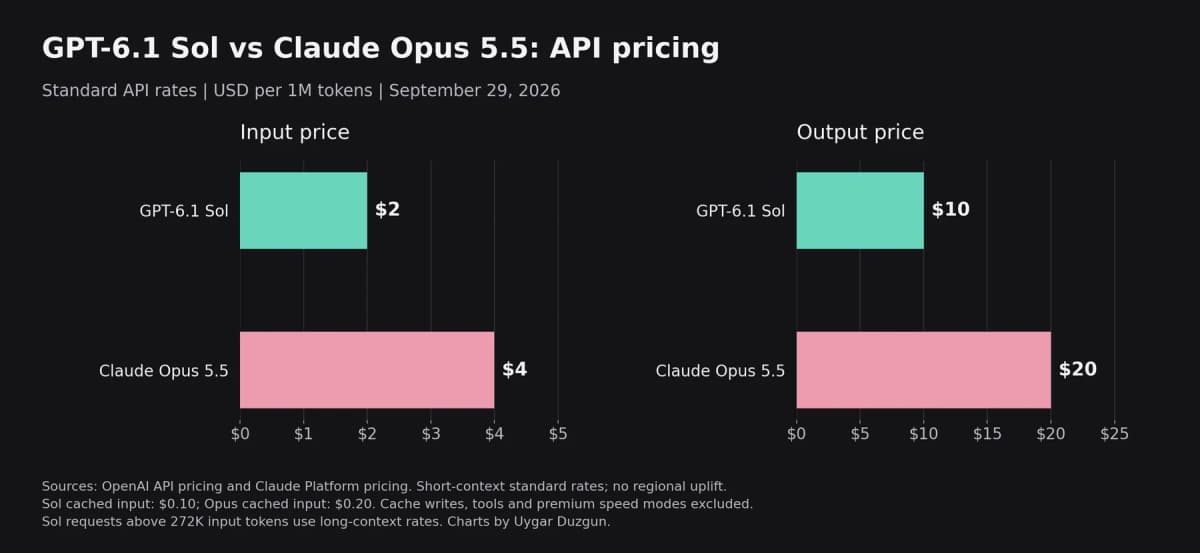
*Стандартні тарифи для короткого контексту. Таблиця містить кешовані читання; на діаграмі показано звичайні ціни вхідних і вихідних токенів.*
У цих категоріях Sol коштує вдвічі дешевше за токен. Але це не означає, що кожне завершене завдання коштуватиме вдвічі дешевше. Моделі можуть використовувати різний обсяг міркувань, викликати різні інструменти й потребувати різної кількості повторних спроб.
Довгий контекст також змінює порівняння. Sol застосовує вищі тарифи до всього запиту, якщо в одному промпті понад 272 000 вхідних токенів: подвоєну ставку для вхідних і кешованих вхідних токенів та ставку, збільшену в 1,5 раза, для вихідних токенів. Anthropic вказує стандартні ціни для всього контекстного вікна Opus 5.5. Сукупний лічильник токенів тривалої сесії — це не те саме, що один промпт, який перевищує цей поріг.
Для довідки про попередній реліз мій огляд GPT-6 Sol і Luna охоплює попередню лінійку.
Бенчмарки GPT-6.1 Sol: оцінка та вартість разом
AutomationBench: Sol дешевший; Opus досягає вищого результату на максимальному рівні
AutomationBench 1.0.6 тестує наскрізні бізнес-процеси в 47 інструментах. Zapier оцінює кінцевий стан за допомогою детермінованих перевірок, а не просить іншу мовну модель оцінити відповідь.
| Конфігурація | Оцінка | USD за спробу виконання завдання |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, medium | 31.7% | $0.19 |
| Opus 5.5, medium, стандартні fallback-механізми | 29.5% | $0.65 |
| Sol 6.1, max | 36.1% | $0.30 |
| Opus 5.5, max, стандартні fallback-механізми | 42.5% | $1.44 |
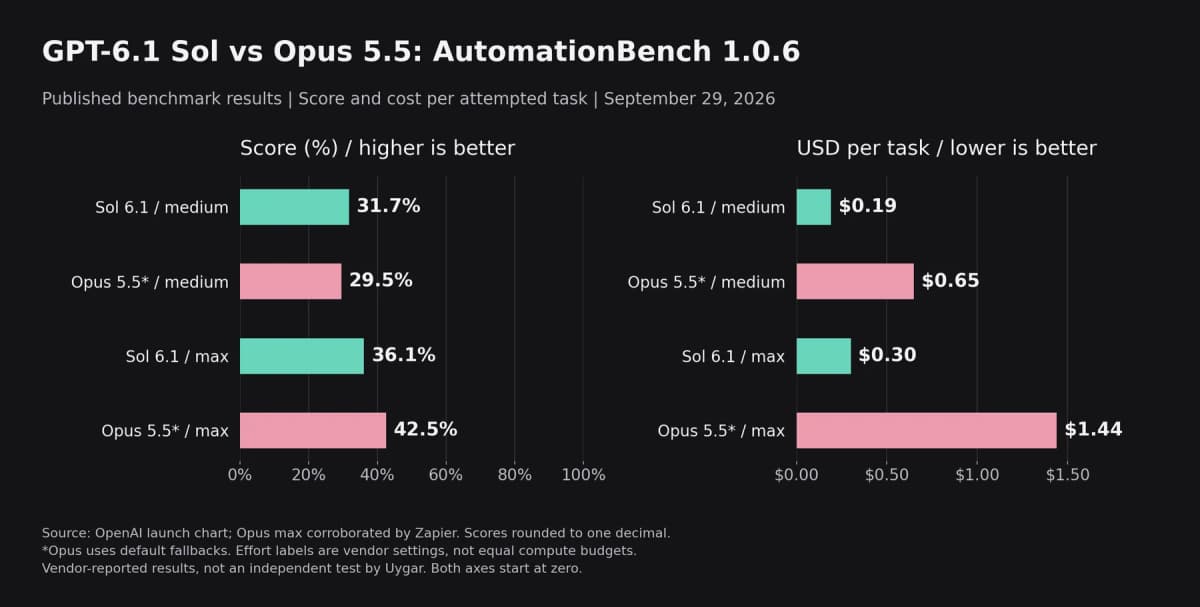
*Значення з графіків OpenAI, присвячених запуску, з округленням оцінок до одного десяткового знака. Zapier підтверджує результат Opus на максимальному рівні. Конфігурація Opus містить стандартні fallback-механізми; позначення рівня зусиль від постачальників не означають однакових обчислювальних бюджетів.*
На середньому рівні Sol має помірну перевагу за оцінкою та нижчу заявлену вартість завдання. На максимальному рівні Opus має вищу оцінку. Я обирав би між цими компромісами з огляду на ціну помилки процесу, включно з часом, який хтось витрачає на перевірку результату.
Ці витрати охоплюють спроби виконання завдань, зокрема невдалі. Це не ціни за гарантований успішний бізнес-результат.
DeepSWE: корисне покращення порівняно з попереднім Sol
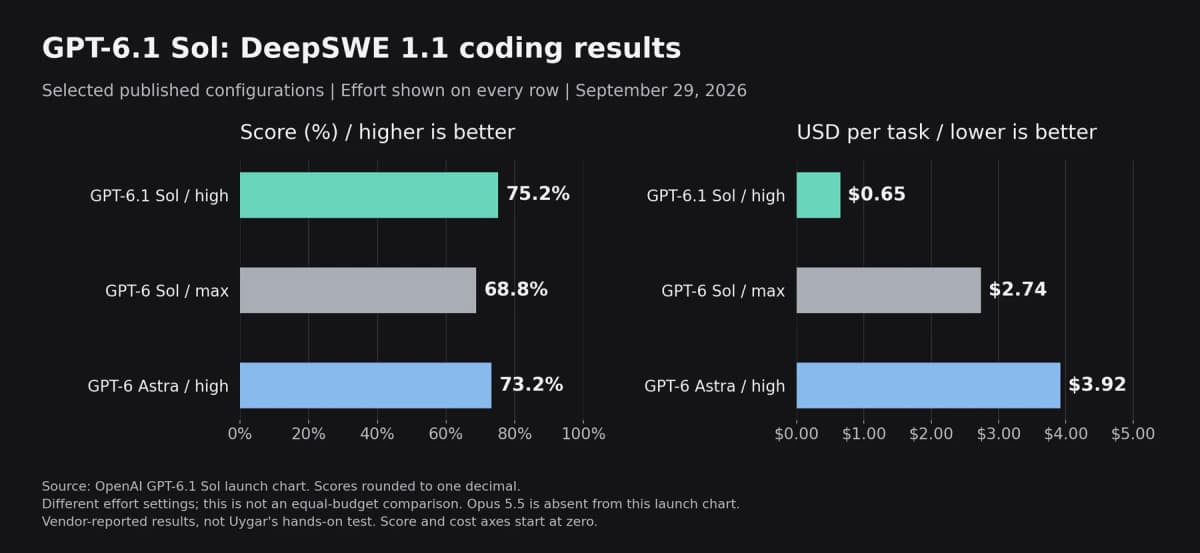
*Вибрані значення DeepSWE 1.1 з тих самих графіків OpenAI, присвячених запуску: Sol 6.1 high — 75.2% за $0.65; попередній Sol max — 68.8% за $2.74; Astra high — 73.2% за $3.92 за завдання. Різні рівні зусиль вказано явно.*
Бенчмарк DeepSWE використовує довгі завдання в репозиторіях і поведінкові верифікатори. OpenAI не включає Opus 5.5 до цього графіка запуску. Я не ставитиму поруч із ним непов’язану оцінку FrontierCode і не робитиму вигляд, що вони вимірюють одне й те саме.
OpenAI поєднує власні оцінювання з публічно оприлюдненими результатами конкурентів. Сприймайте це як опубліковані докази, а не як незалежний очний тест, проведений мною.
Де Claude Opus 5.5 досі важливий
Anthropic позиціонує Opus 5.5 для тривалого програмування та роботи зі знаннями. У звіті про запуск наведено результат 54.6% у FrontierCode v1.1 Main на стандартному середньому рівні зусиль і описано покращення в багатофайловому програмуванні. Ці результати використовують інший бенчмарк, ніж DeepSWE. Anthropic також наводить ранні відгуки партнерів про меншу кількість кроків і токенів, але це все ще атрибутовані відгуки, а не контрольоване порівняння із Sol 6.1. Дивіться анонс Opus 5.5.
Я залишив би Opus у порівнянні для складних змін, рев’ю та візуальної роботи, де ще один прохід може покращити фінальний результат. Я перевірив би цю гіпотезу, а не призначав би моделі постійну спеціалізацію на основі тижня запуску.
Мій матеріал бенчмарки та реакції на Claude Opus 5.5 детальніше розглядає його реліз.
Що кажуть інші користувачі?
Перші реакції неоднозначні. У обговоренні запуску на Reddit деякі користувачі позитивно сприйняли дешевші кешовані читання; інші поставили під сумнів, наскільки модель буде схожою на Astra, і віддали перевагу Claude. Це індивідуальні реакції, а не репрезентативне опитування.
Ще один конкретніший тест трьох моделей від digitalml використовував той самий промпт для кінематографічної сцени Three.js на середньому рівні зусиль. Заявлений час становив 8 хвилин 42 секунди для Sol 6.1, 9 хвилин 37 секунд для Astra та 38 хвилин 54 секунди для Opus 5.5. Автор віддав перевагу кінематографічному результату Opus і повідомив про проблеми з камерою та звуком у версії Sol.
Цей єдиний приклад відображає компроміс, який варто дослідити: швидке завершення може мати значення, але важливими також можуть бути відшліфованість і поведінка після завантаження сторінки. Він не встановлює загального рейтингу швидкості чи якості.
Як я тестуватиму GPT-6.1 Sol
Я дам Sol і Opus те саме завдання, початкові файли, доступ до інструментів і критерії приймання. Я хочу записувати правильність, час виконання, кількість повторних спроб, вартість токенів і обсяг перевірки, який мені все ще потрібно виконати. Швидка відповідь, після якої мені доводиться виправляти регресії, не є дешевим результатом.
Для інтеграцій API Sol потребує Responses API для викликів інструментів; Chat Completions підтримує його без інструментів. Він підтримує низький, середній, високий, xhigh і max рівні зусиль для міркувань, причому середній є стандартним. Наведена вище документація моделі визначає ці обмеження.
Моя практична відправна точка — середній рівень, чітко окреслений опис і виконувані перевірки. Я підвищуватиму рівень зусиль, коли цього потребуватиме завдання, а потім порівнюватиму результат. Додаткові міркування мають виправдовувати свій додатковий час і вартість.
Я радий спробувати GPT-6.1 Sol, тому що опубліковане співвідношення ціни та продуктивності виглядає корисним для повторюваної агентної роботи. Opus 5.5 залишається сильною альтернативою. Я вирішу, де саме використовувати кожну модель, після того як отримаю докази із завдань, які мені потрібно завершити.
---