GPT-6.1 Sol dikkatimi çekiyor çünkü her görevi premium model masrafı olarak görmeden daha faydalı agent çalışmaları yürütmek istiyorum. İlginç soru şu: bütçe dahilinde ne kadar doğru ve incelenebilir iş elde edebilirim?
İlk izlenimim: Sol, günlük kullanım için tercih edilen model tartışmasında kendine yer edinmeyi hak ediyor. Özellikle kalite ilk yanıt süresinden daha önemli olduğunda Claude Opus 5.5 de ciddi bir karşılaştırmayı hak ediyor. İkisini gerçek işler üzerinde test edeceğim. Şimdilik yayımlanmış benchmark sonuçlarını, ilk kullanıcı raporlarını ve kendi beklentilerimi birbirinden ayırıyorum.
*Kaynak kontrolü: 29 Eylül 2026. Kapak görseli AI ile oluşturulmuş editoryal bir illüstrasyondur. Veri grafiklerini, atıf yapılan yayımlanmış değerlerden kendim oluşturdum; bunlar kendi testlerimin ekran görüntüleri değildir.*
GPT-6.1 Sol ne için iyi?
OpenAI, GPT-6.1 Sol'u karmaşık coding, computer use ve profesyonel işler etrafında konumlandırıyor; daha düşük bir fiyatla Astra'ya yaklaşmayı hedefliyor. API model ID'si gpt-6.1-sol; 1.050.000 token'lık context window ve 128.000 token'a kadar output token desteği sunuyor. Resmî GPT-6.1 Sol model dokümantasyonuna bakabilirsiniz.
Benim işlerim açısından bu, başlamak için üç faydalı alan öneriyor:
Bunlar değerlendirme adaylarıdır; modelin bu işleri gözetimsiz şekilde yürüteceğine dair vaatler değildir. Production yazma işlemlerini yine onay arkasında tutar ve agent'ın kanıtlarını göstermesini isterim.
Bu yaklaşım, GPT-6 Astra incelememde sorduğum aynı pratik soruyu takip ediyor: Model, mevcut bir sisteme bağlandığında işin tamamlanmasına yardımcı oluyor mu?
GPT-6.1 Sol ve Claude Opus 5.5 fiyat karşılaştırması
Standart API karşılaştırması oldukça basit. Bunlar tool'lar, cache yazma işlemleri, hız primleri veya bölgesel değişkenler öncesindeki, milyon token başına USD fiyatlarıdır.
| Token türü | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Input | $2.00 | $4.00 |
| Cached input | $0.10 | $0.20 |
| Output | $10.00 | $20.00 |
Kaynaklar: OpenAI API fiyatlandırması ve Claude Platform fiyatlandırması.
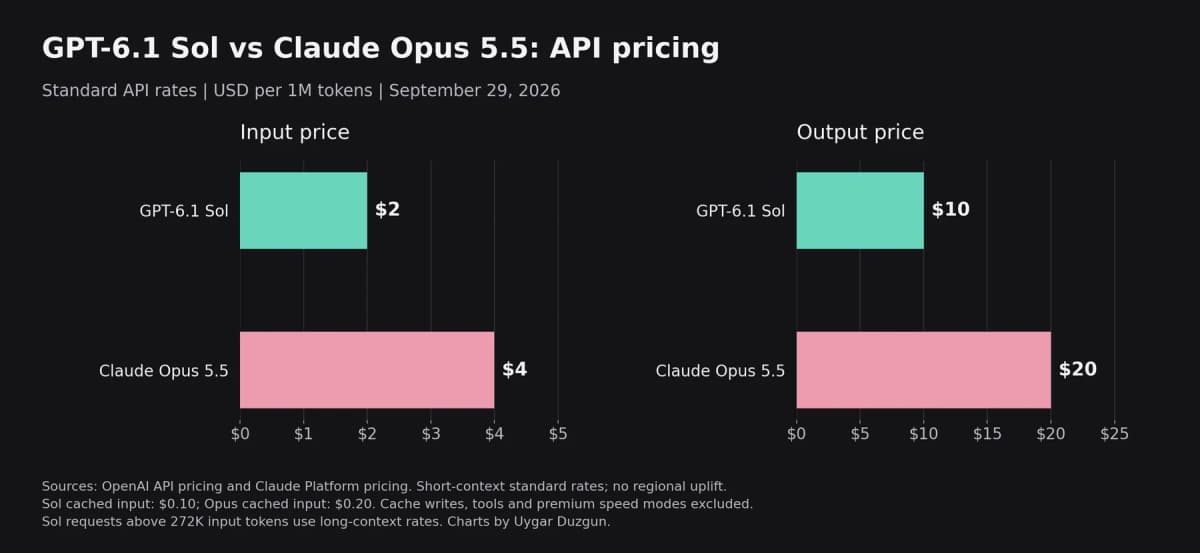
*Standart kısa context oranları. Tablo cached read işlemlerini içerir; grafik normal input ve output fiyatlarını gösterir.*
Sol, bu kategorilerde token başına yarı yarıya daha ucuz. Bu, tamamlanan her işin yarı fiyatına mal olacağı anlamına gelmez. Modeller farklı miktarlarda reasoning kullanabilir, farklı tool'lar çağırabilir ve farklı sayıda yeniden denemeye ihtiyaç duyabilir.
Uzun context de karşılaştırmayı değiştirir. Sol, tek bir prompt içindeki 272.000 input token üzerindeki isteğin tamamına daha yüksek oranlar uygular: input ve cached-input oranının iki katı, output oranının ise 1,5 katı. Anthropic, Opus 5.5'in tam context window'u genelinde standart fiyatlandırma listeler. Uzun süren bir oturumun toplam token sayacı, tek bir prompt'un bu eşiği aşmasıyla aynı şey değildir.
Önceki sürüm hakkında arka plan için GPT-6 Sol ve Luna genel bakışım önceki ürün ailesini ele alıyor.
GPT-6.1 Sol benchmark sonuçları: skor ve maliyeti birlikte değerlendirmek
AutomationBench: Sol daha ucuz; Opus maksimum ayarda daha yüksek skora ulaşıyor
AutomationBench 1.0.6, 47 tool genelinde uçtan uca business workflow'larını test ediyor. Zapier, yanıtı başka bir language model'e değerlendirtmek yerine ortaya çıkan durumu deterministik kontrollerle puanlıyor.
| Yapılandırma | Skor | Denenen görev başına USD |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, medium | 31.7% | $0.19 |
| Opus 5.5, medium, varsayılan fallback'ler | 29.5% | $0.65 |
| Sol 6.1, max | 36.1% | $0.30 |
| Opus 5.5, max, varsayılan fallback'ler | 42.5% | $1.44 |
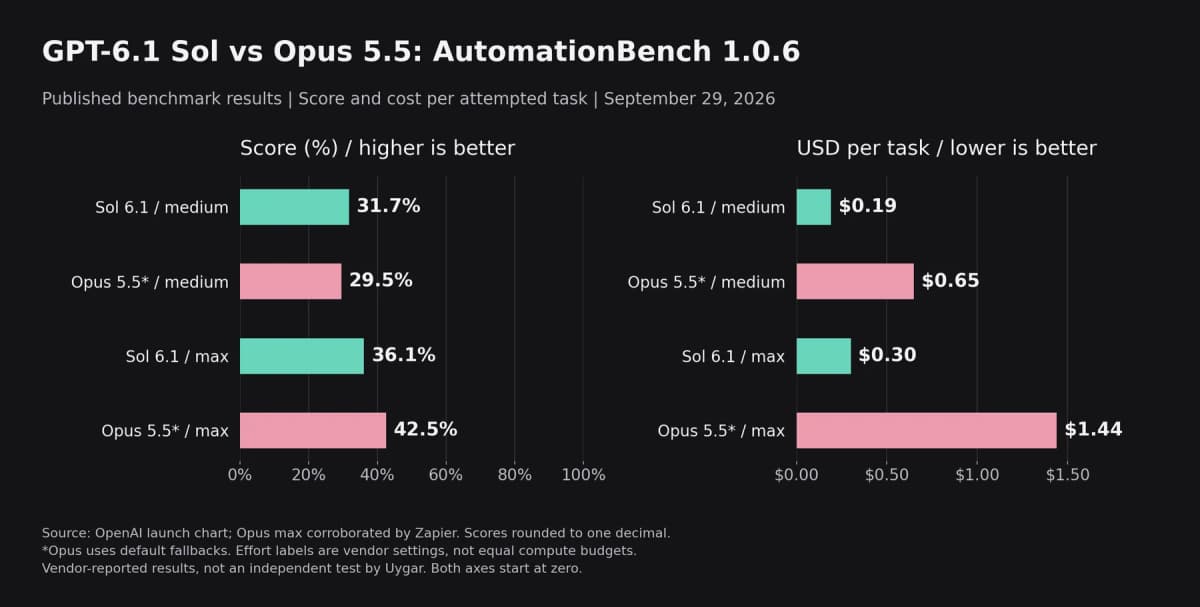
*Değerler, skorlar bir ondalık basamağa yuvarlanarak OpenAI'ın lansman grafiklerinden alınmıştır. Zapier, Opus max sonucunu doğruluyor. Opus yapılandırması varsayılan fallback'leri içerir; sağlayıcıların effort etiketleri eşit compute bütçelerini temsil etmez.*
Medium seviyesinde Sol, mütevazı bir skor üstünlüğü ve daha düşük raporlanan görev maliyeti sunuyor. Max seviyesinde ise Opus daha yüksek skora sahip. Bu ödünleşimler arasında seçim yaparken, birinin sonucu kontrol etmek için harcadığı zaman da dahil olmak üzere workflow'un hata maliyetini dikkate alırdım.
Bu maliyetler, başarısızlıklar da dahil olmak üzere denenen görevleri kapsar. Garantili başarılı bir business sonucu için fiyat değildir.
DeepSWE: Önceki Sol'a kıyasla faydalı bir yükseltme
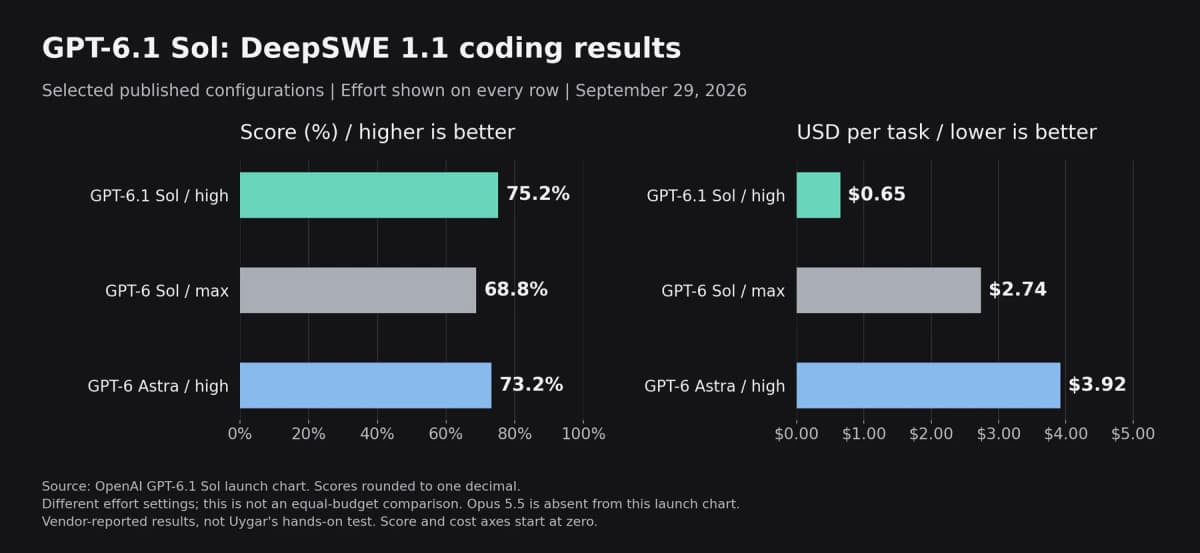
*OpenAI'ın aynı lansman grafiklerinden seçilen DeepSWE 1.1 değerleri: Sol 6.1 high, görev başına $0.65 ile %75.2; önceki Sol max, görev başına $2.74 ile %68.8; Astra high, görev başına $3.92 ile %73.2. Farklı effort ayarları açıkça belirtilmiştir.*
DeepSWE benchmark'ı, uzun süreli repository görevleri ve davranışsal doğrulayıcılar kullanır. OpenAI bu lansman grafiğinde Opus 5.5'e yer vermiyor. İlgisiz bir FrontierCode skorunu yanına koyup aynı şeyi ölçüyormuş gibi davranmayacağım.
OpenAI, kendi değerlendirmelerini kamuya açık şekilde raporlanan rakip sonuçlarıyla birleştiriyor. Bunu benim gerçekleştirdiğim bağımsız bir head-to-head test değil, yayımlanmış kanıt olarak değerlendirin.
Claude Opus 5.5 neden hâlâ önemli?
Anthropic, Opus 5.5'i uzun süren coding ve knowledge work için konumlandırıyor. Lansman raporu, varsayılan medium effort seviyesinde %54.6 FrontierCode v1.1 Main skoru veriyor ve multi-file coding alanındaki gelişmeleri açıklıyor. Bu sonuçlar DeepSWE'den farklı bir benchmark kullanıyor. Anthropic ayrıca daha az adım ve token kullanıldığına dair ilk partner geri bildirimlerini de paylaşıyor; bunlar Sol 6.1 ile kontrollü bir karşılaştırma değil, atfedilmiş geri bildirimler olarak kalıyor. Opus 5.5 duyurusuna bakabilirsiniz.
Zor değişiklikler, review ve başka bir geçişin nihai sonucu iyileştirebileceği görsel işler için Opus'u karşılaştırmada tutardım. Lansman haftasındaki sonuçlara dayanarak modele kalıcı bir uzman rolü vermek yerine bu hipotezi test ederdim.
Claude Opus 5.5 benchmark sonuçlarım ve tepkiler, lansmanı daha ayrıntılı ele alıyor.
Diğer kullanıcılar ne söylüyor?
İlk tepkiler karışık. Reddit'teki bir lansman tartışmasında, bazı kullanıcılar daha ucuz cache read işlemlerini memnuniyetle karşıladı; diğerleri modelin Astra'ya ne kadar yakın hissettireceğini sorguladı ve Claude'u tercih etti. Bunlar bireysel tepkilerdir, temsili bir anket değildir.
Daha somut bir digitalml tarafından gerçekleştirilen üç model testi, medium effort seviyesinde aynı sinematik Three.js sahne prompt'unu kullandı. Raporlanan süreler Sol 6.1 için 8 dakika 42 saniye, Astra için 9 dakika 37 saniye ve Opus 5.5 için 38 dakika 54 saniyeydi. Yazarı Opus'un sinematik sonucunu tercih etti ve Sol'un sürümünde kamera ve ses sorunları olduğunu bildirdi.
Bu tek örnek, araştırmaya değer bir ödünleşimi yakalıyor: İlk bitiren olmak önemli olabilir, ancak sayfa yüklendikten sonraki polish ve davranış da önemlidir. Bu, genel bir hız veya kalite sıralaması oluşturmaz.
GPT-6.1 Sol'u nasıl test edeceğim?
Sol ve Opus'a aynı görevi, başlangıç dosyalarını, tool erişimini ve kabul kontrollerini vereceğim. Doğruluğu, geçen süreyi, yeniden denemeleri, token maliyetini ve hâlâ yapmam gereken review işini kaydetmek istiyorum. Beni regression'ları düzeltmek zorunda bırakan hızlı bir yanıt ucuz bir sonuç değildir.
API entegrasyonları için Sol, tool calling amacıyla Responses API gerektirir; Chat Completions ise tool'lar olmadan bunu destekler. low, medium, high, xhigh ve max reasoning effort seviyelerini destekler; varsayılan medium'dur. Yukarıdaki model dokümantasyonu bu kısıtları tanımlar.
Pratik başlangıç noktam medium, kapsamı belirlenmiş bir brief ve çalıştırılabilir kontroller olacak. Bir görev gerektirdiğinde effort seviyesini artıracak, ardından sonucu karşılaştıracağım. Daha fazla reasoning, ek zamanını ve maliyetini karşılamalıdır.
GPT-6.1 Sol'u denemek için heyecanlıyım çünkü yayımlanmış fiyat-performans oranı tekrarlanan agent çalışmaları için faydalı görünüyor. Opus 5.5 güçlü bir alternatif olmaya devam ediyor. Her birinin nerede konumlanacağına, tamamlamam gereken görevlerden elde edeceğim kanıtlara sahip olduktan sonra karar vereceğim.