GPT-6.1 Sol har fångat min uppmärksamhet eftersom jag vill köra mer användbart agentarbete utan att behandla varje uppgift som en kostnad för en premiummodell. Den intressanta frågan är hur mycket korrekt och granskningsbart arbete jag kan få för budgeten.
Mitt första intryck: Sol förtjänar en plats i diskussionen om den dagliga arbetsmodellen. Claude Opus 5.5 förtjänar fortfarande en seriös jämförelse, särskilt när kvalitet är viktigare än den första svarstiden. Jag kommer att testa båda på verkligt arbete. Just nu skiljer jag mellan publicerade riktmärken, tidiga användarrapporter och mina egna förväntningar.
*Källkontroll: 29 september 2026. Hjältebilden är en AI-genererad redaktionell illustration. Jag ritade datadiagrammen utifrån de citerade publicerade värdena; de är inte skärmbilder från mina egna tester.*
Vad är GPT-6.1 Sol bra för?
OpenAI positionerar GPT-6.1 Sol för komplex kodning, datoranvändning och professionellt arbete, med målet att komma närmare Astra till ett lägre pris. Dess API-modell-ID är gpt-6.1-sol, med ett kontextfönster på 1 050 000 tokens och upp till 128 000 output-tokens. Se den officiella modelldokumentationen för GPT-6.1 Sol.
För mitt arbete antyder det tre bra ställen att börja på:
Det här är kandidater för utvärdering, inte löften om att modellen kan hantera dem utan tillsyn. Jag skulle fortfarande hålla produktionsskrivningar bakom godkännande och kräva att agenten visar sina belägg.
Detta följer samma praktiska fråga som i min recension av GPT-6 Astra: hjälper modellen till att slutföra arbetet när den kopplas till ett befintligt system?
Prissättning för GPT-6.1 Sol jämfört med Claude Opus 5.5
Den vanliga API-jämförelsen är enkel. Detta är priser i USD per en miljon tokens, före verktyg, cache-skrivningar, hastighetspremier eller regionala justeringar.
| Tokentyp | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Input | $2.00 | $4.00 |
| Cachad input | $0.10 | $0.20 |
| Output | $10.00 | $20.00 |
Källor: OpenAI API-priser och Claude Platform-priser.
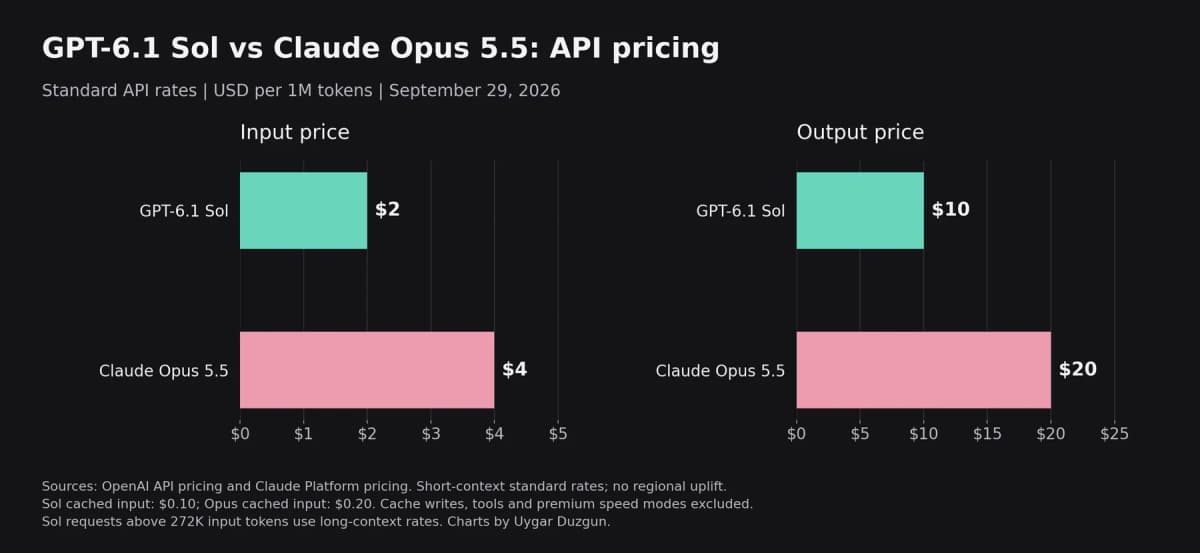
*Standardpriser för kort kontext. Tabellen inkluderar cachade läsningar; diagrammet visar vanliga input- och outputpriser.*
Sol kostar hälften så mycket per token i dessa kategorier. Det betyder inte att varje slutförd uppgift kostar hälften så mycket. Modeller kan använda olika mängder resonemang, anropa olika verktyg och behöva olika många nya försök.
Lång kontext förändrar också jämförelsen. Sol tillämpar högre priser på hela förfrågan över 272 000 input-tokens i en prompt: dubbla priser för input och cachad input samt 1,5 gånger outputpriset. Anthropic listar standardpriser för hela kontextfönstret i Opus 5.5. En långvarig sessions sammanlagda tokencounter är inte samma sak som att en enskild prompt passerar den tröskeln.
För bakgrund om den tidigare lanseringen täcker min översikt över GPT-6 Sol och Luna den föregående modellserien.
Riktmärken för GPT-6.1 Sol: poäng och kostnad tillsammans
AutomationBench: Sol är billigare; Opus når högre vid max
AutomationBench 1.0.6 testar affärsarbetsflöden från början till slut över 47 verktyg. Zapier poängsätter det resulterande tillståndet med deterministiska kontroller i stället för att be en annan språkmodell bedöma svaret.
| Konfiguration | Poäng | USD per försökt uppgift |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, medium | 31.7% | $0.19 |
| Opus 5.5, medium, standardreservlösningar | 29.5% | $0.65 |
| Sol 6.1, max | 36.1% | $0.30 |
| Opus 5.5, max, standardreservlösningar | 42.5% | $1.44 |
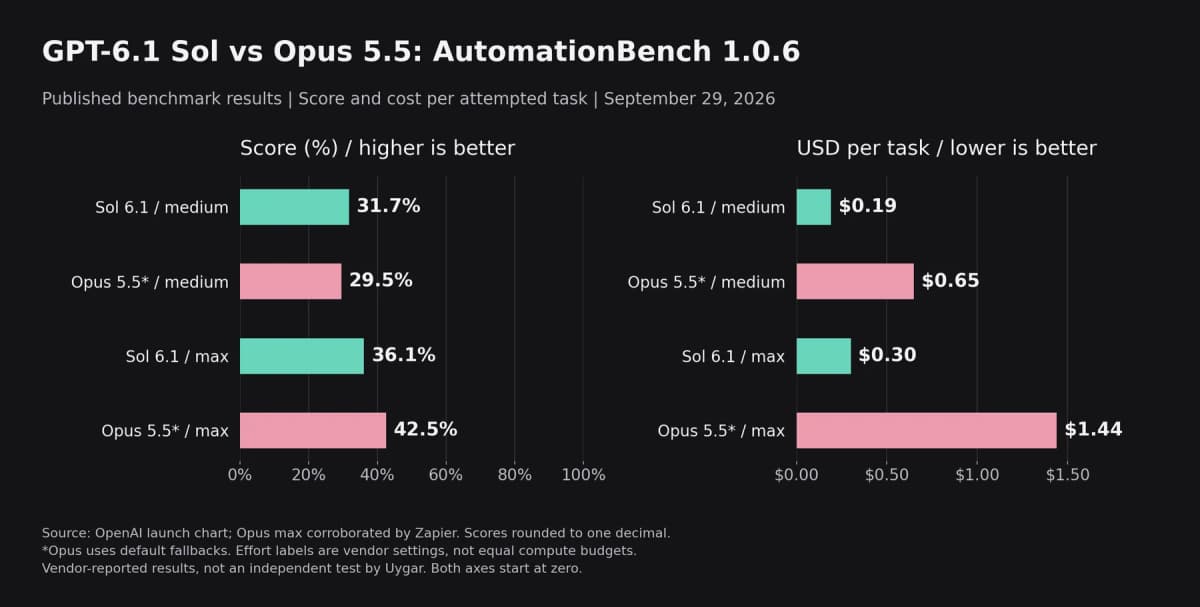
*Värden från OpenAI:s lanseringsdiagram, med poäng avrundade till en decimal. Zapier bekräftar Opus-resultatet vid max. Opus-konfigurationen inkluderar standardreservlösningar; leverantörernas etiketter för ansträngning motsvarar inte lika stora beräkningsbudgetar.*
Vid medium erbjuder Sol ett måttligt poängövertag och en lägre rapporterad uppgiftskostnad. Vid max har Opus den högre poängen. Jag skulle välja mellan dessa avvägningar utifrån arbetsflödets kostnad vid fel, inklusive tiden någon behöver lägga på att kontrollera resultatet.
Dessa kostnader omfattar försökte uppgifter, inklusive misslyckanden. De är inte priser för ett garanterat framgångsrikt affärsresultat.
DeepSWE: en användbar uppgradering jämfört med den tidigare Sol
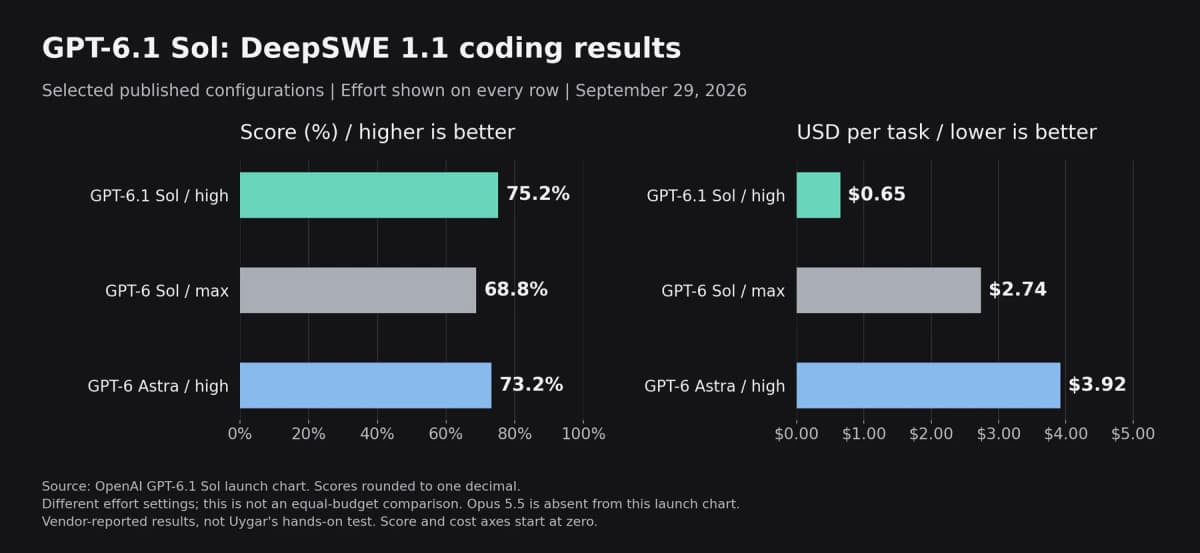
*Utvalda DeepSWE 1.1-värden från samma lanseringsdiagram från OpenAI: Sol 6.1 high, 75.2% för $0.65; tidigare Sol max, 68.8% för $2.74; Astra high, 73.2% för $3.92 per uppgift. Olika ansträngningsnivåer anges uttryckligen.*
Riktmärket DeepSWE använder repository-uppgifter med lång tidshorisont och beteendeverifierare. OpenAI inkluderar inte Opus 5.5 i detta lanseringsdiagram. Jag kommer inte att placera en orelaterad FrontierCode-poäng bredvid det och låtsas att de mäter samma sak.
OpenAI kombinerar sina egna utvärderingar med offentligt rapporterade konkurrentresultat. Se detta som publicerade belägg, inte som en oberoende jämförelse sida vid sida som jag själv har genomfört.
Varför Claude Opus 5.5 fortfarande är relevant
Anthropic positionerar Opus 5.5 för långvarig kodning och kunskapsarbete. Dess lanseringsrapport anger en poäng på 54.6% i FrontierCode v1.1 Main vid standardinställningen medium och beskriver förbättringar inom kodning över flera filer. Dessa resultat använder ett annat riktmärke än DeepSWE. Anthropic inkluderar också tidiga partnerreaktioner om färre steg och tokens, vilket fortfarande är återgivna omdömen snarare än en kontrollerad jämförelse med Sol 6.1. Se tillkännagivandet av Opus 5.5.
Jag skulle behålla Opus i jämförelsen för svåra ändringar, granskning och visuellt arbete där ytterligare en genomgång kan förbättra slutresultatet. Jag skulle testa den hypotesen i stället för att ge modellen en permanent specialistroll baserat på lanseringsveckan.
Min genomgång av riktmärken och reaktioner på Claude Opus 5.5 behandlar lanseringen mer detaljerat.
Vad säger andra användare?
De tidiga reaktionerna är blandade. I en lanseringsdiskussion på Reddit välkomnade vissa användare billigare cachade läsningar, medan andra ifrågasatte hur nära modellen skulle kännas Astra och föredrog Claude. Detta är individuella reaktioner, inte en representativ undersökning.
Ett mer konkret test av tre modeller från digitalml använde samma prompt för en filmisk Three.js-scen vid medium. De rapporterade tiderna var 8 minuter och 42 sekunder för Sol 6.1, 9 minuter och 37 sekunder för Astra samt 38 minuter och 54 sekunder för Opus 5.5. Författaren föredrog Opus filmiska resultat och rapporterade problem med kamera och ljud i Sols version.
Det enda exemplet fångar en avvägning som är värd att undersöka: det kan vara viktigt att bli klar först, men även finish och beteende efter att sidan har laddats spelar roll. Det fastställer inte någon generell rangordning för hastighet eller kvalitet.
Så kommer jag att testa GPT-6.1 Sol
Jag kommer att ge Sol och Opus samma uppgift, startfiler, verktygsåtkomst och godkännandekontroller. Jag vill registrera korrekthet, förfluten tid, nya försök, tokenkostnad och det granskningsarbete jag fortfarande behöver utföra. Ett snabbt svar som lämnar mig med regressionsfixar är inte ett billigt resultat.
För API-integrationer kräver Sol Responses API för verktygsanrop; Chat Completions stöder det utan verktyg. Det stöder låg, medium, hög, xhigh och max reasoning effort, där medium är standard. Modelldokumentationen ovan definierar dessa begränsningar.
Min praktiska startpunkt är medium, en avgränsad brief och körbara kontroller. Jag kommer att höja ansträngningen när en uppgift kräver det och sedan jämföra resultatet. Mer resonemang bör förtjäna sin extra tid och kostnad.
Jag ser fram emot att prova GPT-6.1 Sol eftersom den publicerade pris-prestandan verkar användbar för upprepat agentarbete. Opus 5.5 är fortfarande ett starkt alternativ. Jag kommer att avgöra var varje modell hör hemma efter att jag har fått belägg från de uppgifter jag behöver slutföra.