Mitt långvariga Codex-mål: Fyra dagar och fortfarande igång
Den 9 oktober 2026 visade mitt långvariga Codex-mål 4 dagar, 14 timmar, 8 minuter och 22 sekunder. Jag tog en skärmbild medan Codex fortfarande arbetade med en SEO-produkt som jag ännu inte har lanserat. Målet förblev öppet, med fler uppgifter att slutföra.
Jag hade bett det att slutföra hela planen för den ännu inte lanserade SEO-produkt som jag bygger. Vid det laget hade jag också bett det att använda fler agenter, sänka resonemangsansträngningen, pausa för uppdateringar, återuppta arbetet efter en omstart och lägga mindre tid på att upprepa tester.
Det här är min redogörelse för ett långvarigt Codex-mål: arbetet det producerade, arbetet som saktade ner det och besluten jag fortfarande behövde fatta. Det är ett ofärdigt bygge, inte ett benchmark eller ett lanseringsmeddelande.
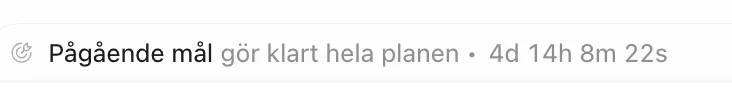
Timern ovan hör till målet. Den fastställer inte fyra dagar av oavbruten modellberäkning. Min session innehåller uttryckliga pauser och återupptagningar, en appuppdatering, en omstart av datorn, verktygskörning och väntetid.
Vad jag bad Codex att bygga
Samtalet började den 3 oktober med en mindre fråga: har användarna egna inloggningsuppgifter, kan de logga in med Google och kan de skapa personliga MCP-nycklar?
Sedan utökade jag kraven. Varje användare skulle se sina egna projekt. Användare skulle kunna bjuda in personer till en arbetsyta. Jag ville ha inställningar för personliga preferenser och crawler-samtidighet. Plattformen skulle så småningom bli kommersiell, med en kostnadsfri första lansering.
Jag tillhandahöll en mycket större SEO-produktkatalog som vägledning för bygget. Den resulterande planen omfattade 15 produktområden, 42 appreferenser och 19 offentliga kostnadsfria verktyg, samt en funktion för rankning av webbplatstrafik. Den inkluderade teknisk SEO, sökordsanalys, rankningar, backlinks, AI-synlighet, innehåll, analys, lokal SEO och senare företagsfunktioner.
Jag ville också att produkten skulle beställa artiklar från innehållsmotorn bakom min egen webbplats.
Instruktionen att slutföra hela planen syftade alltså på en omfattande produktroadmap. Jag hjälpte till att skapa den omfattningen. En fyradagars timer för en liten buggfix skulle ha berättat en annan historia.
Vilken modell och vilka inställningar jag använde
Huvudsessionens logg identifierar modellen som GPT-6.1 Sol, med identifieraren gpt-6.1-sol. De registrerade turerna omfattar ultra-, medium- och ett litet antal high-resonemangsinställningar. Det identifierar huvudsessionen; det fastställer inte modellen bakom varje granskare eller externt verktyg.
Den 5 oktober bytte jag uttryckligen ansträngningsnivån till medium för att spara tokens. Därefter stängde jag av turbo av samma anledning. Det var mina avsikter, inte uppmätta besparingar: jag har ingen granskad kostnadsjämförelse för de två konfigurationerna.
Jag bad också om fler parallella agenter. Sessionen använde delegerat arbete och Claude-granskningar av delar av implementationen. Det gjorde att separata uppgifter kunde gå framåt, men skapade också arbete med att sammanföra deras resultat och verifiera det kombinerade resultatet.
Min tidigare GPT-6.1 Sol-jämförelse→ täcker publicerade modelldata. Det här bygget är en annan typ av evidens: ett verkligt projekt med föränderlig omfattning och ändrade inställningar, snarare än en kontrollerad jämförelse mellan modeller.
Hur länge kan ett Codex-mål fortsätta arbeta?
I det här fallet visade gränssnittet mer än fyra dagar för samma pågående mål. Det är den observation jag kan stödja. Det är ingen garanti för maximal körtid, och jag kan inte beräkna aktiv inferenstid från skärmbilden.
OpenAI beskriver Goals in Codex som mål som består över flera turer. Codex kan fortsätta mot ett resultat, medan användaren kan pausa eller återuppta det. Slutförande, avbrott, budgetar och blockerare påverkar om arbetet fortsätter.
Min erfarenhet passar in på det bestående arbetsflödet. Jag kunde återvända till samma mål efter pauser och styra det fortsatta arbetet. Det var användbart att hålla målet tillgängligt. Det gjorde inte målet mindre och säkerställde inte att varje ny tur förde produkten närmare lansering.
Vad hade det levererat den 9 oktober?
Leveransloggen den 9 oktober registrerade 30 delvis slutförda krav, 39 ej bedömda och noll helt godkända krav av totalt 69 punkter i uppföljningslistan.
Den siffran behöver kontext. Listan mäter bred produktacceptans. Noll helt godkända krav betyder inte noll fungerande kod. Trettio delvisa krav betyder inte heller att produkten är 43 procent färdig.
Loggen registrerar ett tillfälligt lokalt smoke-test av en stödd kontobaslinje: skapa det första kontot, logga in med ett lösenord, läsa sessionen och dess privata ägararbetsyta, sedan logga ut och avvisa den gamla sessionen. Det är ett konkret användarflöde med ett avgränsat testresultat. Det är inte ett bevis på att den senaste kompletta applikationen är redo för kunder.
Andra framsteg omfattade lokal källkodsintegration för lösenordsåterställning, utkast till backlink-granskningar, arbete med sparade Search Console-rapporter, transport av GA4-rapporter med kundtoken och arbete med artikelutkast till LinkedIn. Flera av dessa delar hade fortfarande inaktiverad aktivering, ofullständig integration eller uppskjuten verifiering.
De daterade kontrollpunkterna rapporterade uttryckligen ingen commit, push eller deployment. Google-inloggning och full kundberedskap förblev overifierade. Jag hade en växande lokal implementation med användbar evidens, snarare än en lanserad plattform.
Vad saktade ner mitt långvariga Codex-mål?
Jag utökade målet till en produktroadmap
Att lägga till Google-inloggning låter som en enda funktion. Att lägga till privata kunder förändrar vilka som får åtkomst till projekt, rapporter, bakgrundsjobb och integrationer. Jag ville att den gränsen skulle gälla i hela applikationen.
Sedan lade jag till sökordsanalys, backlinks, innehållsgenerering och en mycket större katalog. En del av den förflutna tiden återspeglar nödvändigt arbete med ett brett mål. Mitt ursprungliga mål gjorde det enkelt att fortsätta öppna nästa ofärdiga område.
Verifieringsprocessen blev för repetitiv
Jag bad om källbaserade beslut, avgränsade ändringar, granskningar och uttryckliga bevis. Dessa instruktioner hjälpte till att förhindra vaga påståenden om att något var färdigt.
Men sessionen samlade på sig upprepade källkontroller, förberedelser inför granskningar och arbete med testfixturer. Min bedömning är att balansen gled för långt mot att bevisa enskilda delar innan nästa användbara flöde slutfördes.
Den 9 oktober sa jag åt det att sluta lägga så mycket tid på tester, arbeta mot slutförande och lämna ett större test till senare. Det tog inte bort behovet av att verifiera kontoisolering. Det ändrade ordningsföljden: fokuserade kontroller under implementationen, följt av bredare validering av det sammansatta flödet.
Vissa fel hörde till testuppsättningen
Ett försök med lösenordsåterställning i databasen misslyckades eftersom en syntetisk kontopost saknade ett obligatoriskt fält för visningsnamn. Att reparera den fixturen var nödvändigt för att köra testet, men det var ingen ny produktfunktion.
Ett senare långvarigt databasförsök avslutades när arbetsstationen startade om. Leveransloggen hävdade inte att försöket hade lyckats. En efterföljande diagnos visade upprepade beräkningar av tidigare verifieringskontrakt och buffrad förloppsutdata, vilket gjorde den pågående processen svårare att bedöma.
De här detaljerna spelar roll eftersom väntan är tvetydig. En aktiv process kan arbeta, beräkna samma förutsättning igen eller producera utdata som jag ännu inte kan se. Timern ensam kan inte berätta vilket.
Fler agenter ökade samordningen
Parallellt arbete hjälpte till med separerbara uppgifter. Huvudsessionen behövde fortfarande granska resultaten, lösa beroenden och införliva ändringarna i en enda applikation. Jag kan inte tillskriva en hastighetsökning till fler agenter eftersom jag inte körde samma projekt med och utan dem.
Den praktiska frågan blev om ytterligare en agent kunde slutföra en oberoende del eller skulle skapa ännu en överlämning till huvudsessionen.
Vad jag fortfarande gör som människa
Jag väljer produktens riktning och avgör vilka funktioner som är viktigast härnäst. Jag kontrollerar om den rapporterade utvecklingen beskriver fungerande beteende, lokal källkod eller ett overifierat förslag. Jag pausar arbetet när jag behöver uppdatera Codex eller starta om datorn och ber det sedan fortsätta från sitt sparade tillstånd.
Jag ifrågasätter också tempot. Under det här bygget gjorde jag följande:
Planen och leveransloggen ger mig något att granska utöver chattmeddelanden. De kräver också disciplin: en daterad kontrollpunkt är bara användbar om den säger vad som ändrades och vad som fortfarande är obevisat.
Erfarenheten fortsätter den avvägning jag beskrev i Jag trodde att AI skulle ge mig mer fritid→. Jag kan försöka genomföra ett större bygge, men jag lägger fortfarande tid på att avgöra vad som förtjänar att byggas och kontrollera resultatet.
Fördelarna och nackdelarna hittills
Enligt min erfarenhet av det här bygget är den största fördelen kontinuitet. Jag kan hålla ett omfattande mål öppet och återuppta det efter avbrott. Codex har producerat lokala implementationer, undersökt fel och upprätthållit detaljerade register som hjälper mig att granska arbetet.
Det kan också hantera flera typer av arbete inom samma projekt: databasändringar, API-beteende, frontend-flöden, integrationstransporter och dokumentation. Det gör ett brett bygge möjligt för mig att styra.
Nackdelen är att aktivitet kan se ut som framsteg. Många lyckade kontroller kan samexistera med en ofärdig produkt. Hög resonemangsansträngning och fler agenter medför budget- och samordningsval utan att garantera snabbare leverans.
Långa körningar gör det också svårare att hålla omfattningen i schack. En delvis genomförd roadmap ger agenten många försvarbara nästa steg. Jag måste avgöra vilket av dem som levererar nästa användbara resultat.
Jag skulle använda ett bestående mål igen, men jag skulle ge varje implementationsfas ett mindre acceptansmål. Till exempel: skapa ett konto, logga in, se den privata arbetsytan och avvisa åtkomst från ett andra konto. Behåll den större roadmapen som kontext, slutför det flödet och gå sedan vidare.
Vad jag kommer att mäta härnäst
SEO-produkten är fortfarande under utveckling och hade inte lanserats den 9 oktober. Nästa användbara mätning är ett komplett användarflöde mot den nu sammansatta applikationen, med återstående blockerare uttryckligen listade.
Därefter vill jag ha evidens för Google-inloggning, kundbundna integrationer, personliga MCP-nycklar och en säker release. Codex fortsätter att arbeta sig igenom uppgifter; den här artikeln dokumenterar ögonblicksbilden från den 9 oktober. Jag kommer att bedöma bygget utifrån dessa resultat, inte utifrån hur länge målet förblir öppet.
Källor och begränsningarna i denna redogörelse
Timern kommer från min skärmbild ovan. Modellidentifieraren, ändringarna av inställningarna och mina ingripanden kommer från huvudsessionens historik. Omfattningen och framstegssiffrorna kommer från projektplanen och dess daterade leveranslogg. Dessa projektregister är privata arbetsdokument; jag har inte publicerat loggarna eller kunddata.
OpenAI:s Using Goals in Codex förklarar arbetsflödet med bestående mål. Det stöder beskrivningen av Goals, inte leveranspåståendena om mitt projekt.
Antalet 69 punkter är en bred ögonblicksbild av acceptans, inte ett mått på återstående timmar. Skärmbilden bevisar inte oavbruten inferens, ändringarna av inställningarna bevisar inte kostnadsbesparingar och lokala kontroller fastställer inte produktionsberedskap. Det här bygget pågår fortfarande.
*Den här artikeln utarbetades med AI-hjälp från min skärmbild, sessionens historik och projektets leveransregister. Den beskriver ett pågående bygge. Den fastställer ingen allmän gräns för Codex-körtid, ingen modellrankning, ingen granskad kostnad och ingen produktionsberedskap.*