GPT-6.1 Sol chamou minha atenção porque quero executar mais trabalho útil de agentes sem tratar cada tarefa como uma despesa de modelo premium. A questão interessante é quanto trabalho correto e revisável consigo obter dentro do orçamento.
Minha primeira impressão: Sol merece um lugar na conversa sobre modelos para uso diário. Claude Opus 5.5 ainda merece uma comparação séria, especialmente quando a qualidade importa mais do que o tempo até a primeira resposta. Vou testar ambos em trabalho real. Por enquanto, estou separando benchmarks publicados, relatos iniciais de usuários e minhas próprias expectativas.
*Verificação das fontes: 29 de setembro de 2026. A imagem principal é uma ilustração editorial gerada por AI. Desenhei os gráficos de dados a partir dos valores publicados citados; eles não são capturas de tela dos meus próprios testes.*
Para que GPT-6.1 Sol é bom?
A OpenAI posiciona o GPT-6.1 Sol para programação complexa, uso de computador e trabalho profissional, buscando algo mais próximo do Astra por um preço menor. Seu ID de modelo na API é gpt-6.1-sol, com uma janela de contexto de 1.050.000 tokens e até 128.000 tokens de saída. Consulte a documentação oficial do modelo GPT-6.1 Sol.
Para o meu trabalho, isso sugere três bons pontos de partida:
Esses são candidatos para avaliação, não promessas de que o modelo lidará com eles sem supervisão. Eu ainda manteria as gravações em produção atrás de uma aprovação e exigiria que o agente mostrasse suas evidências.
Isso segue a mesma pergunta prática da minha análise do GPT-6 Astra: o modelo ajuda a concluir o trabalho depois que se integra a um sistema existente?
Preço do GPT-6.1 Sol vs Claude Opus 5.5
A comparação padrão da API é simples. Estes são preços em USD por milhão de tokens, antes de ferramentas, gravações de cache, adicionais de velocidade ou modificadores regionais.
| Tipo de token | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| Entrada | $2.00 | $4.00 |
| Entrada em cache | $0.10 | $0.20 |
| Saída | $10.00 | $20.00 |
Fontes: preços da API da OpenAI e preços da Claude Platform.
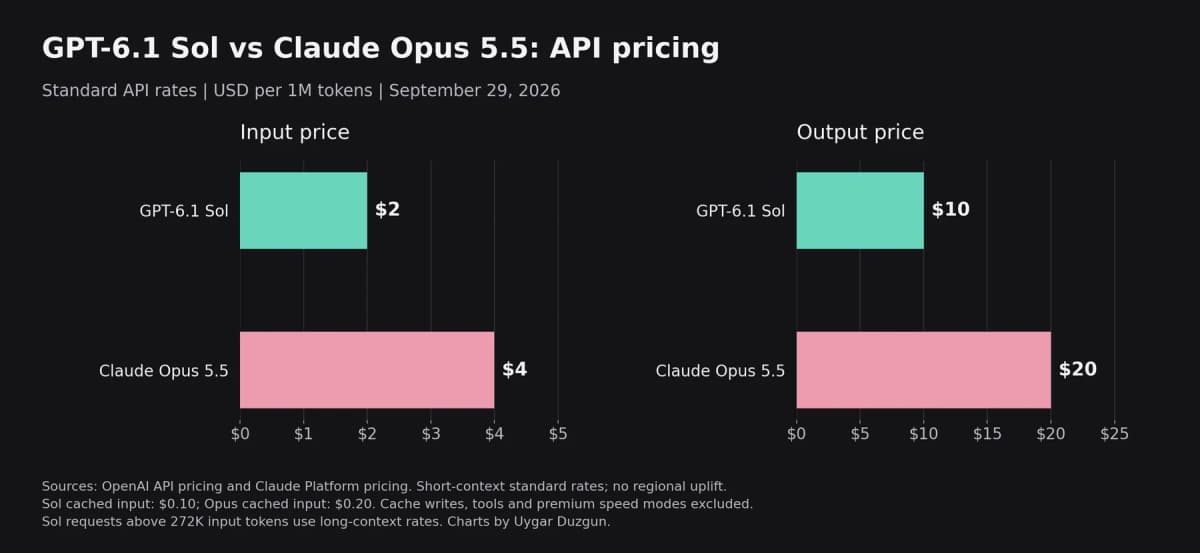
*Tarifas padrão para contextos curtos. A tabela inclui leituras em cache; o gráfico mostra os preços comuns de entrada e saída.*
Sol custa metade por token nessas categorias. Isso não significa que cada tarefa concluída custará metade. Os modelos podem usar quantidades diferentes de raciocínio, chamar ferramentas diferentes e precisar de números diferentes de novas tentativas.
O contexto longo também muda a comparação. Sol aplica tarifas mais altas à solicitação inteira acima de 272.000 tokens de entrada em um único prompt: o dobro da tarifa de entrada e de entrada em cache, e 1,5 vez a tarifa de saída. A Anthropic lista preços padrão para toda a janela de contexto do Opus 5.5. O contador agregado de tokens de uma sessão longa não é a mesma coisa que um prompt ultrapassar esse limite.
Para obter contexto sobre o lançamento anterior, minha visão geral do GPT-6 Sol e Luna aborda a linha anterior.
Benchmarks do GPT-6.1 Sol: pontuação e custo juntos
AutomationBench: Sol é mais barato; Opus alcança uma pontuação maior no máximo
O AutomationBench 1.0.6 testa fluxos de trabalho empresariais de ponta a ponta em 47 ferramentas. A Zapier avalia o estado resultante com verificações determinísticas, em vez de pedir a outro modelo de linguagem que julgue a resposta.
| Configuração | Pontuação | USD por tarefa tentada |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1, médio | 31.7% | $0.19 |
| Opus 5.5, médio, fallbacks padrão | 29.5% | $0.65 |
| Sol 6.1, máximo | 36.1% | $0.30 |
| Opus 5.5, máximo, fallbacks padrão | 42.5% | $1.44 |
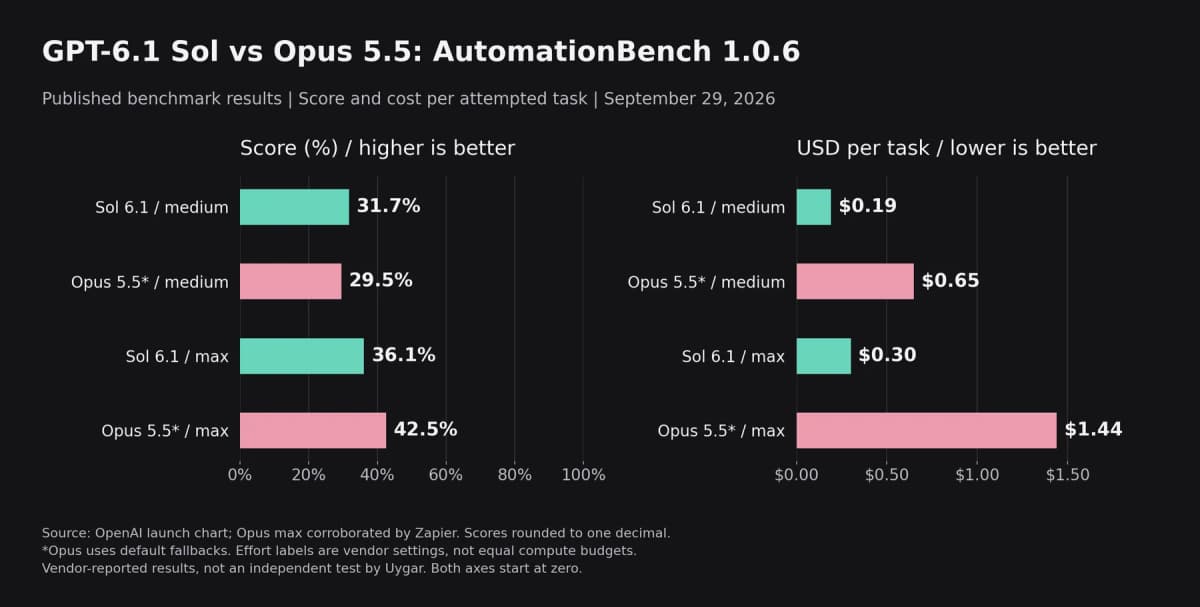
*Valores dos gráficos de lançamento da OpenAI, com pontuações arredondadas para uma casa decimal. A Zapier corrobora o resultado máximo do Opus. A configuração do Opus inclui fallbacks padrão; os rótulos de esforço dos fornecedores não representam orçamentos de computação iguais.*
No nível médio, Sol oferece uma vantagem modesta de pontuação e um custo por tarefa relatado menor. No máximo, Opus tem a pontuação mais alta. Eu escolheria entre essas compensações usando o custo da falha do fluxo de trabalho, incluindo o tempo que alguém gasta verificando o resultado.
Esses custos abrangem tarefas tentadas, incluindo falhas. Não são preços para um resultado empresarial bem-sucedido garantido.
DeepSWE: uma melhoria útil em relação ao Sol anterior
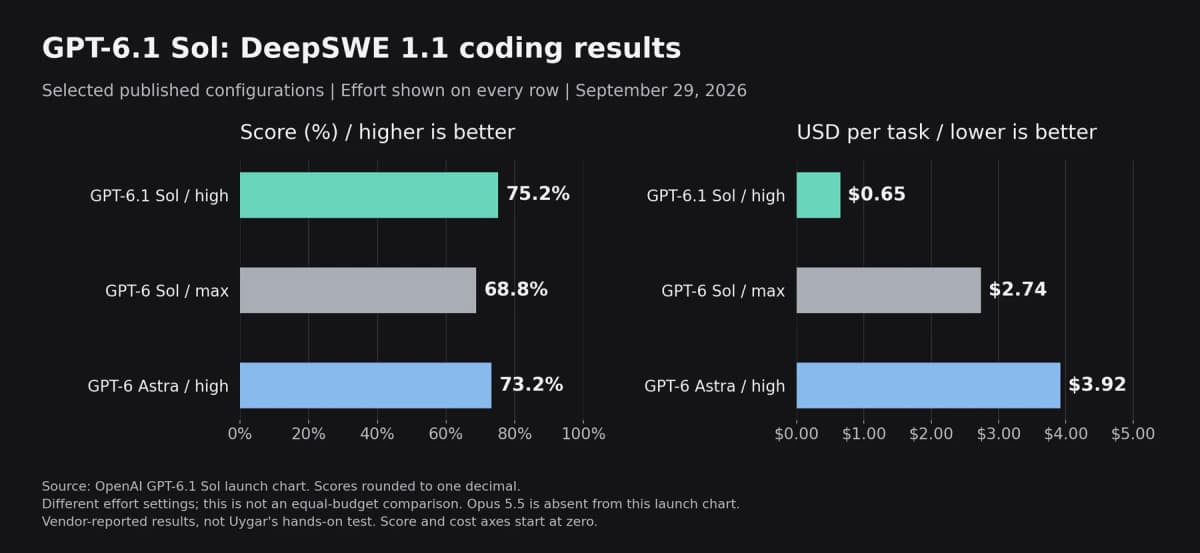
*Valores selecionados do DeepSWE 1.1 nos mesmos gráficos de lançamento da OpenAI: Sol 6.1 alto, 75.2% a $0.65; Sol anterior máximo, 68.8% a $2.74; Astra alto, 73.2% a $3.92 por tarefa. As diferentes configurações de esforço estão explícitas.*
O benchmark DeepSWE usa tarefas de repositório de longo horizonte e verificadores comportamentais. A OpenAI não inclui o Opus 5.5 neste gráfico de lançamento. Não vou colocar uma pontuação não relacionada do FrontierCode ao lado dele e fingir que medem a mesma coisa.
A OpenAI combina suas próprias avaliações com resultados de concorrentes divulgados publicamente. Trate isso como evidência publicada, não como uma execução independente frente a frente feita por mim.
Onde Claude Opus 5.5 ainda importa
A Anthropic posiciona o Opus 5.5 para programação e trabalho de conhecimento de longa duração. Seu relatório de lançamento apresenta uma pontuação de 54.6% no FrontierCode v1.1 Main com esforço médio padrão e descreve ganhos em programação com vários arquivos. Esses resultados usam um benchmark diferente do DeepSWE. A Anthropic também inclui feedback inicial de parceiros sobre menos etapas e tokens, que continua sendo um feedback atribuído, e não uma comparação controlada com o Sol 6.1. Consulte o anúncio do Opus 5.5.
Eu manteria o Opus na comparação para mudanças difíceis, revisão e trabalho visual em que uma nova passagem poderia melhorar o resultado final. Eu testaria essa hipótese, em vez de atribuir ao modelo um papel permanente de especialista com base na semana de lançamento.
Minha análise sobre benchmarks e reações ao Claude Opus 5.5 aborda seu lançamento em mais detalhes.
O que outros usuários estão dizendo?
As primeiras reações são variadas. Em uma discussão sobre o lançamento no Reddit, alguns usuários comemoraram leituras em cache mais baratas; outros questionaram o quanto o modelo se aproximaria do Astra e preferiram o Claude. Essas são reações individuais, não uma pesquisa representativa.
Outro teste mais concreto com três modelos, feito pela digitalml, usou o mesmo prompt de uma cena cinematográfica em Three.js com esforço médio. Os tempos relatados foram de 8 minutos e 42 segundos para o Sol 6.1, 9 minutos e 37 segundos para o Astra e 38 minutos e 54 segundos para o Opus 5.5. O autor preferiu o resultado cinematográfico do Opus e relatou problemas de câmera e som na versão do Sol.
Esse único exemplo captura uma compensação que vale a pena investigar: terminar primeiro pode ser importante, mas o acabamento e o comportamento depois que a página carrega também podem ser. Isso não estabelece uma classificação geral de velocidade ou qualidade.
Como vou testar o GPT-6.1 Sol
Vou dar ao Sol e ao Opus a mesma tarefa, os mesmos arquivos iniciais, acesso às mesmas ferramentas e as mesmas verificações de aceitação. Quero registrar correção, tempo decorrido, novas tentativas, custo em tokens e o trabalho de revisão que ainda preciso fazer. Uma resposta rápida que me deixa corrigindo regressões não é um resultado barato.
Para integrações de API, Sol exige a Responses API para chamadas de ferramentas; Chat Completions oferece suporte sem ferramentas. Ele aceita níveis de esforço de raciocínio low, medium, high, xhigh e max, com medium como padrão. A documentação do modelo acima define essas restrições.
Meu ponto de partida prático é medium, um briefing delimitado e verificações executáveis. Vou aumentar o esforço quando uma tarefa exigir isso e então comparar o resultado. Mais raciocínio deve justificar o tempo e o custo adicionais.
Estou animado para experimentar o GPT-6.1 Sol porque a relação preço-desempenho publicada parece útil para trabalho repetido de agentes. Opus 5.5 continua sendo uma alternativa forte. Vou decidir onde cada um se encaixa depois de obter evidências nas tarefas que preciso concluir.