Minha meta de longa duração no Codex: quatro dias e ainda trabalhando
Em 9 de outubro de 2026, minha meta de longa duração no Codex mostrava 4 dias, 14 horas, 8 minutos e 22 segundos. Fiz uma captura de tela enquanto o Codex ainda trabalhava em um produto de SEO que ainda não lancei. A meta continuava aberta, com mais tarefas a concluir.
Eu havia pedido que ele concluísse todo o plano do produto de SEO ainda não lançado que estou desenvolvendo. Até aquele momento, também havia pedido que usasse mais agentes, reduzisse o esforço de raciocínio, pausasse para atualizações, retomasse após uma reinicialização e passasse menos tempo repetindo testes.
Este é meu relato sobre uma meta de longa duração no Codex: o trabalho que ela produziu, o trabalho que a tornou mais lenta e as decisões que eu ainda precisava tomar. É uma construção inacabada, não um benchmark nem um anúncio de lançamento.
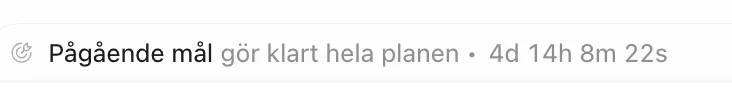
O cronômetro acima pertence à meta. Ele não comprova quatro dias de computação ininterrupta do modelo. Minha sessão inclui pausas e retomadas explícitas, uma atualização do aplicativo, uma reinicialização do computador, execução de ferramentas e espera.
O que pedi ao Codex para construir
A conversa começou em 3 de outubro com uma pergunta menor: os usuários têm suas próprias credenciais de login, podem entrar com o Google e gerar chaves MCP pessoais?
Depois, ampliei os requisitos. Cada usuário deveria ver seus próprios projetos. Os usuários deveriam poder convidar pessoas para um workspace. Eu queria configurações para preferências pessoais e concorrência do crawler. A plataforma seria comercial no futuro, com um lançamento inicial gratuito.
Forneci um catálogo muito maior de produtos de SEO para orientar a construção. O plano resultante abrangia 15 áreas de produto, 42 referências de aplicativos e 19 ferramentas públicas gratuitas, além de um recurso de classificação de tráfego de sites. Ele incluía SEO técnico, pesquisa de palavras-chave, rankings, backlinks, visibilidade em AI, conteúdo, analytics, SEO local e recursos empresariais posteriores.
Também queria que o produto encomendasse artigos do mecanismo de conteúdo por trás do meu próprio site.
Portanto, a instrução para concluir todo o plano se referia a um roadmap de produto substancial. Eu ajudei a criar esse escopo. Um cronômetro de quatro dias em uma pequena correção de bug contaria uma história diferente.
Qual modelo e quais configurações usei
O registro principal da sessão identifica o modelo como GPT-6.1 Sol, com o identificador gpt-6.1-sol. Seus turnos registrados incluem configurações de raciocínio ultra, média e um pequeno número de alta. Isso identifica a sessão principal; não estabelece o modelo por trás de cada revisor ou ferramenta externa.
Em 5 de outubro, mudei explicitamente o esforço para médio para economizar tokens. Em seguida, desativei o turbo pelo mesmo motivo. Essas eram minhas intenções, não economias medidas: não tenho uma comparação de custos auditada para as duas configurações.
Também solicitei mais agentes paralelos. A sessão usou trabalho delegado e revisões de pares feitas pelo Claude para partes da implementação. Isso permitiu que tarefas separadas avançassem, mas também criou trabalho para reconciliar os resultados e verificar o resultado combinado.
Minha comparação anterior entre GPT-6.1 Sol e Opus 5.5→ aborda dados publicados sobre modelos. Esta construção é um tipo diferente de evidência: um projeto real com escopo e configurações variáveis, em vez de uma comparação controlada entre modelos.
Por quanto tempo uma meta do Codex pode continuar trabalhando?
Neste caso, a interface exibiu mais de quatro dias para a mesma meta em andamento. Essa é a observação que posso sustentar. Não é uma garantia de tempo máximo de execução, e não consigo calcular o tempo de inferência ativo a partir da captura de tela.
A OpenAI descreve Goals no Codex como objetivos que persistem entre turnos. O Codex pode continuar trabalhando em direção a um resultado, enquanto o usuário pode pausá-lo ou retomá-lo. Conclusão, interrupções, orçamentos e bloqueios afetam a continuidade do trabalho.
Minha experiência se encaixa nesse fluxo de trabalho persistente. Eu podia retornar ao mesmo objetivo após pausas e orientar o trabalho seguinte. Manter o objetivo disponível foi útil. Isso não tornou o objetivo menor nem garantiu que cada novo turno aproximasse o produto do lançamento.
O que havia sido entregue até 9 de outubro?
O registro de entregas de 9 de outubro contabilizava 30 requisitos parcialmente concluídos, 39 não avaliados e zero requisitos totalmente aceitos em uma lista de acompanhamento com 69 itens.
Essa contagem precisa de contexto. A lista mede a aceitação ampla do produto. Zero requisitos totalmente aceitos não significa código funcional zero. Da mesma forma, 30 requisitos parciais não significam que o produto esteja 43% concluído.
O registro documenta um smoke test local descartável de uma linha de base de conta compatível: criar a primeira conta, entrar com uma senha, ler a sessão e seu workspace privado do proprietário, depois sair e rejeitar a sessão antiga. Esse é um fluxo de usuário concreto com um resultado de teste delimitado. Não é prova de que o aplicativo completo mais recente esteja pronto para clientes.
Outros avanços incluíram a integração local do código-fonte de redefinição de senha, rascunhos de revisão de backlinks, trabalho em relatórios salvos do Search Console, transporte de relatórios do GA4 com token do cliente e trabalho em rascunhos de artigos para o LinkedIn. Várias dessas partes ainda tinham ativação desabilitada, integração incompleta ou verificação adiada.
Os checkpoints datados informavam explicitamente que não havia commit, push ou deployment. O login com o Google e a prontidão completa para clientes continuavam sem verificação. Eu tinha uma implementação local crescente, com evidências úteis, e não uma plataforma lançada.
O que tornou minha meta de longa duração no Codex mais lenta?
Transformei a meta em um roadmap de produto
Adicionar o login com o Google parece um único recurso. Adicionar clientes privados muda quem pode acessar projetos, relatórios, tarefas em segundo plano e integrações. Eu queria que esse limite fosse respeitado em todo o aplicativo.
Depois, adicionei pesquisa de palavras-chave, backlinks, geração de conteúdo e um catálogo muito maior. Parte do tempo decorrido reflete o trabalho necessário em um objetivo amplo. Minha meta original facilitava continuar abrindo a próxima área inacabada.
O processo de verificação ficou repetitivo demais
Pedi decisões baseadas em fontes, mudanças restritas, revisões e evidências explícitas. Essas instruções ajudaram a evitar afirmações vagas de que algo estava concluído.
Mas a sessão acumulou verificações repetidas de fontes, preparação de revisões e trabalho em fixtures de teste. Meu julgamento é que o equilíbrio se inclinou demais para provar partes individuais antes de concluir o próximo fluxo utilizável.
Em 9 de outubro, pedi que ele parasse de gastar tanto tempo com testes, trabalhasse em direção à conclusão e deixasse um teste maior para depois. Isso não eliminou a necessidade de verificar o isolamento de contas. Mudou a sequência: verificações focadas durante a implementação, seguidas de uma validação mais ampla do fluxo montado.
Algumas falhas pertenciam à configuração dos testes
Uma tentativa de banco de dados para redefinição de senha falhou porque um registro de conta sintético omitiu um campo obrigatório de nome de exibição. Corrigir essa fixture foi necessário para executar o teste, mas não era um novo recurso do produto.
Uma tentativa posterior e longa no banco de dados terminou quando a estação de trabalho foi reiniciada. O registro de entregas não afirmou que essa tentativa havia passado. O diagnóstico posterior encontrou a computação repetida de contratos de verificação anteriores e a saída de progresso armazenada em buffer, o que tornou mais difícil avaliar o processo em execução.
Esses detalhes importam porque esperar é ambíguo. Um processo ativo pode estar trabalhando, recalculando o mesmo pré-requisito ou produzindo uma saída que ainda não consigo ver. O cronômetro, sozinho, não pode me dizer qual dessas situações está ocorrendo.
Mais agentes adicionaram coordenação
O trabalho paralelo ajudou em tarefas separáveis. A sessão principal ainda precisava inspecionar os resultados, resolver dependências e incorporar as mudanças em um único aplicativo. Não posso atribuir um ganho de velocidade à adição de agentes porque não executei o mesmo projeto com e sem eles.
A questão prática passou a ser se outro agente poderia concluir uma parte independente ou se criaria outra transferência de trabalho para a sessão principal.
O que ainda faço como humano
Eu escolho a direção do produto e decido quais recursos importam em seguida. Verifico se o progresso relatado descreve comportamento funcional, código-fonte local ou uma proposta não verificada. Pauso o trabalho quando preciso atualizar o Codex ou reiniciar o computador e, depois, peço que ele continue a partir do estado salvo.
Também questiono o ritmo. Durante esta construção, eu:
O plano e o registro de entregas me dão algo para inspecionar além das mensagens do chat. Eles também exigem disciplina: um checkpoint datado só é útil se disser o que mudou e o que continua sem comprovação.
A experiência dá continuidade ao trade-off que descrevi em Achei que a AI me daria mais tempo livre→. Posso tentar uma construção maior, mas ainda passo tempo decidindo o que merece ser construído e verificando o resultado.
As vantagens e desvantagens até agora
Na minha experiência com esta construção, a maior vantagem é a continuidade. Posso manter um objetivo substancial aberto e retomá-lo após interrupções. O Codex produziu implementações locais, investigou falhas e manteve registros detalhados que me ajudam a revisar o trabalho.
Ele também consegue lidar com vários tipos de trabalho dentro do mesmo projeto: mudanças no banco de dados, comportamento de API, fluxos de frontend, transportes de integração e documentação. Isso torna possível, para mim, orientar uma construção ampla.
A desvantagem é que atividade pode parecer progresso. Muitas verificações bem-sucedidas podem coexistir com um produto inacabado. Um esforço de raciocínio alto e mais agentes introduzem decisões de orçamento e coordenação sem garantir uma entrega mais rápida.
Execuções longas também tornam mais difícil manter a disciplina de escopo. Um roadmap parcialmente concluído oferece ao agente muitas próximas ações defensáveis. Preciso decidir qual delas entrega o próximo resultado útil.
Eu usaria uma meta persistente novamente, mas daria a cada etapa de implementação um objetivo de aceitação menor. Por exemplo: criar uma conta, entrar, ver seu workspace privado e rejeitar o acesso de uma segunda conta. Manter o roadmap maior como contexto, concluir esse fluxo e só então avançar.
O que vou medir em seguida
O produto de SEO ainda está em desenvolvimento e não havia sido lançado até 9 de outubro. A próxima medida útil é um fluxo de usuário completo contra o aplicativo atualmente montado, com seus bloqueadores restantes listados explicitamente.
Depois disso, quero evidências para login com o Google, integrações vinculadas ao cliente, chaves MCP pessoais e uma versão segura. O Codex continua trabalhando nas tarefas; este artigo registra o retrato de 9 de outubro. Vou avaliar a construção por esses resultados, e não pelo tempo que a meta permanece aberta.
Fontes e limites deste relato
O cronômetro vem da captura de tela acima. O identificador do modelo, as mudanças nas configurações e minhas intervenções vêm do histórico da sessão principal. O escopo e as contagens de progresso vêm do plano do projeto e de seu registro de entregas datado. Esses registros do projeto são documentos privados de trabalho; não publiquei os logs nem os dados dos clientes.
A documentação da OpenAI sobre o uso de Goals no Codex explica o fluxo de trabalho com objetivos persistentes. Ela sustenta a descrição de Goals, não as afirmações sobre as entregas do meu projeto.
A contagem de 69 itens é um retrato amplo de aceitação, não uma medida das horas restantes. A captura de tela não comprova inferência ininterrupta, as mudanças de configuração não comprovam economia de custos e as verificações locais não estabelecem prontidão para produção. Esta construção ainda está em andamento.
*Este artigo foi redigido com assistência de AI a partir da minha captura de tela, do histórico da sessão e dos registros de entregas do projeto. Ele descreve uma única construção em andamento. Não estabelece um limite geral de tempo de execução do Codex, um ranking de modelos, um custo auditado ou prontidão para produção.*