GPT-6.1 Sol に注目しているのは、すべてのタスクをプレミアムモデル向けの出費として扱わずに、より有用なエージェント作業を実行したいからです。重要なのは、予算内でどれだけ正確で、レビュー可能な作業を得られるかです。
私の第一印象では、Sol は日常的に使うモデルの候補に入る価値があります。特に最初の応答速度より品質が重要な場合、Claude Opus 5.5 も真剣に比較する価値があります。両方を実際の作業でテストする予定です。現時点では、公開済みのベンチマーク、初期ユーザーの報告、そして私自身の予想を分けて考えています。
*情報確認日:2026年9月29日。ヒーロー画像は AI で生成した編集用イラストです。データチャートは引用した公開値をもとに私が作成したもので、私自身のテストのスクリーンショットではありません。*
GPT-6.1 Sol は何に向いているのか?
OpenAI は GPT-6.1 Sol を、複雑なコーディング、コンピューター操作、専門的な作業向けに位置づけており、より低い価格で Astra に近い性能を目指しています。API のモデル ID は gpt-6.1-sol で、コンテキストウィンドウは 1,050,000 トークン、最大出力は 128,000 トークンです。GPT-6.1 Sol の公式モデルドキュメントを参照してください。
私の作業では、まず次の3つの用途から始めるのが有効そうです。
これらは評価候補であり、モデルが人の監督なしに処理できるという約束ではありません。本番環境への書き込みは引き続き承認制にし、エージェントには根拠を提示させたいと考えています。
これは、私の GPT-6 Astra レビューと同じ実践的な問いにつながります。既存のシステムに接続したとき、モデルは作業の完了を助けてくれるのでしょうか。
GPT-6.1 Sol と Claude Opus 5.5 の価格比較
標準的な API 比較はシンプルです。以下は、ツール、キャッシュ書き込み、速度プレミアム、地域別の調整を含まない、100万トークンあたりの USD 価格です。
| トークン種別 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| 入力 | $2.00 | $4.00 |
| キャッシュ入力 | $0.10 | $0.20 |
| 出力 | $10.00 | $20.00 |
出典:OpenAI API の料金および Claude Platform の料金。
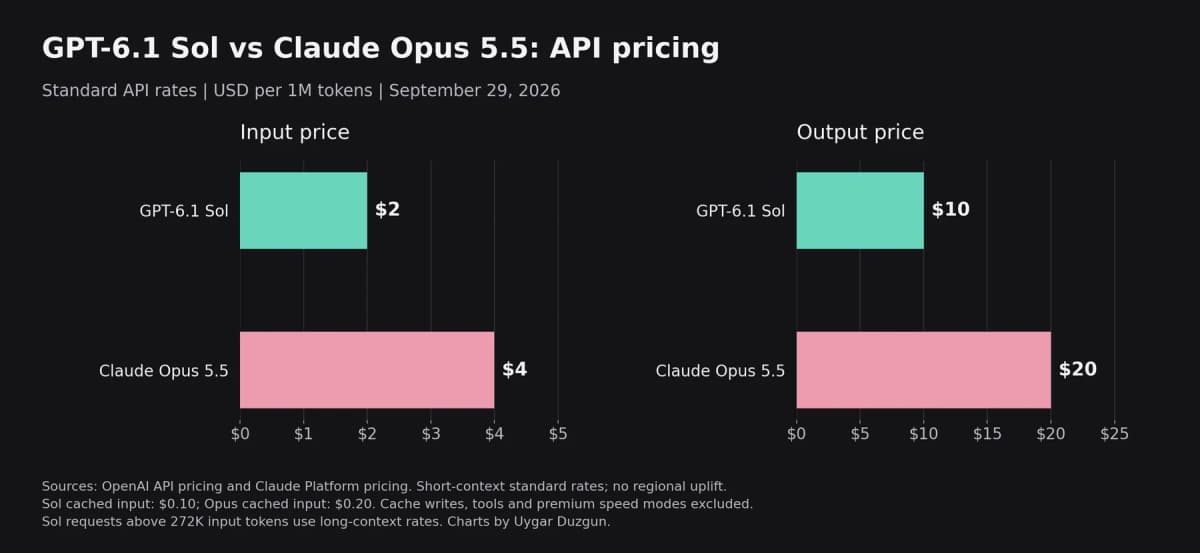
*標準的な短いコンテキストでの料金です。表にはキャッシュされた読み取りが含まれますが、グラフには通常の入力価格と出力価格を示しています。*
これらのカテゴリでは、Sol のトークン単価は半分です。ただし、完了したすべてのジョブのコストが半分になるわけではありません。モデルによって推論に使う量、呼び出すツール、必要な再試行回数が異なる可能性があります。
長いコンテキストでは比較が変わります。Sol は、1つのプロンプトで入力トークンが 272,000 を超える場合、リクエスト全体に対して高い料金を適用します。入力とキャッシュ入力の料金は2倍、出力料金は1.5倍です。Anthropic は Opus 5.5 のコンテキストウィンドウ全体に標準料金を掲載しています。長時間実行されるセッションの累計トークン数は、1つのプロンプトがそのしきい値を超えることとは別のものです。
以前のリリースについては、私の GPT-6 Sol と Luna の概要で、前世代のラインナップを解説しています。
GPT-6.1 Sol のベンチマーク:スコアとコストを合わせて見る
AutomationBench:Sol は安価、Opus は最大設定でより高いスコア
AutomationBench 1.0.6 は、47種類のツールにまたがるエンドツーエンドのビジネスワークフローをテストします。Zapier は、別の言語モデルに回答の判定を依頼するのではなく、決定論的なチェックによって最終状態を採点します。
| 構成 | スコア | 試行タスクあたりの USD |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1、medium | 31.7% | $0.19 |
| Opus 5.5、medium、デフォルトのフォールバック | 29.5% | $0.65 |
| Sol 6.1、max | 36.1% | $0.30 |
| Opus 5.5、max、デフォルトのフォールバック | 42.5% | $1.44 |
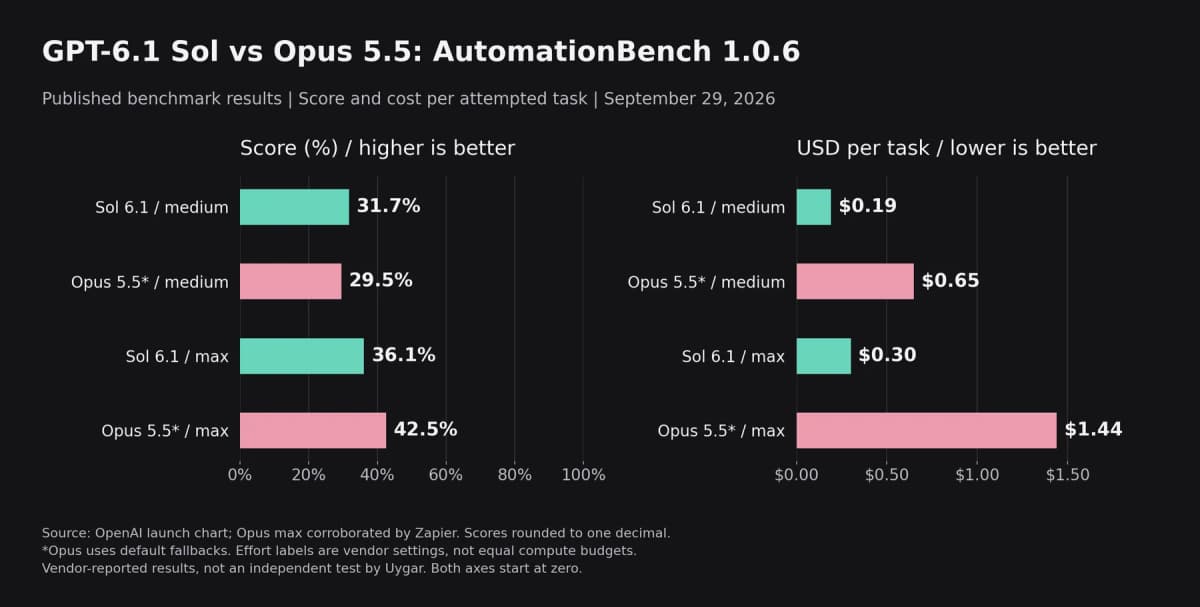
*数値は OpenAI のローンチチャートから取得し、スコアは小数第1位に丸めています。Opus の max の結果は Zapier も裏付けています。Opus の構成にはデフォルトのフォールバックが含まれます。各ベンダーの effort ラベルは、同じ計算予算を表すものではありません。*
medium では、Sol がわずかに高いスコアと、より低い報告タスクコストを示しています。max では Opus のスコアが上回ります。私は、ワークフローの失敗コスト、そこには誰かが結果を確認する時間も含めて、こうしたトレードオフを判断したいと考えています。
これらのコストは、失敗を含む試行タスクを対象としています。成功が保証されたビジネス成果の価格ではありません。
DeepSWE:以前の Sol から有用なアップグレード
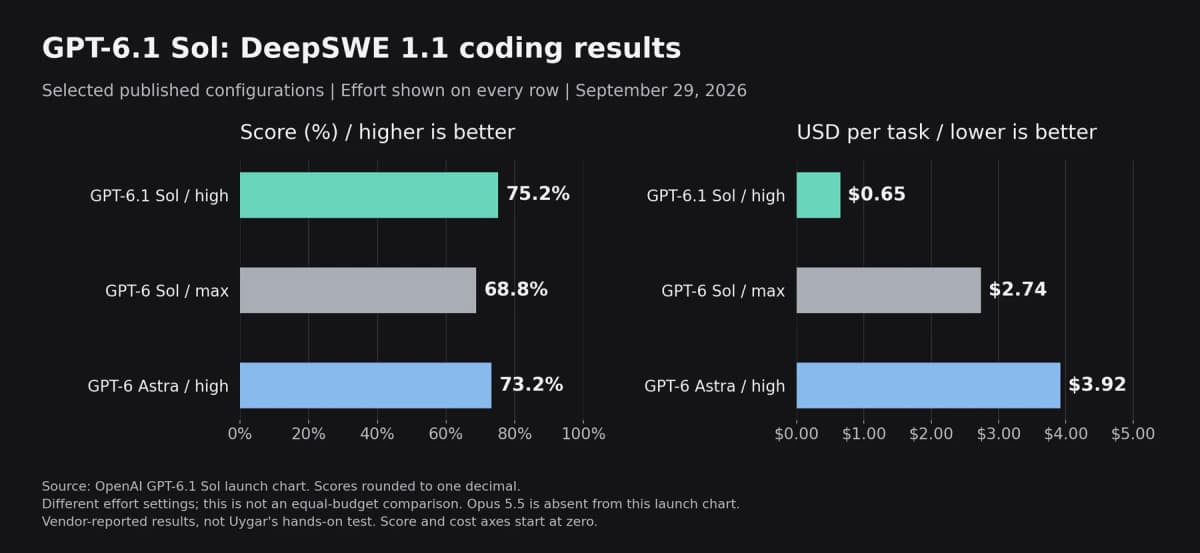
*同じ OpenAI ローンチチャートから選んだ DeepSWE 1.1 の数値:Sol 6.1 high は 75.2%、$0.65。以前の Sol max は 68.8%、$2.74。Astra high は 73.2%、タスクあたり $3.92。異なる effort 設定を明示しています。*
DeepSWE ベンチマークは、長時間にわたるリポジトリタスクと行動検証器を使用します。OpenAI はこのローンチチャートに Opus 5.5 を含めていません。関連性のない FrontierCode のスコアを横に並べ、同じものを測定しているかのように見せることはしません。
OpenAI は、自社の評価と公開されている競合モデルの結果を組み合わせています。これは公開された証拠として扱うべきであり、私が独自に実施した直接対決テストではありません。
Claude Opus 5.5 が依然として重要な場面
Anthropic は Opus 5.5 を、長時間にわたるコーディングと知識作業向けに位置づけています。ローンチレポートでは、デフォルトの medium effort における FrontierCode v1.1 Main のスコア 54.6% を示し、複数ファイルのコーディングで向上したと説明しています。これらの結果は DeepSWE とは異なるベンチマークを使用しています。Anthropic は、手順数とトークン数の削減に関する初期パートナーからのフィードバックも掲載していますが、これは Sol 6.1 との管理された比較ではなく、あくまで帰属付きのフィードバックです。Opus 5.5 の発表を参照してください。
私は、難しい変更、レビュー、そしてもう一度処理することで最終結果が改善する可能性のあるビジュアル作業では、Opus を比較対象に残したいと考えています。ローンチ週の印象だけでモデルに恒久的な専門家の役割を与えるのではなく、その仮説をテストするつもりです。
私の Claude Opus 5.5 のベンチマークと反応では、リリースについてさらに詳しく解説しています。
他のユーザーは何と言っているのか?
初期の反応は分かれています。Reddit のローンチに関する議論では、安価なキャッシュ読み取りを歓迎するユーザーがいる一方、モデルが Astra にどれほど近い感覚になるのかを疑問視し、Claude を好むユーザーもいました。これらは個人の反応であり、代表性のある調査ではありません。
もう1つ具体的な例として、digitalml による3モデルのテストでは、同じ映画的な Three.js シーンのプロンプトを medium effort で使用しています。報告された所要時間は、Sol 6.1 が8分42秒、Astra が9分37秒、Opus 5.5 が38分54秒でした。作成者は Opus の映画的な結果を好み、Sol のバージョンではカメラとサウンドに問題があったと報告しています。
この1つの例は、調査する価値のあるトレードオフを捉えています。最初に完了することが重要な場合もありますが、ページの読み込み後の洗練度や挙動も重要です。ただし、一般的な速度や品質の順位を確立するものではありません。
GPT-6.1 Sol をどのようにテストするか
Sol と Opus に、同じタスク、開始ファイル、ツールアクセス、受け入れチェックを与えます。正確性、経過時間、再試行回数、トークンコスト、そして自分が引き続き行う必要のあるレビュー作業を記録したいと考えています。リグレッションの修正に時間を取られる素早い回答は、安い結果とは言えません。
API 統合では、Sol がツール呼び出しを行うには Responses API が必要です。Chat Completions はツールなしでサポートされます。low、medium、high、xhigh、max の reasoning effort に対応しており、デフォルトは medium です。上記のモデルドキュメントで、これらの制約が定義されています。
実践的な出発点は、medium、範囲を限定した brief、そして実行可能なチェックです。タスクに必要な場合は effort を引き上げ、その結果を比較します。より多くの推論には、それに見合う時間とコストを支払う価値があるべきです。
GPT-6.1 Sol を試すことに期待しているのは、公開された価格性能比が、反復的なエージェント作業に役立ちそうだからです。Opus 5.5 も依然として有力な選択肢です。どちらをどこに配置するかは、完了させる必要のあるタスクから証拠を得た後に判断します。
---