長期実行中のCodexゴール:4日経ってもまだ作業中
2026年10月9日、私の長期実行中のCodexゴールには、4日、14時間、8分、22秒と表示されていました。Codexが、まだ公開していないSEO製品の作業を続けている間にスクリーンショットを撮りました。ゴールは開いたままで、完了すべきタスクがまだ残っていました。
私は、開発中の未公開SEO製品について、計画全体を完了するよう指示していました。その時点までに、より多くのエージェントを使うこと、推論の負荷を下げること、進捗報告のために一時停止すること、再起動後に再開すること、そしてテストの繰り返しにかける時間を減らすことも依頼していました。
これは、長期実行中のCodexゴールについての私の記録です。生成された成果、作業を遅らせた要因、そして私がまだ判断しなければならなかったことをまとめています。これは未完成のビルドであり、ベンチマークでもローンチ発表でもありません。
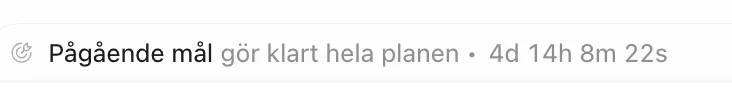
上のタイマーはゴールに紐づいています。4日間、モデルが中断なく計算を続けたことを示すものではありません。私のセッションには、明示的な一時停止と再開、アプリの更新、コンピューターの再起動、ツールの実行、待機時間が含まれています。
Codexに構築を依頼したもの
会話は10月3日、より小さな質問から始まりました。ユーザーはそれぞれ自分のログイン認証情報を持つのか、Googleでサインインできるのか、個人用のMCPキーを生成できるのか、という質問です。
その後、要件を拡張しました。各ユーザーは自分のプロジェクトを表示できる必要があります。ユーザーはワークスペースに他の人を招待できる必要があります。個人設定とクローラーの同時実行数の設定も必要でした。プラットフォームは最終的に商用化する予定ですが、初期ローンチは無料にするつもりでした。
構築の指針として、より大規模なSEO製品カタログも提供しました。結果として作成された計画には、15の製品領域、42のアプリ参照、19の一般公開された無料ツールに加え、ウェブサイトのトラフィックランキング機能が含まれていました。技術的SEO、キーワード調査、ランキング、バックリンク、AI可視性、コンテンツ、分析、ローカルSEO、そして後のエンタープライズ機能までを対象としていました。
また、自分のウェブサイトの背後にあるコンテンツエンジンから記事を発注できる製品にもしたいと考えていました。
したがって、「計画全体を完了する」という指示は、相当規模の製品ロードマップを指していました。この範囲の策定には私も関わっています。小さなバグ修正に4日間のタイマーが表示された場合とは、意味が異なります。
使用したモデルと設定
メインセッションのログでは、モデルはGPT-6.1 Sol、識別子は gpt-6.1-sol と記録されています。記録されたターンには、ultra、medium、そして少数のhigh reasoning設定が含まれています。これはメインセッションを特定するものであり、すべてのレビュアーや外部ツールの背後にあるモデルまで特定するものではありません。
10月5日、トークンを節約するため、明示的に処理負荷をmediumへ切り替えました。同じ理由でturboもオフにしました。これは私の意図であり、測定された節約量ではありません。2つの構成について、監査済みのコスト比較はありません。
また、より多くの並列エージェントを使うよう依頼しました。セッションでは、実装の一部に委任作業とClaudeによるピアレビューを使用しました。これにより別々のタスクを前進させられましたが、出力を調整し、統合された結果を検証する作業も発生しました。
以前の記事 GPT-6.1 SolとOpus 5.5の比較→では、公開されているモデルデータを扱っています。今回のビルドは別種の証拠です。モデル間の管理された比較ではなく、範囲と設定が変化する1つの実プロジェクトです。
Codexのゴールはどれくらい作業を続けられるのか?
今回、インターフェースには同じ進行中のゴールについて4日を超える時間が表示されました。私が裏付けられるのはこの観察結果です。これは最大実行時間の保証ではなく、スクリーンショットからアクティブな推論時間を計算することもできません。
OpenAIはCodexのGoalsを、ターンをまたいで持続する目的として説明しています。Codexは成果に向けて作業を続けられ、ユーザーは一時停止や再開を行えます。完了状況、中断、予算、ブロッカーによって、作業が継続するかどうかは変わります。
私の経験は、この持続的なワークフローと一致しています。一時停止した後でも同じ目的に戻り、次の作業を指示できました。目標を利用可能な状態に保てたことは便利でした。しかし、それによって目標が小さくなったわけでも、新しいターンごとに製品がローンチへ近づくことが保証されたわけでもありません。
10月9日までに何が提供されていたのか?
10月9日の納品ログには、69項目の追跡リストのうち、部分的に完了した要件が30件、未評価が39件、完全に受け入れられた要件が0件と記録されていました。
この数には文脈が必要です。このリストは、広範な製品受け入れ状況を測定しています。完全に受け入れられた要件が0件ということは、動作するコードが0行という意味ではありません。また、部分的な要件が30件あるからといって、製品が43パーセント完成したという意味でもありません。
ログには、サポート対象のアカウント基盤に対する、破棄前提のローカルスモークテストが記録されています。最初のアカウントを作成し、パスワードでログインし、セッションと非公開の所有者ワークスペースを読み込み、その後ログアウトして古いセッションを拒否するテストです。これは、範囲が限定されたテスト結果を伴う具体的なユーザーフローです。最新の完全なアプリケーションが顧客向けに準備できている証拠ではありません。
その他の進捗には、ローカルでのパスワードリセットのソース統合、バックリンクレビューの下書き、保存済みSearch Consoleレポートの作業、顧客トークンを使ったGA4レポートの転送、記事からLinkedInへの下書き作成作業が含まれていました。これらのいくつかには、まだ有効化の無効化、不完全な統合、または検証の延期が残っていました。
日付付きのチェックポイントには、コミット、プッシュ、デプロイが行われていないことが明記されていました。Googleログインと顧客向けの完全な準備状況は、依然として未検証でした。私が得たのは、有用な証拠を伴う成長中のローカル実装であり、リリース済みのプラットフォームではありません。
長期実行中のCodexゴールを遅らせたものは何か?
ゴールを製品ロードマップへ拡張した
Googleログインの追加は、1つの機能のように聞こえます。しかし、非公開の顧客を追加すると、誰がプロジェクト、レポート、バックグラウンドジョブ、統合機能にアクセスできるのかが変わります。私は、その境界がアプリケーション全体で維持されることを望みました。
その後、キーワード調査、バックリンク、コンテンツ生成、さらに大規模なカタログを追加しました。経過時間の一部は、広い目標に必要な作業を反映しています。最初のゴールによって、次の未完了領域を開き続けることが容易になりました。
検証プロセスが過度に反復的になった
私は、ソースに基づく判断、範囲を絞った変更、レビュー、明示的な証拠を求めました。これらの指示は、何かが完了したという曖昧な主張を防ぐのに役立ちました。
しかし、セッションには、ソースの再確認、レビューの準備、テスト用フィクスチャの作業が繰り返し蓄積されました。私の判断では、次の利用可能なフローを完成させる前に、個々の要素を証明することへ、バランスが傾きすぎました。
10月9日、私はテストに多くの時間を費やすのをやめ、完成に向けて作業し、より大きなテストは後回しにするよう指示しました。これによってアカウント分離の検証が不要になったわけではありません。実装中は焦点を絞ったチェックを行い、その後、組み立てたフロー全体を広く検証するという順序に変更したのです。
一部の失敗はテスト設定に起因していた
あるパスワードリセット用データベースの試行は、合成アカウントレコードに必須の表示名フィールドがなかったため失敗しました。テストを実行するにはそのフィクスチャの修正が必要でしたが、それは新しい製品機能ではありません。
その後の長時間にわたるデータベース処理は、ワークステーションが再起動したことで終了しました。納品ログには、その試行が成功したとは記載されていません。後の診断では、以前の検証契約を繰り返し計算していたことと、進捗出力がバッファリングされていたことが判明しました。そのため、実行中のプロセスを評価することが難しくなっていました。
これらの詳細が重要なのは、待機時間が曖昧だからです。稼働中のプロセスは作業をしているのかもしれませんし、同じ前提条件を再計算しているのかもしれません。また、まだ表示できない出力を生成している可能性もあります。タイマーだけでは、どれなのか判断できません。
エージェントを増やすと調整が必要になった
並列作業は、分離可能なタスクに役立ちました。それでもメインセッションでは、結果を確認し、依存関係を解決し、変更を1つのアプリケーションへ組み込む必要がありました。同じプロジェクトをエージェントありとなしで実行したわけではないため、エージェント追加による速度向上を帰属させることはできません。
実際の問題は、別のエージェントが独立した一部分を完了できるのか、それともメインセッションに別の引き継ぎ作業を生み出すだけなのか、ということでした。
人間として私が今も行っていること
製品の方向性を決め、次に重要な機能を判断するのは私です。報告された進捗が、動作する挙動を示しているのか、ローカルのソースコードを示しているのか、それとも未検証の提案なのかを確認します。Codexを更新したりコンピューターを再起動したりする必要があるときは作業を一時停止し、その後、保存された状態から続行するよう依頼します。
また、進行速度にも異議を唱えます。このビルド中、私は次のことを行いました。
計画と納品ログによって、チャットメッセージ以外にも確認できるものが得られます。ただし、そこにも規律が必要です。日付付きのチェックポイントは、何が変わり、何がまだ証明されていないのかを示している場合にのみ役立ちます。
この経験は、AIが自由時間を増やしてくれると思っていた→で説明したトレードオフを引き継いでいます。より大規模なビルドに挑戦できる一方で、何を構築する価値があるのかを決め、結果を確認するための時間は依然として必要です。
ここまでのメリットとデメリット
このビルドでの私の経験では、最大のメリットは継続性です。大きな目的を開いたままにし、中断後に再開できます。Codexはローカル実装を生成し、失敗を調査し、作業をレビューするのに役立つ詳細な記録を維持してきました。
また、同じプロジェクト内で、データベースの変更、APIの挙動、フロントエンドのフロー、統合機能の転送、ドキュメントなど、複数の種類の作業を処理できます。そのため、私が指揮する広範なビルドが可能になります。
デメリットは、活動が進捗のように見えることです。多くのチェックが成功していても、製品が未完成であることはあります。高い推論負荷とより多くのエージェントは、予算や調整に関する判断を増やしますが、より速い納品を保証するわけではありません。
長期実行では、スコープの規律を保つことも難しくなります。部分的に完了したロードマップには、エージェントが選べる、もっともらしい次のアクションが多数あります。次に役立つ結果を生むものを決める必要があるのは私です。
私は今後も永続的なゴールを使うでしょう。ただし、各実装段階には、より小さな受け入れ目標を設定します。たとえば、アカウントを作成し、ログインし、非公開のワークスペースを表示し、2つ目のアカウントからのアクセスを拒否する、といった具合です。大きなロードマップは文脈として残し、そのフローを完成させてから次へ進みます。
次に測定するもの
SEO製品はまだ開発中であり、10月9日時点ではローンチしていません。次に役立つ測定は、現在組み立てられているアプリケーションに対する完全なユーザーフローと、残っているブロッカーを明示的に列挙することです。
その後、Googleログイン、顧客に紐づいた統合機能、個人用MCPキー、安全なリリースについて証拠を得たいと考えています。Codexはタスクを処理し続けていますが、この記事が記録するのは10月9日時点のスナップショットです。ゴールがどれだけ長く開いたままかではなく、これらの成果によってビルドを評価します。
情報源とこの記録の限界
タイマーは上に掲載した私のスクリーンショットから取得したものです。モデル識別子、設定の変更、私の介入は、メインセッションの履歴に基づいています。スコープと進捗数は、プロジェクト計画と日付付きの納品ログから取得しています。これらのプロジェクト記録は非公開の作業文書であり、ログや顧客データは公開していません。
OpenAIのUsing Goals in Codexでは、永続的な目的を使うワークフローが説明されています。これはGoalsの説明を裏付けるものであり、私のプロジェクトに関する納品の主張を裏付けるものではありません。
69項目という数は、広範な受け入れ状況のスナップショットであり、残り時間の測定値ではありません。スクリーンショットは中断のない推論を証明せず、設定変更はコスト削減を証明せず、ローカルチェックは本番環境への準備完了を示しません。このビルドはまだ進行中です。
*この記事は、私のスクリーンショット、セッション履歴、プロジェクトの納品記録をもとに、AIの支援を受けて作成しました。1つの進行中のビルドについて説明するものです。一般的なCodexの実行時間上限、モデルの順位、監査済みのコスト、本番環境への準備完了を示すものではありません。*