Claude Fable 5.2 m’intéresse parce que j’utilise déjà Fable pour des tâches difficiles à diviser en petites questions isolées. Je l’utilise pour élaborer des plans complexes, confronter des idées, étudier un problème et parcourir des bases de code où une fonctionnalité touche plusieurs parties du système.
Une petite fonction est rarement la partie la plus difficile. La difficulté consiste à comprendre ce qui doit encore changer et ce qui doit continuer à fonctionner.
Anthropic a lancé Fable 5.2 le 9 novembre 2026. Les premiers résultats semblent prometteurs pour ce type de travail. Ils montrent aussi pourquoi je ne lui confierais pas toutes les tâches avec le niveau d’effort maximal. Cette analyse du lancement s’appuie sur mon workflow Fable existant ; elle ne prétend pas que j’ai évalué 5.2 de manière indépendante.
Recherche vérifiée le 10 novembre 2026. L’illustration principale est une illustration éditoriale générée par AI, et non une interface Anthropic. Les graphiques ci-dessous utilisent des données d’évaluation enregistrées, et non des chiffres générés.
Quoi de neuf dans Claude Fable 5.2 ?
Fable 5.2 est le nouveau modèle d’Anthropic destiné au raisonnement exigeant et au travail technique de longue durée. Ses spécifications indiquent une fenêtre de contexte d’un million de tokens, jusqu’à 128 000 tokens de sortie, ainsi que la prise en charge d’entrées textuelles et visuelles avec une sortie textuelle. Une grande fenêtre de contexte signifie qu’il peut accepter une quantité importante de contenu ; cela ne garantit pas qu’il utilisera correctement chaque détail. Spécifications de Claude Fable 5.2
Anthropic affirme que la génération des sorties est jusqu’à 30 % plus rapide que celle de Fable 5.1. Il s’agit d’une affirmation concernant la génération des tokens, et non d’une promesse selon laquelle un projet entier se terminera 30 % plus vite.
Fable et Mythos 5.2 partagent le même modèle sous-jacent, mais diffèrent par leurs mesures de protection et leur accès. Mythos est destiné aux organisations vérifiées dans des domaines tels que la cybersécurité et les sciences de la vie. Un résultat réservé à Mythos ne doit pas être présenté comme quelque chose que tous les utilisateurs de Fable peuvent reproduire. Anthropic : lancement de Fable 5.2 et Mythos 5.2
Pourquoi j’utilise Fable lorsqu’une fonctionnalité couvre toute la base de code
Imaginez l’ajout d’une étape d’approbation à un workflow de téléversement de documents. Le bouton est facile à décrire. Une implémentation fiable demande davantage de réflexion.
L’API doit vérifier qui peut approuver. La base de données doit enregistrer la décision. Une tâche en arrière-plan doit éviter d’envoyer deux fois la même notification. L’interface doit gérer les états en attente, approuvé et échoué. Les tests doivent couvrir le cas où deux personnes agissent en même temps.
Je veux que le modèle comprenne ces connexions avant de commencer à modifier le code. Corriger chaque fichier séparément peut produire une fonctionnalité qui fonctionne sur un écran, mais échoue ailleurs.
Planifier et remettre une idée en question
C’est là que j’aime utiliser Fable comme partenaire de discussion. Je peux décrire le résultat attendu, explorer différentes approches et lui demander de remettre les hypothèses en question. Je veux un plan qui identifie les dépendances et les cas d’échec, plutôt qu’une longue liste de tâches qui semble organisée.
Par exemple, le modèle devrait expliquer si l’approbation doit être intégrée au workflow existant ou si elle nécessite un service distinct. Il devrait également pouvoir me dire qu’une modification plus limitée suffit.
Une recherche qui éclaire l’implémentation
La recherche est utile lorsqu’elle modifie une décision. Je veux que le modèle compare la documentation, explique les compromis et distingue une limitation confirmée d’une supposition.
Le critère qui m’importe est pratique : puis-je consulter la source, vérifier l’affirmation et comprendre ce qui reste incertain ? Un résumé assuré sans ces éléments de preuve ne suffit pas, quel que soit le modèle.
Que montrent les benchmarks de codage ?
Le tableau de lancement d’Anthropic indique 49,1 % sur FrontierCode 2.0, contre 32,4 % pour Fable 5.1 et 45,5 % pour Opus 5.5. Les deux résultats de Fable utilisent l’effort xhigh ; Opus utilise max. Il s’agit des meilleurs résultats obtenus avec effort, et non d’une comparaison à coût égal.
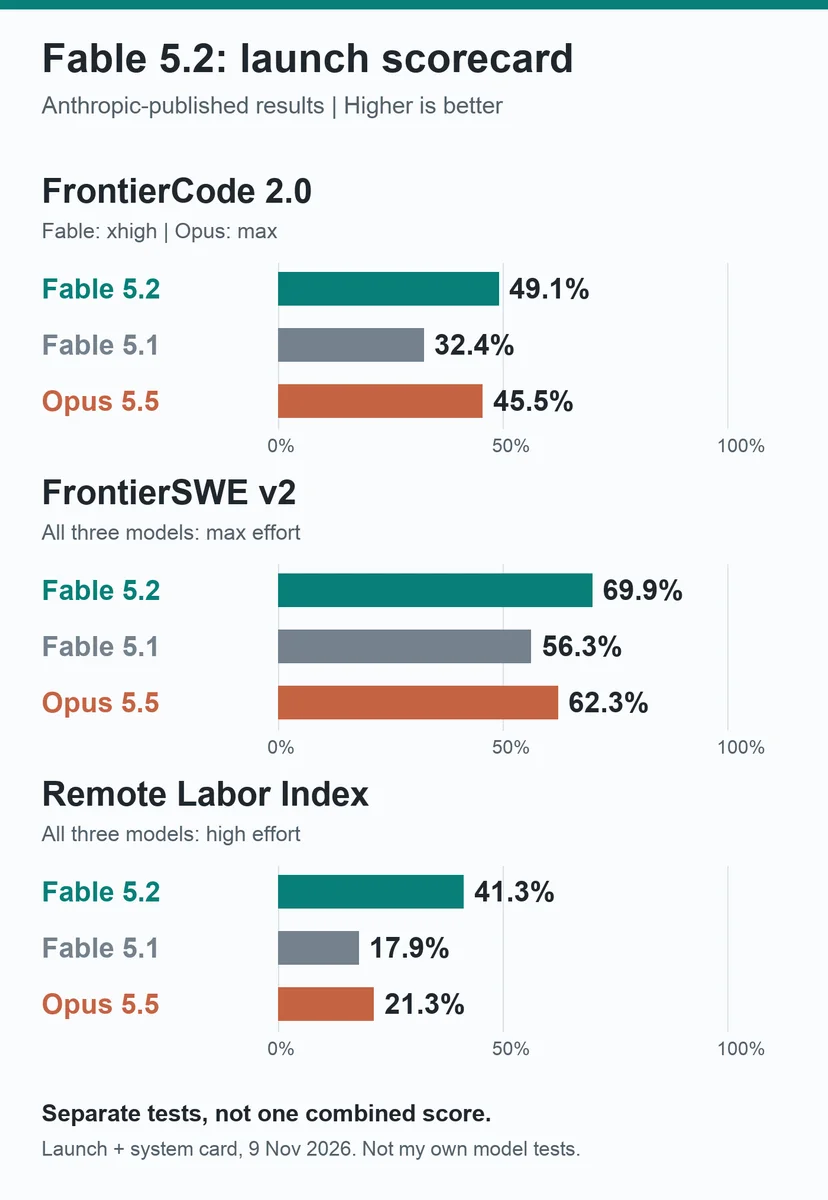
Chaque panneau mesure une tâche différente. Ne faites pas la moyenne des pourcentages. FrontierSWE v2 utilise l’effort max ; les exécutions Claude du Remote Labor Index utilisent un effort élevé, un contexte de 200 000 tokens et une limite de réponse de 32 000 tokens, selon la fiche système. Fiche système d’Anthropic, section sur les capacités
FrontierSWE est particulièrement pertinent pour mes centres d’intérêt. Ses auteurs décrivent 34 tâches longues d’ingénierie et de recherche, avec un budget de 20 heures par tâche. Cela se rapproche davantage d’une résolution de problème soutenue que de l’implémentation d’une courte fonction. Il s’agit toutefois toujours d’un environnement de test spécifique, et non d’une prévision pour mes dépôts. Méthodologie de FrontierSWE v2
Le résultat du Remote Labor Index est également facile à exagérer. Un score de 41,3 % sur ces projets ne signifie pas que Fable peut remplacer 41,3 % des emplois. Il s’agit d’un résultat obtenu sur un ensemble défini de livrables.
Que constatent les testeurs indépendants ?
Les premiers tests publics indiquent de solides capacités, avec d’importantes limites. Ils ne constituent pas encore un consensus général sur les bases de code de production.
Artificial Analysis attribue à Fable 5.2 un score arrondi de 65 à l’Intelligence Index avec un effort max dans la capture que j’ai consultée. Son résultat avec un effort élevé est de 62. La différence de coût est importante, comme le montre le graphique suivant. Il s’agit d’une suite d’évaluation distincte du tableau de lancement d’Anthropic. Artificial Analysis : résultats du modèle
Spring Prompt a réalisé ses propres tests commerciaux le 10 novembre. Fable a dominé ses tests d’analyse d’enquêtes et de simulation de budgets publicitaires, mais GPT-6.1 Sol s’est montré légèrement plus fiable pour les fiches produits factuelles et beaucoup moins cher par fiche. La plupart de ces tests n’ont été exécutés qu’une seule fois ; les tests de fiches produits ont utilisé trois répétitions. L’équipe précise qu’elle n’a pas évalué les agents de codage. J’interprète cela comme une première raison de tester les tâches fortement axées sur l’analyse, et non comme la preuve de meilleures migrations logicielles. Spring Prompt : analyse de Fable 5.2 et limites des tests
Simon Willison a relevé un avertissement utile dans une petite expérience de génération de SVG. Xhigh a produit un résultat, tandis que max a utilisé sa limite de 128 000 tokens pour réfléchir et n’a renvoyé aucune image. Il s’agit d’une expérience rapportée, et non d’un taux d’échec général. Cela suffit néanmoins à remettre en question l’hypothèse selon laquelle le niveau le plus élevé produit toujours la meilleure réponse. Simon Willison : premières expériences avec Fable 5.2
Combien cela coûte-t-il et quel niveau d’effort choisir ?
La tarification standard de l’API est de 8 $ par million de tokens d’entrée et 40 $ par million de tokens de sortie. C’est 20 % de moins que les 10 $/50 $ de Fable 5.1. Opus 5.5 coûte 4 $/20 $. Les lectures depuis le cache pour Fable 5.2 coûtent 0,20 $ par million de tokens ; les écritures dans le cache sont facturées séparément. Il s’agit des prix de l’API, et non des quotas d’un abonnement. Tarification d’Anthropic
Le mode rapide optionnel coûte 16 $/80 $ par million de tokens d’entrée/sortie. Anthropic affirme que ce mode permet une génération de tokens jusqu’à 2,5 fois plus rapide. Une sortie plus rapide et un prix inférieur par token sont deux éléments distincts du coût final d’exécution d’une tâche.
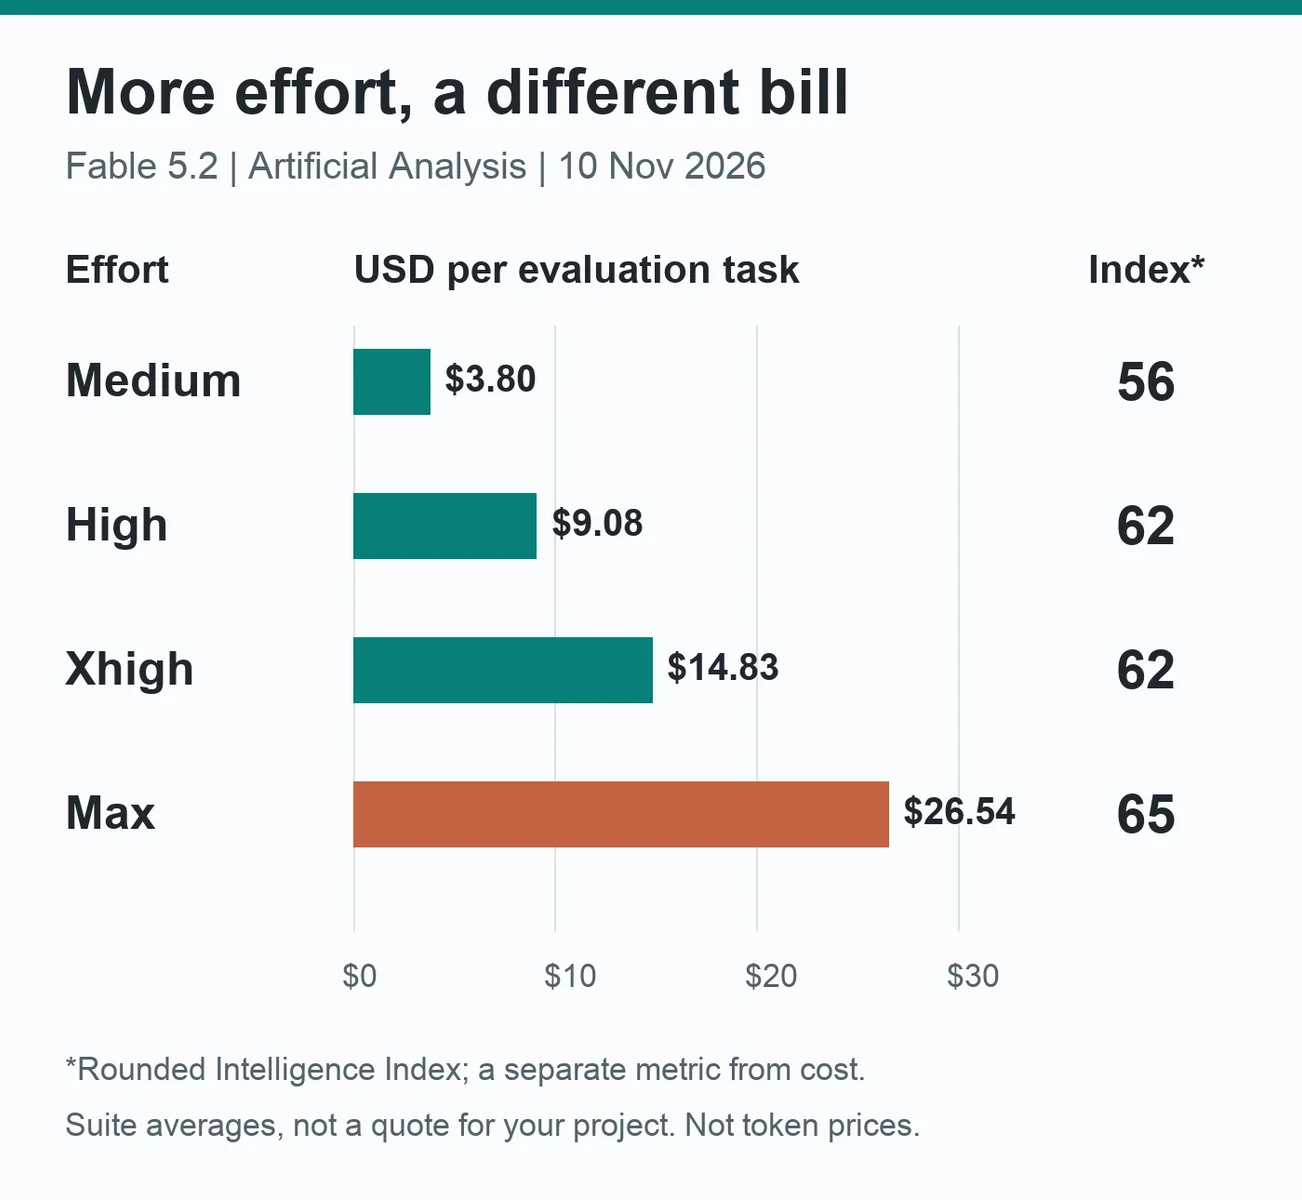
Capture d’Artificial Analysis, 10 novembre : medium 3,80 $, high 9,08 $, xhigh 14,83 $ et max 26,54 $ par tâche de l’Intelligence Index. Il s’agit de moyennes de la suite d’évaluation, et non de devis pour une fonctionnalité ou un projet de recherche. Les scores arrondis de l’index sont respectivement de 56, 62, 62 et 65. Artificial Analysis : comparaison de l’effort et du coût
Un effort plus élevé doit être justifié
L’API d’Anthropic utilise par défaut le niveau high pour Fable 5.2, tandis que sa page de lancement indique que les applications Claude et Claude Code utilisent par défaut le niveau medium. La réflexion est toujours activée. Le réglage de l’effort contrôle la quantité de travail consacrée par le modèle à sa réponse ; ce n’est pas simplement un bouton permettant d’obtenir des réponses plus longues.
Le guide d’Anthropic sur l’effort recommande high comme point de départ dans l’API et réserve max aux tâches rares pour lesquelles le temps et les tokens comptent moins. Je comparerais les réglages sur des tâches représentatives, puis je ne paierais davantage que lorsque le résultat le justifie. Conseils de Claude sur l’effort
Comment je structurerais une session de codage complexe
Je commencerais par définir clairement le résultat attendu et demander au modèle d’inspecter le système existant. J’attendrais quatre choses de la session :
Un prompt de départ pourrait être :
text Avant toute modification, suis cette fonctionnalité dans la base de code existante. Cartographie ses dépendances et explique les principaux cas d’échec. Propose la modification complète la plus limitée ainsi que les tests qui détecteraient une implémentation défectueuse. Préserve le travail sans rapport. Demande confirmation avant toute migration, publication ou mise en production. Ensuite, indique ce qui a changé, ce que tu as vérifié et ce qui reste non vérifié.
Je ne copierais pas de prompts qui donnent au modèle une responsabilité illimitée sur la base de code d’un client. Le guide de prompting d’Anthropic avertit que les formulations liées à la responsabilité peuvent encourager des modifications supplémentaires, même lorsque d’autres instructions limitent le périmètre. C’est une raison de définir explicitement les limites et d’inspecter le diff. Prompting de Claude Fable 5.2
Un modèle moins cher peut également gérer les étapes routinières pendant que Fable aide à prendre les décisions difficiles. L’outil advisor de Claude Code prend en charge cette organisation, avec des conditions d’accès et de facturation. Les conseils consomment tout de même des tokens ; la délégation n’est pas gratuite. Documentation de l’advisor de Claude Code
Mon avis : utilisez-le lorsque la compréhension du système compte
Fable 5.2 m’intéresse parce que la planification, la recherche et les modifications couvrant toute la base de code sont déjà les raisons pour lesquelles je me tourne vers Fable. Je veux de l’aide pour relier les différentes parties et remettre une approche en question avant de consacrer du temps à son implémentation.
Cela n’en fait pas automatiquement mon choix pour chaque modification. Anthropic recommande toujours de commencer la plupart des tâches de codage et de travail intellectuel avec Opus 5.5. Mon aperçu d’Opus 5.5 et mon précédent avis sur Fable 5.1 donnent davantage de contexte sur ce choix.
Pour les tâches difficiles, je veux un plan clair, une implémentation cohérente et des preuves que tout fonctionne. Je conserverais les vérifications indépendantes décrites dans mon workflow de revue de code multi-agent, plutôt que de considérer un modèle plus puissant comme son propre réviseur final.
Fable 5.2 semble mériter d’être testé sur ces tâches plus difficiles. La question utile est de savoir s’il me laisse moins de travail manquant et un résultat que je peux vérifier.