Claude Fable 5.2 interessiert mich, weil ich Fable bereits für Aufgaben verwende, die sich nur schwer in kleine, isolierte Fragen aufteilen lassen. Ich nutze es, um komplexe Pläne zu erstellen, Ideen auszutauschen, ein Problem zu recherchieren und Codebases zu bearbeiten, in denen ein Feature mehrere Teile des Systems berührt.
Eine kleine Funktion ist selten der schwierige Teil. Der schwierige Teil besteht darin zu verstehen, was sich sonst noch ändern muss und was weiterhin funktionieren muss.
Anthropic hat Fable 5.2 am 9. November 2026 veröffentlicht. Die frühen Ergebnisse sehen für diese Art von Arbeit vielversprechend aus. Sie zeigen aber auch, warum ich nicht jede Aufgabe mit maximalem Aufwand an das Modell senden würde. Dies ist eine Launch-Analyse, die auf meinem bestehenden Fable-Workflow basiert, und keine Behauptung, dass ich 5.2 unabhängig gebenchmarkt habe.
Recherche geprüft am 10. November 2026. Das Hero-Bild ist eine von AI erzeugte redaktionelle Illustration und keine Anthropic-Oberfläche. Die folgenden Diagramme verwenden aufgezeichnete Evaluierungsdaten und keine generierten Zahlen.
Was ist neu in Claude Fable 5.2?
Fable 5.2 ist Anthropics neues Modell für anspruchsvolles Reasoning und lang laufende technische Arbeit. In den Spezifikationen werden ein Kontextfenster von einer Million Tokens, bis zu 128.000 Output-Tokens sowie die Unterstützung von Text- und Bildeingaben mit Textausgabe genannt. Ein großes Kontextfenster bedeutet, dass das Modell umfangreiches Material aufnehmen kann; es garantiert nicht, dass es jedes Detail korrekt verwendet. Claude Fable 5.2 specifications
Anthropic gibt an, dass die Output-Generierung bis zu 30 % schneller als bei Fable 5.1 ist. Das ist eine Aussage über die Generierung von Tokens und kein Versprechen, dass ein gesamtes Projekt 30 % schneller abgeschlossen wird.
Fable und Mythos 5.2 verwenden dasselbe zugrunde liegende Modell, unterscheiden sich aber bei Schutzmaßnahmen und Zugriff. Mythos ist für verifizierte Organisationen in Bereichen wie Cybersecurity und Life Sciences vorgesehen. Ein ausschließlich mit Mythos erzieltes Ergebnis sollte nicht als etwas dargestellt werden, das jeder Fable-Nutzer reproduzieren kann. Anthropic: Fable 5.2 and Mythos 5.2 launch
Warum ich Fable verwende, wenn sich ein Feature über die Codebase erstreckt
Stell dir vor, du fügst einem Dokument-Upload-Workflow einen Genehmigungsschritt hinzu. Der Button lässt sich leicht beschreiben. Eine zuverlässige Implementierung erfordert mehr Überlegung.
Die API muss prüfen, wer genehmigen darf. Die Datenbank muss die Entscheidung speichern. Ein Hintergrundjob muss verhindern, dass dieselbe Benachrichtigung zweimal gesendet wird. Die Oberfläche benötigt Zustände für ausstehend, genehmigt und fehlgeschlagen. Tests müssen abdecken, dass zwei Personen gleichzeitig handeln.
Ich möchte, dass das Modell diese Zusammenhänge versteht, bevor es mit den Änderungen beginnt. Wenn jede Datei einzeln angepasst wird, kann ein Feature entstehen, das auf einem Bildschirm funktioniert, aber an anderer Stelle fehlschlägt.
Eine Idee planen und hinterfragen
Hier gefällt mir Fable als Diskussionspartner besonders gut. Ich kann das gewünschte Ergebnis beschreiben, verschiedene Ansätze untersuchen und das Modell bitten, die Annahmen zu hinterfragen. Ich möchte einen Plan, der Abhängigkeiten und Fehlerfälle identifiziert, statt einer langen Aufgabenliste, die nur organisiert klingt.
Das Modell sollte zum Beispiel erklären, ob die Genehmigung in den bestehenden Workflow gehört oder einen separaten Service benötigt. Es sollte mir auch sagen können, dass die kleinere Änderung ausreicht.
Recherche, die eine Implementierung beeinflusst
Recherche ist nützlich, wenn sie eine Entscheidung verändert. Ich möchte, dass das Modell Dokumentation vergleicht, Zielkonflikte erklärt und eine bestätigte Einschränkung von einer Vermutung unterscheidet.
Der Maßstab, der mir wichtig ist, ist praktisch: Kann ich der Quelle folgen, die Aussage überprüfen und verstehen, was weiterhin unsicher ist? Eine selbstbewusste Zusammenfassung ohne diese Belege reicht unabhängig vom Modell nicht aus.
Was zeigen die Coding-Benchmarks?
Anthropics Launch-Tabelle weist 49,1 % bei FrontierCode 2.0 aus, gegenüber 32,4 % für Fable 5.1 und 45,5 % für Opus 5.5. Die beiden Fable-Ergebnisse verwenden den Aufwand xhigh; Opus verwendet max. Dies sind ausgewählte Ergebnisse mit maximalem Aufwand und kein Vergleich bei gleichen Kosten.
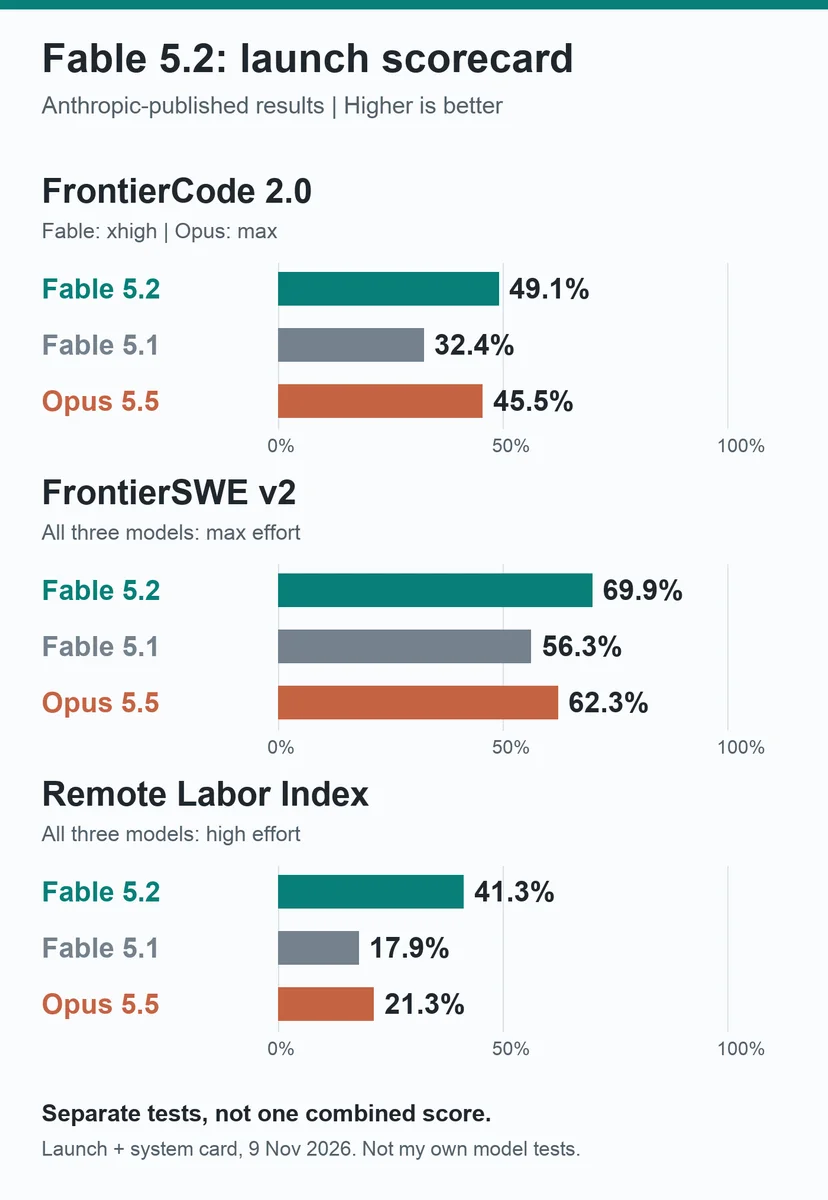
Jedes Panel misst eine andere Aufgabe. Die Prozentsätze sollten nicht gemittelt werden. FrontierSWE v2 verwendet den Aufwand max; die Claude-Läufe des Remote Labor Index verwenden laut System Card den Aufwand high, einen Kontext von 200.000 Tokens und ein Antwortlimit von 32.000 Tokens. Anthropic system card, capabilities section
FrontierSWE ist für meine Interessen besonders relevant. Die Autoren beschreiben 34 umfangreiche Engineering- und Rechercheaufgaben mit einem Zeitbudget von 20 Stunden pro Aufgabe. Das kommt nachhaltiger Problemlösung näher als dem Vervollständigen einer kurzen Funktion. Es handelt sich dennoch um eine spezifische Testumgebung und nicht um eine Prognose für meine Repositories. FrontierSWE v2 methodology
Auch das Ergebnis des Remote Labor Index lässt sich leicht überinterpretieren. Ein Wert von 41,3 % bei diesen Projekten bedeutet nicht, dass Fable 41,3 % der Arbeitsplätze ersetzen kann. Es ist ein Ergebnis für eine definierte Menge an Deliverables.
Was stellen unabhängige Tester fest?
Die ersten öffentlichen Tests deuten auf starke Fähigkeiten mit wichtigen Einschränkungen hin. Sie bilden noch keinen breiten Konsens über Produktions-Codebases.
Artificial Analysis führt Fable 5.2 in dem von mir geprüften Snapshot mit einem gerundeten Intelligence-Index-Wert von 65 bei maximalem Aufwand. Das Ergebnis bei hohem Aufwand liegt bei 62. Der Kostenunterschied ist erheblich, wie das nächste Diagramm zeigt. Dies ist eine separate Evaluierungssuite und nicht die Launch-Tabelle von Anthropic. Artificial Analysis: model results
Spring Prompt führte am 10. November eigene Business-Tests durch. Fable lag bei den Tests zur Umfrageanalyse und zum simulierten Werbebudget vorn, aber GPT-6.1 Sol war bei faktischen Produktlisten etwas zuverlässiger und pro Eintrag deutlich günstiger. Die meisten dieser Tests wurden einmal ausgeführt; bei den Produktlistentests gab es drei Wiederholungen. Das Team sagt ausdrücklich, dass es keine Coding-Agents gebenchmarkt hat. Ich verstehe dies als frühen Grund, analyseintensive Arbeit zu testen, nicht als Beweis für bessere Software-Migrationen. Spring Prompt: Fable 5.2 review and test limits
Simon Willison fand in einem kleinen Experiment zur SVG-Generierung eine nützliche Warnung. Xhigh erzeugte ein Ergebnis, während max sein Limit von 128.000 Tokens mit Nachdenken verbrauchte und kein Bild zurückgab. Das ist ein einzelnes dokumentiertes Experiment und keine allgemeine Fehlerquote. Es reicht jedoch aus, die Annahme infrage zu stellen, dass die höchste Einstellung immer die beste Antwort liefert. Simon Willison: first Fable 5.2 experiments
Wie viel kostet es, und welche Aufwandseinstellung ist sinnvoll?
Die Standardpreise der API betragen 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens. Das sind 20 % weniger als die 10 $/50 $ von Fable 5.1. Opus 5.5 kostet 4 $/20 $. Cache-Lesevorgänge für Fable 5.2 kosten 0,20 $ pro Million Tokens; für Cache-Schreibvorgänge fallen separate Gebühren an. Dies sind API-Preise und keine Kontingente eines Abonnements. Anthropic pricing
Der optionale Fast Mode kostet 16 $/80 $ pro Million Input-/Output-Tokens. Anthropic gibt an, dass die Token-Generierung in diesem Modus bis zu 2,5-mal schneller ist. Eine schnellere Ausgabe und ein niedrigerer Preis pro Token sind etwas anderes als die endgültigen Kosten für den Abschluss einer Aufgabe.
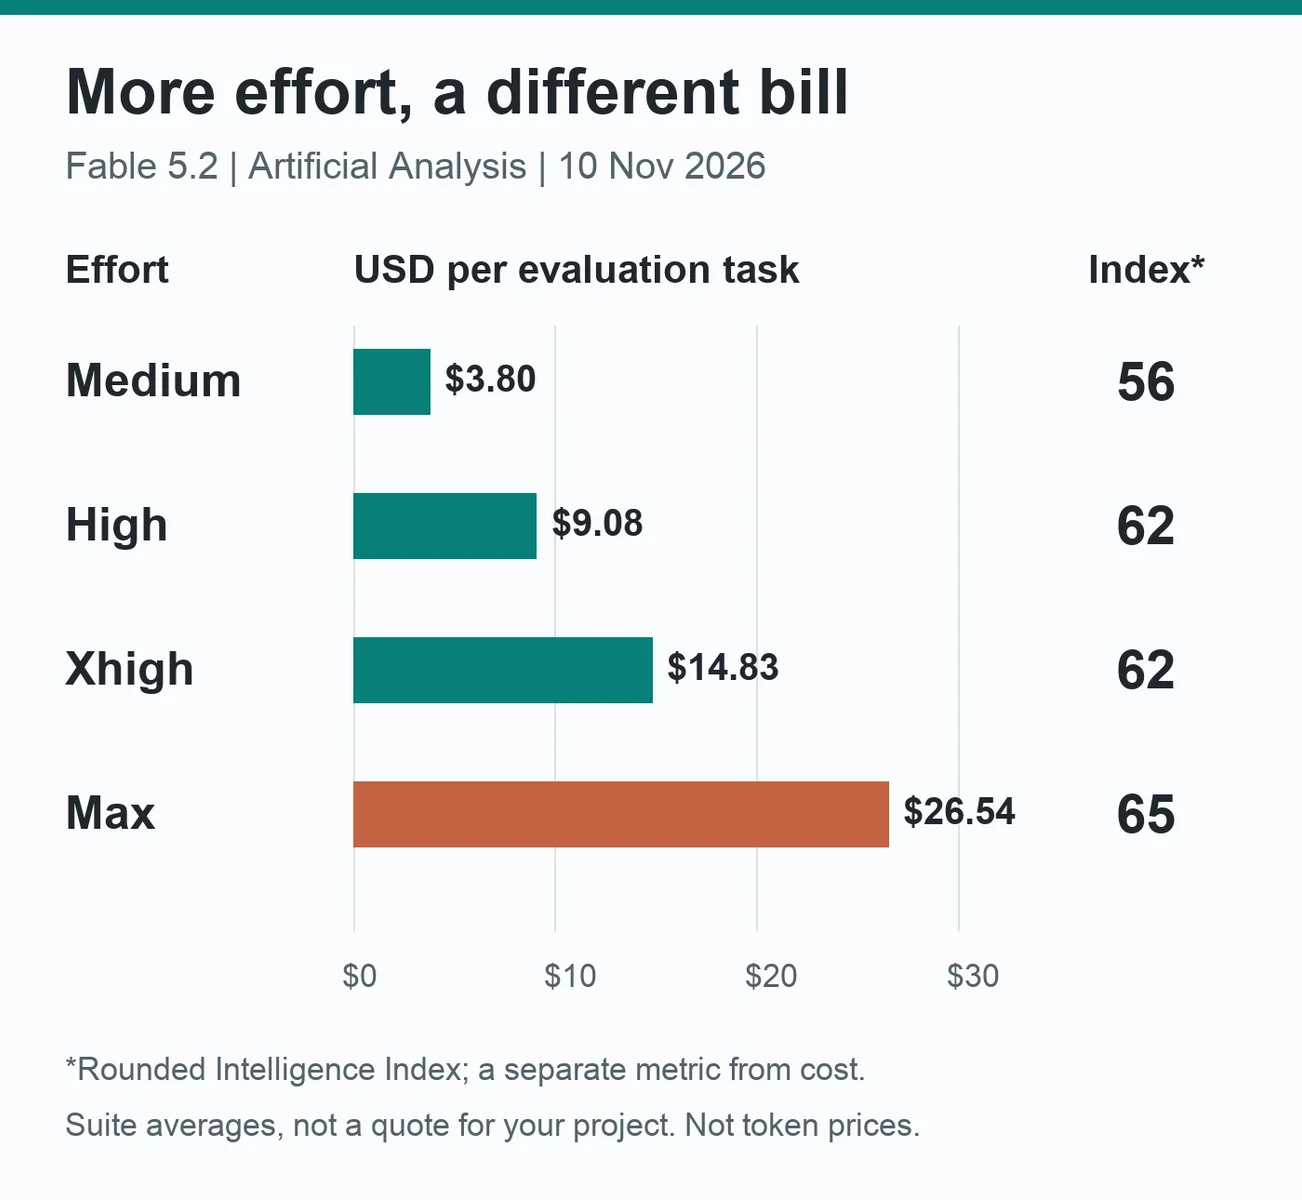
Snapshot von Artificial Analysis, 10. November: medium 3,80 $, high 9,08 $, xhigh 14,83 $ und max 26,54 $ pro Intelligence-Index-Aufgabe. Dies sind Durchschnittswerte der Evaluierungssuite und keine Angebote für ein Feature oder ein Rechercheprojekt. Die gerundeten Indexwerte betragen jeweils 56, 62, 62 und 65. Artificial Analysis: effort and cost comparison
Höherer Aufwand braucht einen Grund
Anthropics API verwendet für Fable 5.2 standardmäßig high, während auf der Launch-Seite steht, dass Claude-Apps und Claude Code standardmäßig medium verwenden. Thinking ist immer aktiviert. Die Aufwandseinstellung steuert, wie viel Arbeit das Modell in seine Antwort investiert; sie ist nicht einfach ein Schalter für längere Antworten.
Anthropics Leitfaden zu Aufwandseinstellungen empfiehlt high als Ausgangspunkt für die API und reserviert max für seltene Aufgaben, bei denen Zeit und Tokens eine geringere Rolle spielen. Ich würde die Einstellungen anhand repräsentativer Arbeit vergleichen und erst dann mehr bezahlen, wenn das Ergebnis dies rechtfertigt. Claude effort guidance
Wie ich eine komplexe Coding-Session strukturieren würde
Mein Ausgangspunkt wäre ein klares Ergebnis und die Aufforderung, das bestehende System zu untersuchen. Ich würde von der Session vier Dinge erwarten:
Ein möglicher Ausgangsprompt wäre:
text Before editing, trace this feature through the existing codebase. Map its dependencies and explain the main failure cases. Propose the smallest complete change and the tests that would catch a broken implementation. Preserve unrelated work. Ask before migrations, publication or deployment. Afterwards, report what changed, what you verified and what remains unverified.
Ich würde keine Prompts kopieren, die dem Modell uneingeschränkte Kontrolle über die Codebase eines Kunden geben. Anthropics Prompting-Leitfaden warnt, dass Formulierungen zur Verantwortung zusätzliche Änderungen fördern können, selbst wenn andere Anweisungen den Umfang begrenzen. Das ist ein Grund, die Grenzen ausdrücklich festzulegen und den Diff zu prüfen. Prompting Claude Fable 5.2
Ein günstigeres Modell kann auch Routineaufgaben übernehmen, während Fable bei schwierigen Entscheidungen hilft. Das Advisor-Tool von Claude Code unterstützt diese Anordnung, wobei Zugriffs- und Abrechnungsbedingungen gelten. Auch Beratung verbraucht Tokens; Delegation ist nicht kostenlos. Claude Code advisor documentation
Meine Einschätzung: Verwende es dort, wo das Verständnis des Systems zählt
Fable 5.2 interessiert mich, weil Planung, Recherche und codebase-übergreifende Änderungen bereits die Gründe sind, aus denen ich zu Fable greife. Ich möchte Unterstützung dabei, die einzelnen Teile miteinander zu verbinden und einen Ansatz zu hinterfragen, bevor ich Zeit in die Implementierung investiere.
Das macht Fable nicht automatisch zu meiner Wahl für jede Änderung. Anthropic empfiehlt weiterhin, die meisten Coding- und Wissensaufgaben mit Opus 5.5 zu beginnen. Meine Opus 5.5 overview und mein früherer Fable 5.1 review liefern Kontext für diese Entscheidung.
Bei schwieriger Arbeit möchte ich einen klaren Plan, eine schlüssige Implementierung und Belege dafür, dass sie funktioniert. Ich würde die unabhängigen Prüfungen aus meinem multi-agent code review workflow beibehalten, statt ein stärkeres Modell als abschließenden Reviewer zu behandeln.
Fable 5.2 scheint es wert zu sein, bei diesen schwierigeren Aufgaben getestet zu werden. Die nützliche Frage ist, ob mir dadurch weniger offene Arbeit bleibt und ein Ergebnis entsteht, das ich überprüfen kann.