الصندوق الأسود لـ LLM مشكلة عملية: يمكن لنموذج أن يجيب عن سؤال صعب خلال ثوانٍ، بينما نعجز عن تفسير أي الحسابات الداخلية أنتجت الإجابة. في 15 أكتوبر 2026، نشر Nick Cammarata، وهو مؤلف مشارك في دراسة OpenAI عن العصبونات لعام 2023، مقال Neural Networks Are Already Clean بصفته باحثًا في Goodfire. ويجادل بأن هذا «الصندوق الأسود» قد يكون أسهل للدراسة مما افترض المجال. ويستحق هذا الادعاء الانتباه، لكنه يحتاج أيضًا إلى قراءة متأنية: فالمقال فرضية قيد العمل، وما تزال ورقته التقنية المصاحبة حول عصبونات نماذج اللغة قادمة.
السؤال المفيد هو ما إذا كان بإمكان الباحثين الانتقال من وصف مثير للاهتمام لعصبون إلى تفسير موثوق لسلوك نموذج. يقدم Cammarata أدلة جديدة على الخطوة الأولى، وعدة عروض سببية للخطوة الثانية. ولا يشكل أي منهما خريطة كاملة لنموذج لغة كبير.
للحصول على ملخص بلغة بسيطة، انتقل إلى النسخة المبسطة.
لماذا يستمر الصندوق الأسود لـ LLM؟
يعرف الباحثون العمليات الرياضية في الشبكة المدرَّبة. لكن الجزء الصعب هو تفسير كيفية اجتماع ملايين المكونات المتعلَّمة لإنتاج إجابة معينة. قد ينشط عصبون اصطناعي واحد استجابةً لأمثلة تبدو غير مترابطة. فإذا استجاب لوجه قطة ولواجهة سيارة في الوقت نفسه، فما الذي يمثله فعليًا؟
كانت إحدى الإجابات المؤثرة هي التراكب (superposition): فقد يعبئ النموذج سمات غير مترابطة في اتجاهات داخلية متداخلة لأنه يمتلك مساحة محدودة. ثم يدرّب الباحثون نموذجًا ثانيًا، غالبًا ما يكون مشفّرًا تلقائيًا متناثرًا، لفصل تلك السمات.
يجادل Cammarata بأن بعض الأدلة الكلاسيكية على هذه الصورة أسيء تفسيرها. فقد يعكس المزيج الظاهري نمطًا مشتركًا، أو مجهرًا غير مثالي، أو بنية شبكة جعلت تدريب الطبقات اللاحقة أكثر صعوبة. وتعريفه للتراكب هو تحديدًا حزم حسابات غير مترابطة في الآلية نفسها؛ بينما يستخدم باحثون آخرون الكلمة على نحو أوسع للإشارة إلى تمثيل مفاهيم أكثر من عدد الأبعاد. يشرح مقاله هذا الفرق.
ما الذي تغير في البحث الجديد؟
جاء عصبون القطة والسيارة المألوف من نموذج رؤية، وليس من LLM. ويصفه Cammarata الآن بأنه يستجيب لنمط بصري مشترك على شكل حرف V. ووفقًا لروايته، يجمع العصبون بنية بصرية مترابطة بدلًا من إخفاء مفهومين عشوائيين في خانة واحدة. كما يذكر أنه بعد إجراء تغييرات معمارية على InceptionV1، وهو نموذج رؤية، أصبح 99–100% من العصبونات في طبقته النهائية سهل التفسير، مع بقاء حجم النموذج وبيانات التدريب ثابتين. وهذا ادعاء يتعلق بطبقة معاد تدريبها في نموذج رؤية، وليس إحصائية عن نماذج المحادثة الحديثة.
أما الأدلة المتعلقة بنماذج اللغة فهي أكثر صلة بـ LLM وأكثر أولية. يقدّر فريق Goodfire أنه في تدقيق أولي لـ Qwen3-32B، يمتلك نحو 90% من أقطاب العصبونات وظيفة رئيسية واحدة، غالبًا مع تفرعات صغيرة مترابطة. وتمتلك نسبة إضافية تقارب 7% وظيفتين مترابطتين، بينما تظل نحو 2–4% غير مفسَّرة.
يشير «القطب» إلى أحد جانبي استجابة العصبون الموجبة أو السالبة؛ ولا تعني النسبة أن 90% من سلوك LLM قد فُسِّر. ويقول Cammarata إن التصنيف يتغير تبعًا للعتبة المحددة للتنشيطات الضعيفة، وعمق النموذج، وكثافة الدوائر، وما يُعد وظيفة واحدة. تظهر هذه التحفظات بجوار التقدير.
ويقدم الفريق أكثر من مجرد تسميات للتنشيطات. يتضمن المقال التفاعلي 1,000 دراسة حالة لعصبونات اختيرت عشوائيًا من Qwen3-32B وQwen3.6-35B-A3B. وفي أحد الاختبارات، استخدم وكيل تفسيرات مكتوبة لابتكار أمثلة يُفترض أن تنشّط عصبونًا، وأمثلة قريبة لكنها لا ينبغي أن تنشّطه. ومن بين 183 عصبونًا لها تفسيرات لجانبها الموجب، نشّطت الأمثلة الجديدة العصبونات بقوة في 76% من المرات، مقابل 11% للأمثلة القريبة. وهذا اختبار تنبؤ مفيد ضمن إعداد الفريق، لكنه لا يثبت أن الأوصاف تلتقط كل تنشيط مهم أو كل تأثير لاحق.
هل يستطيع الباحثون تغيير إجابة LLM من خلال التدخل؟
نعم، في أمثلة مختارة. يتتبع Goodfire مجموعات من عصبونات Qwen3-32B ثم يزيلها ليرى ما الذي يتغير. ففي مطالبة تشير قرائنها إلى Santa Claus، أدى إزالة ثمانية عصبونات مختارة مرتبطة بالإجابة إلى خفض الاحتمال الذي أبلغه النموذج لكلمة «Santa» إلى 0.059؛ بينما أبقت إزالة العدد نفسه من العصبونات العشوائية في الطبقات المطابقة الاحتمال عند 0.997. وهذا دليل على أن تلك العصبونات المختارة كانت مهمة لتلك المطالبة وللتنبؤ بالكلمة التالية. لكنه ليس معدل نجاح مقاسًا عبر مطالبات أو نماذج عشوائية. يُعرض التدخل والاختبار الضابط في المقال الأصلي.
كما يعرض Cammarata رسمًا بيانيًا للإسناد قائمًا على العصبونات لنموذج Kimi K3، وهو نموذج يضم عدة تريليونات من المعاملات. ويتتبع مثال المحفظة بعض المسارات من المطالبة نحو إجابة تتعلق بإعادة ممتلكات مفقودة. ويسمي المقال المجموعات المعروضة شريحة منتقاة يدويًا، ويقول إن عمليات التدقيق الكاملة بهذا الحجم لم تبدأ بعد. إن عرض شريحة قابلة للقراءة من نموذج ضخم جدًا أمر واعد، لكنه لا يخبرنا بما فعلته كل المسارات المحذوفة.
كيف يستجيب الباحثون الآخرون؟
في 17 أكتوبر 2026، نشر الباحث Leo Gao مقال Neural networks are not already clean. وهو يوافق على أن الأعمال السابقة ربما وصفت العصبونات بأنها متعددة الدلالة بسرعة أكبر من اللازم.
ويتمثل اعتراضه في أن الوصف المنظم لأقوى الأمثلة قد يظل عاجزًا عن التقاط المدخلات التي ينبغي أن تنشّط العصبون، أو الاستجابات الضعيفة المهمة، أو أهمية قوة التنشيط. ويقترح Gao اختبارًا أكثر صرامة: استبدال قيم العصبون بقيم متوقعة من التفسير، ثم قياس ما إذا كان باقي النموذج سيستمر في التصرف بالطريقة نفسها. فإذا تدهور السلوك، فهذا يعني أن التفسير أغفل شيئًا مهمًا.
ويطرح رد Neel Nanda المباشر تمييزًا ذا صلة. فهو يرى قيمة عملية في استخدام العصبونات الأصلية ورسوم الإسناد للتحقيق في سلوك مريب محدد. لكنه لا يزال غير مقتنع بأن هذا يثبت اقتراب الهندسة العكسية الطموحة، ويشير خصوصًا إلى التنشيطات الضعيفة في LLM والمعلومات الموجودة في مجرى البقايا. ويقول Cammarata نفسه إن الانتباه أقل فهمًا في هذا العمل، وإن نماذج اللغة الهائلة لا تزال بعيدة عن رسم خريطة كاملة لها.
الخلاف منتج. تسأل Goodfire عما إذا كانت مكونات الشبكة نفسها يمكن أن تكون نقطة البداية للتفسير. بينما يسأل Gao وNanda عن مقدار ما يجب أن يتنبأ به التفسير قبل أن نثق به. قد يبدو العصبون قابلًا للفهم، ويشارك سببيًا في إجابة واحدة، ومع ذلك يظل لديه سلوك مهم لم نلتقطه.
وتزيد ردة فعلين أخريين من صرامة معيار الإثبات. ففي النقاش العام نفسه، يطلب John Wentworth تفسيرًا عصبونًا بعصبون لنموذج ConvNeXt للرؤية المعروض، مع الأدلة الداعمة لكل تفسير. ويقول إن المجهر العام وحده لم يجعل معاني تلك العصبونات واضحة له فورًا. وهذا طلب للحصول على أثر قابل للفحص، وليس اختبارًا يدحض نتائج LLM. أما Alex Gibson فيشير إلى فجوة مختلفة: فالمقال يصف استنتاجه الأكبر بأنه شديد المضاربة، بينما تبدو بعض المنشورات الاجتماعية القصيرة أكثر يقينًا. وهذه ردود فردية مبكرة، وليست حكمًا شاملًا من المجال.
هل يجعل هذا نظام AI آمنًا أو شفافًا؟
لا تنشأ أي شهادة أمان من هذه النتائج. فتفسير عصبون واحد ادعاء محلي. ورسم الإسناد حساب جزئي لعملية واحدة. أما ادعاء الضمان على مستوى النظام فسيتطلب تغطية للدوائر المهمة، واختبارات موثوقة ضد السلوك الذي لم يُلتقط، وأدلة على أن الطريقة تعمل خارج الأمثلة المختارة للفحص. وبالنسبة إلى نظام يستخدم الأدوات، لا تزال صلاحيات وكلاء AI→ بحاجة إلى تقييد ما يستطيع النموذج فعله، بغض النظر عن مدى قابلية قراءة دوائره الداخلية.
وستكون الورقة التقنية الخاصة بـ Goodfire حول نماذج اللغة، إلى جانب التكرار المستقل، مهمة هنا.
وهناك أيضًا حد يتعلق بالوصول. تفحص هذه التجارب التنشيطات الداخلية وتتدخل في المكونات. وإذا كان منتجك لا يفعل سوى استدعاء hosted chat API، فلا يمكنك إجراء الاختبارات نفسها على ذلك النموذج من خلال المطالبات العادية.
النسخة المبسطة
يدخل سؤال إلى نموذج AI، وتخرج إجابة. أما الجزء الصعب فهو معرفة ما حدث في الداخل.
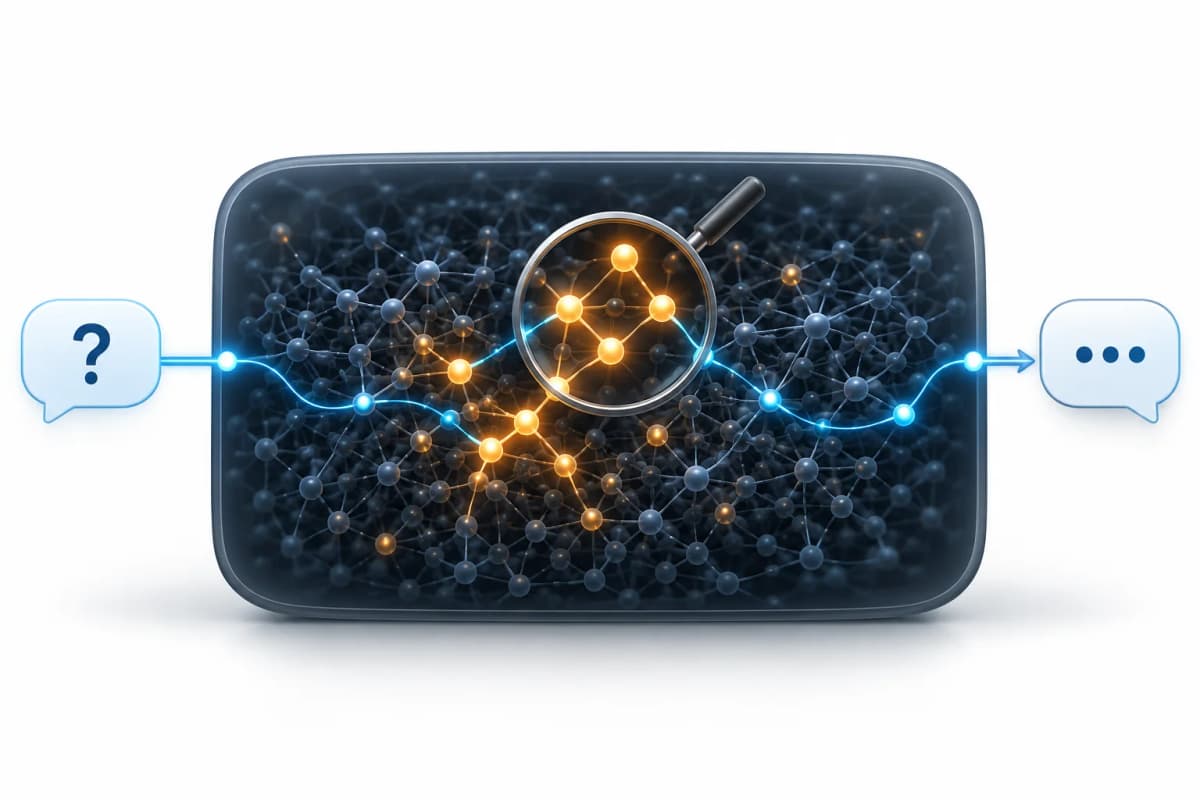
ما حدث: فحصت Goodfire أجزاء صغيرة من نموذج لغة تُسمى عصبونات. وفي اختبارات مختارة، تمكن الباحثون من وصف وظيفة بعض هذه العصبونات وتغيير إجابة من خلال إزالتها.
لماذا يهم ذلك: قد تكون آليات النموذج الداخلية أسهل للتحقيق مما توقعه كثير من الباحثين.
ما الذي لا يعنيه ذلك: لا يمكننا بعد تفسير كل إجابة أو اعتبار النموذج آمنًا. وإذا كنت تبني باستخدام AI APIs العادية، فواصل اختبار المخرجات وتقييد ما يستطيع AI فعله. وقد تؤدي الدراسات اللاحقة إلى أدوات أفضل لتصحيح النماذج ومراقبتها.
ماذا يعني هذا لمنتجات AI اليوم؟
بالنسبة إلى تدفقات عمل الوكلاء والمحتوى التي أبنيها، لا تمنحنا هذه النتيجة مفتاحًا جديدًا لتشغيله. يتمثل العمل الفوري في اختبار المهام التي ينفذها المستخدمون فعليًا، والتحقق من المصادر والادعاءات الواقعية، وتسجيل سلوك النموذج والأدوات، وتقييد صلاحيات الأدوات، وطلب موافقة بشرية قبل اتخاذ إجراءات خارجية مؤثرة. وتعالج هذه الضوابط الإخفاقات القابلة للملاحظة، سواء كانت عصبونات النموذج قابلة للفهم أم لا.
ولا يزال بإمكانك تقييم السلوك الخارجي لنموذج مستضاف. ويتناول دليلي السابق حول معايرة الثقة في LLM→ إحدى هذه المهام: التحقق مما إذا كانت الدرجة تتوافق مع الصحة في عملك أنت. وهذا يقيس سؤالًا مختلفًا عن قابلية التفسير الآلي، وكلاهما يتطلب حدودًا واضحة.
وقبل اعتماد مراقب داخلي، سأسأل عن السلوك الذي يكتشفه في العمل المحجوز للاختبار، وعدد المرات التي يفوّت فيها الحالات الضارة أو يقاطع الحالات السليمة، وما إذا كان يتصرف قبل استدعاء أداة، وما إذا كان المزود يتيح فعلًا التنشيطات المطلوبة. ولا تجيب مخرجات API العادية عن هذه الأسئلة.
ما الذي قد يتغير على المدى الأطول؟
إذا أعادت فرق أخرى إنتاج نتائج العصبونات وتمكنت من تتبع المسارات المهمة بين العصبونات، فقد يستطيع مطورو النماذج تشخيص الإخفاقات على مستوى الآلية بدلًا من دراسة المخرجات فقط. كما يطرح Cammarata وكلاء بحث آليين وتغيير بيئة التدريب بعناية عندما يثبت أنها ضارة بوصفها خطوات مستقبلية ممكنة. وهذه مقترحات للاختبار، وليست قدرات أثبتها هذا المقال.
وهناك اتجاه ذو صلة يملك مثالًا ملموسًا بالفعل. ففي دراسة منفصلة لـ Goodfire حول Kimi K3، يرسل مسبار تنشيط البيانات إلى نموذج ثانٍ يحكم على ما إذا كان ينبغي مقاطعة تفاعل وكيل محفوف بالمخاطر. وتذكر Goodfire نتائج واعدة في تقييماتها الخاصة. ويحتاج هذا المراقب إلى الوصول إلى التنشيطات الداخلية، كما أن الدراسة لا تتحقق من تفسيرات Cammarata للعصبونات. لكنها توضح ما قد تقدمه الإشارات على مستوى النموذج مستقبلًا لمزود أو لنشر مفتوح الأوزان؛ أما عميل API فسيحتاج إلى خدمة مكشوفة وتقييم خاص بمهمته.
قد تساعد الرؤية الداخلية الأفضل في مراجعات السلامة، كما قد تجعل تطوير النماذج أسرع. ولا يزال التوازن مجهولًا. وسيطلب معيار مستقبلي مفيد من المزودين إظهار السلوكيات التي تغطيها تفسيراتهم الداخلية، والمواضع التي تفشل فيها، وما إذا كان المراقب يحسن النتائج مقارنةً بالفحوص القائمة على المخرجات فقط في تدفقات العمل الواقعية.
ما الذي ينبغي أن نراقبه لاحقًا؟
سأبحث عن خمسة أنواع من الأدلة في الورقة التقنية الموعودة والأعمال اللاحقة:
قراءتي هي أن Goodfire قدمت حجة موثوقة للنظر بجدية أكبر في عصبونات النموذج الأصلية. كما منحت الباحثين تجارب أفضل للنقاش حولها. واعتبارًا من 17 أكتوبر 2026، فإن أقوى استنتاج أضيق من القول إن «الصندوق الأسود لـ LLM قد حُل»: فقد تكون بعض الأجزاء أكثر قابلية للقراءة مما كان متوقعًا، بينما لا يزال الطريق من الأجزاء القابلة للقراءة إلى تفسيرات موثوقة للنموذج بأكمله مفتوحًا. وبالنسبة إلى الفرق التي تبني على hosted APIs، تظل اختبارات السلوك وحدود الصلاحيات نقطة البداية العملية.
المصادر الأساسية: مقال Cammarata البحثي، رد Gao، النقاش المباشر بين الباحثين، ودراسة Goodfire المنفصلة حول مراقبة التنشيط.