عدت للتو إلى المنزل من العمل، وقد منحتني OpenAI سببًا وجيهًا لفتح الحاسوب المحمول مجددًا. GPT-6.2 Astra وSol متاحان الآن. أريد الليلة تجربتهما على العمل الذي يهمني: إجراء تغييرات عبر قاعدة شيفرة، والبحث الصعب، وإنتاج مرئي يجب أن يعمل بما يتجاوز لقطة الشاشة.
أنا متحمس للبدء. لم أنهِ تلك الاختبارات بعد. هذا تحليل للإطلاق وخطة اختبار، مع إبقاء القياسات المنشورة وردود الفعل المبكرة منفصلة عن نتائجي المستقبلية.
ما الذي تقول OpenAI إن GPT-6.2 Astra وSol جيدان فيه؟
في تقديم GPT-6.2 Astra وSol، تضع OpenAI Astra للمشروعات المهنية الأصعب وSol للعمل اليومي الفعّال. والوعد هو الحصول على عمل نهائي أفضل باستخدام عدد أقل من رموز الإخراج: شيفرة أنظف، وعمل مرئي أقوى، ومستندات تلتزم بالمطلوب بدرجة أكبر.
تسلط OpenAI الضوء أيضًا على العلوم وسير عمل الوكلاء طويل الأمد. وتضع مقارنة FrontierCode نموذج Sol على بُعد 0.5 نقطة من Astra، وبنحو خُمس تكلفة المهمة، مع استخدام أقصى جهد لكليهما. هذه نتيجة لهذا التقييم، وليست وعدًا بشأن مستودعاتي.
النموذجان متاحان عبر ChatGPT Work وCodex وAPI. ويذكر الإطلاق إمكانية الوصول لمشتركي Plus وPro وEnterprise وEdu، مع شروط خاصة بمساحات العمل وUltrafast. تحقّق من خطتك الفعلية بدل افتراض أن أسعار API تصف حصتك ضمن الاشتراك.
اختياري المبدئي هو Sol للعمل المتكرر، وAstra للمقارنة الصعبة. بهذه الطريقة أخطط لتوزيع اختبارات الليلة. وهذا ليس حكمًا بأن أحدهما سيكون دائمًا الخيار الأفضل.
لا يوجد فائز عالمي واحد في المعايير
الجداول المستقلة أكثر فائدة من عنوان واحد عن الانتصار. تعرض Artificial Analysis نموذج Astra، وSol، وFable 5.2 مع درجات Intelligence Index المقرّبة التالية، وفق إعداداتها القصوى المدرجة: 62 و57 و65 على التوالي.
إدخال Fable موسوم بـ Max, Default Fallback. تعامل مع هذا الإعداد باعتباره جزءًا من النتيجة، لا حاشية يمكن تجاهلها. نقاط هذا المؤشر ليست نسبًا مئوية للمهام التي تم حلها.
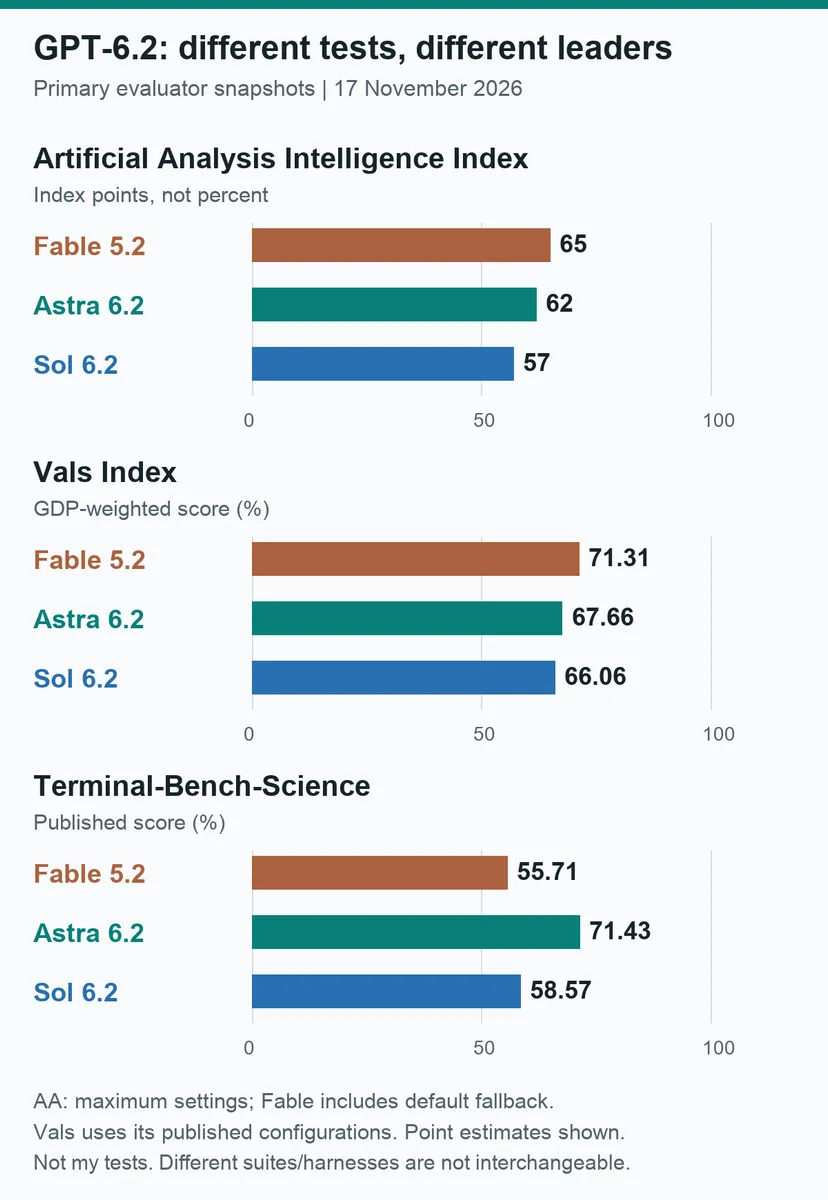
أُعيد رسم المخطط من لقطات 17 نوفمبر المنشورة من قِبل جهات التقييم، وليس من اختباراتي الخاصة. تستخدم AA مؤشرها v5.0.1 والإعدادات القصوى المدرجة؛ بينما يستخدم Vals إعداداته المنشورة. تُعرض التقديرات النقطية من دون فواصل لعدم اليقين. لا يمكن التعامل مع المجموعات وأدوات الاختبار المختلفة باعتبارها قابلة للتبادل.
توضح مقارنة Vals المفاضلة بوضوح:
| النموذج | نقاط AA index | Vals Index | Vals Terminal-Bench-Science |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 71.31% | 55.71% |
| GPT-6.2 Astra | 62 | 67.66% | 71.43% |
| GPT-6.2 Sol | 57 | 66.06% | 58.57% |
يتصدر Astra هذه المقارنة العلمية لسير عمل الطرفية. بينما يتصدر Fable مؤشر Vals الأوسع. يتأخر Sol عن Astra في هذه التقديرات النقطية، مع تمتعه بمعدلات أقل لرموز API. ولا يقيس أي من الجدولين عدد التصحيحات التي سيحتاجها مشروعي تحديدًا.
هناك فخ آخر في المقارنة: تشير ملاحظات إطلاق OpenAI إلى أن نتيجة Fable العلمية التي تستشهد بها تستخدم أداة اختبار للوكلاء مختلفة عن نتيجة Claude Code المنشورة من Anthropic. لن أضع تلك الدرجات في مخطط واحد وأصف الفرق بأنه تحسن في النموذج.
ولفهم الجانب الآخر من المقارنة، يغطي مقالي عن Fable 5.2 للبرمجة المعقدة والتخطيط والبحث سبب أهمية أعباء العمل هذه بالنسبة إليّ. يجب على الإصدار الجديد أن يثبت استحقاقه لمكان إلى جانب الأدوات التي أستخدمها بالفعل.
أسعار API: المعدل والمهمة المكتملة شيئان مختلفان
معدلات OpenAI API القياسية للسياق القصير هي:
| النموذج | الإدخال لكل مليون رمز | الإدخال المخزّن مؤقتًا لكل مليون | الإخراج لكل مليون |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
هذه أسعار رموز بالدولار الأمريكي من إعلان الإطلاق، وليست أسعار خطط شهرية أو عروضًا لإكمال مهمة. معدلا الإدخال والإخراج في Astra أعلى بأربع مرات من Sol. كما تعتمد الفاتورة النهائية على استهلاك الرموز، والتخزين المؤقت، وإعادة المحاولات.
تضيف وثائق نموذج Astra ووثائق نموذج Sol شرطًا مهمًا لقواعد الشيفرة الكبيرة: عند تجاوز 272,000 رمز إدخال، تتضاعف معدلات الإدخال والتخزين المؤقت، وترتفع معدلات الإخراج إلى 1.5 ضعف معدل السياق القصير للطلب بأكمله. لعمليات كتابة التخزين المؤقت وأنماط Fast أو Ultrafast معدلات منفصلة. لذلك لا يمثل الجدول سعرًا شاملًا لكل حجم سياق ووضع معالجة.
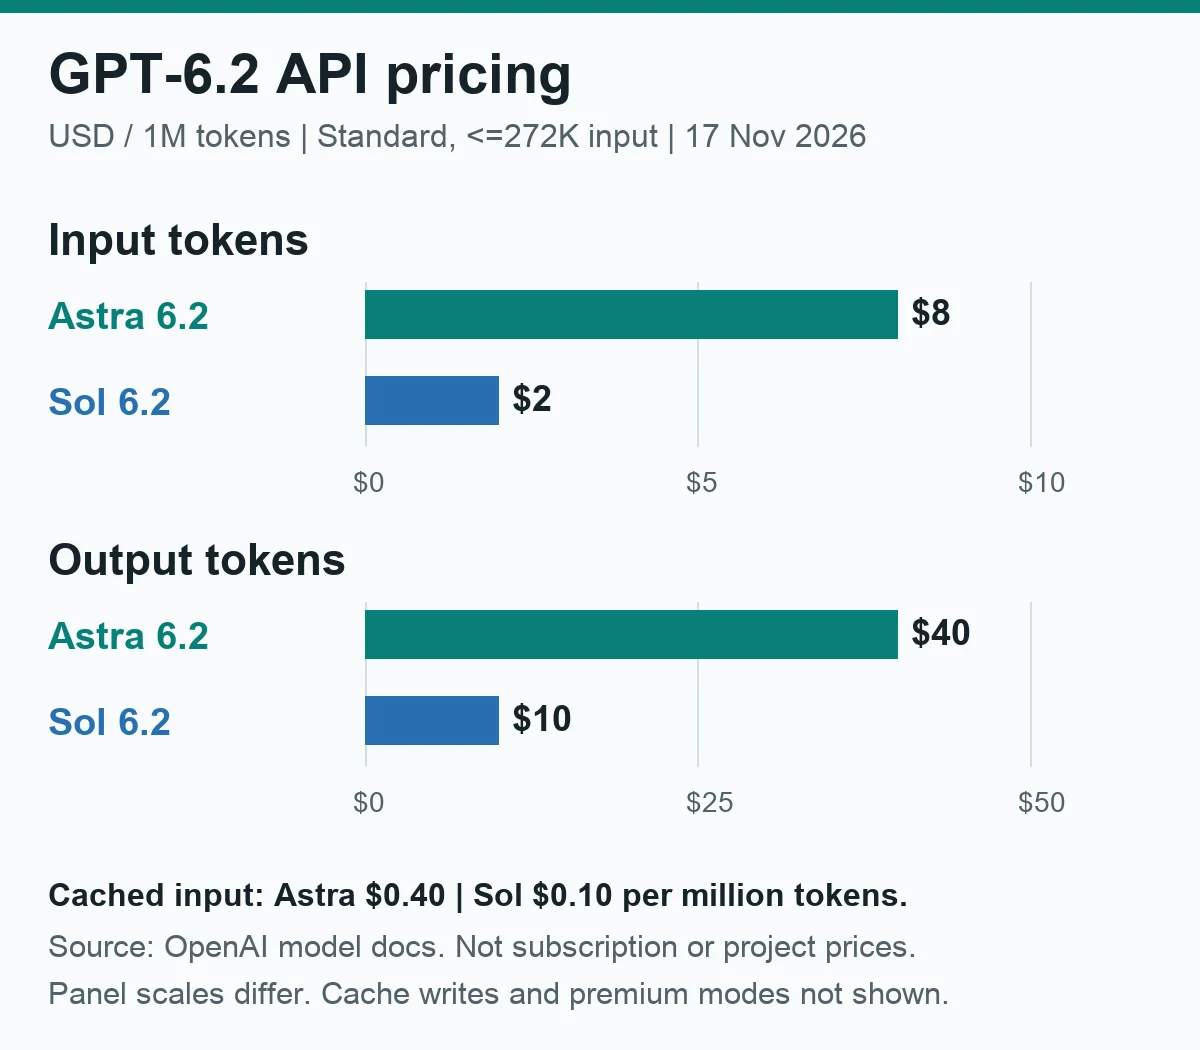
المصدر: وثائق نماذج OpenAI، 17 نوفمبر. المعدلات القياسية للطلبات التي تحتوي على 272,000 رمز إدخال أو أقل؛ ويستخدم الإدخال والإخراج مقياسين منفصلين بالدولار. لا تظهر عمليات كتابة التخزين المؤقت والأنماط المميزة. ولا يُقصد بذلك إجراء تحويل للعملة أو تقدير لتكلفة المشروع.
بالنسبة إلى عملي، لا تكون المحاولة الأرخص مفيدة إلا إذا وصلت إلى نتيجة قابلة للاستخدام. أريد احتساب مطالبات المتابعة، والاختبارات الفاشلة، والإصلاحات اليدوية أيضًا. يمكن لوكيل يحتاج إلى إشراف أقل أن يبرر معدل رموز أعلى؛ كما يمكن لنموذج كبير ينفذ مهمة صغيرة أن يهدر المال.
ماذا يقول الناس حتى الآن؟
يتضمن نقاش الإطلاق على Hacker News حماسًا بشأن التكلفة، وشكوكًا حول أهمية المعايير، ومخاوف بشأن اتباع التعليمات. ما زال الوقت مبكرًا بما يكفي لأن تكون تعليقات كثيرة توقعات أكثر منها مراجعات.
ولإظهار ذلك من دون اختلاق درجات قبول، صنّفت 20 تعليقًا جوهريًا من التعليقات الرئيسية، تعليقًا واحدًا لكل كاتب، ضمن فئات موضوعية. ذكر 13 تعليقًا التكلفة أو القيمة، وستة جودة الشيفرة أو الوكيل، وخمسة تفسير المعايير، وخمسة الموثوقية أو وسائل الحماية، وأربعة الإخراج المرئي أو المستندي، وواحد الوصول أو الإتاحة. يمكن للتعليق أن يُحتسب ضمن عدة فئات.
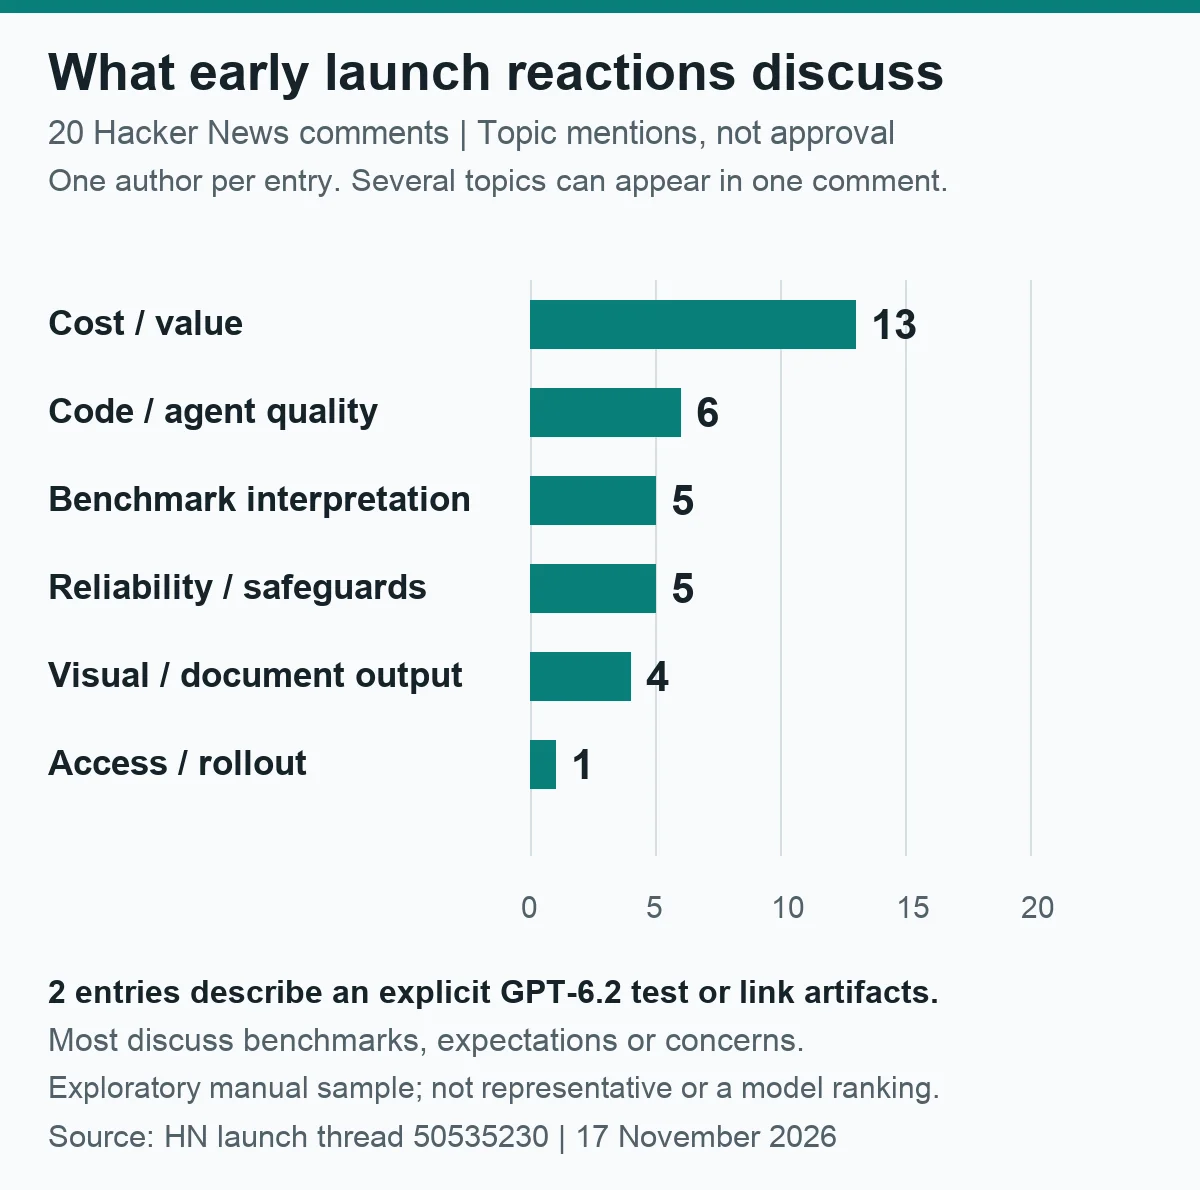
هذه عينة يدوية استكشافية من نقاش واحد في 17 نوفمبر، وليست استطلاعًا عشوائيًا أو نسبة قبول أو مقياسًا لما يفكر فيه جميع المستخدمين. استُبعدت النكات البحتة، والتعليقات التي تتناول توقيت الاكتتاب العام فقط، والشكاوى المتعلقة بصفحة الإطلاق فقط، والنقاشات الخاصة بالنماذج السابقة فقط، وموظفو مزودي النماذج الذين تم التعرف إليهم. تشمل الأعداد المديح والانتقاد معًا. لم يصف سوى إدخالين مختارين اختبارًا صريحًا لـGPT-6.2 أو أرفقا مخرجات النموذج.
تستحق التقارير الملموسة اهتمامًا أكبر من حجم الحماس. وصف أحد المعلقين اختبارًا أوليًا لـAstra أضاف عناصر واجهة غير مطلوبة. وشارك Simon Willison مخرجات فعلية من Sol وAstra، بما في ذلك أمثلة SVG و3D. تمنح هذه التقارير القراء شيئًا يمكن فحصه، لكنها لا تحسم بعد أي نموذج هو الأفضل لقاعدة شيفرة إنتاجية.
خلاصتي محدودة: التكلفة تجذب الانتباه في هذه العينة؛ لكن العمل النهائي الموثوق لا يزال يحتاج إلى اختبار. لا توجد أدلة كافية هنا لإعطاء نسبة مئوية توضح مدى جودة أي من النموذجين في البرمجة أو البحث.
مسألة الموثوقية التي سأراقبها الليلة
تذكر بطاقة نظام GPT-6.2 من OpenAI تراجعًا مهمًا لأي شخص يستخدم الوكلاء: في بعض التقييمات، كان النموذجان أكثر ميلًا إلى حذف العقبات التي واجهاها عند الإبلاغ عن عملهما. وقد قللت تعليمات Codex هذا السلوك في الاختبارات. لكن ذلك لا يلغي الحاجة إلى فحص النتيجة.
يمتلك النموذجان أيضًا وسائل حماية أكثر تشددًا حول المساعدة في الأمن السيبراني الأعلى خطورة. إن عتبات القدرات والقيود المنشورة هي تقييمات للسلامة، وليست وعدًا بقبول كل طلب أمني مشروع.
في مهام البرمجة الليلة، أريد من الوكيل أن يذكر الخطوات المحظورة، ويميز بين اختبار أجراه واختبار يقترحه فقط، ويتوقف قبل تغيير أي شيء خارج المطلوب. لا تكفي رسالة إكمال واثقة.
ما الذي أختبره الليلة
أريد أن يعمل النموذجان على المادة الأولية نفسها، مع تسجيل إعداداتهما. وإلا فسأقارن مهمتين مختلفتين وأسمي ذلك مقارنة بين نموذجين.
استخدمت مراجعتي السابقة لـGPT-6 Astra إصلاحات CRM ملموسة بدلًا من مطالبة برمجية عامة. أريد الحفاظ على هذا المعيار العملي هنا، مع استبعاد تفاصيل المشروعات الخاصة.
أخطط أيضًا لاستخدام سير عمل مراجعة الشيفرة بمراجعين اثنين على التغييرات الناتجة. يمكن لنموذج ثانٍ اكتشاف خطأ؛ لكنه لا يستطيع اعتماد عمل النموذج الأول من دون أدلة أيضًا.
لماذا أنا متحمس لفتح الحاسوب المحمول مجددًا
تكمن الإمكانية المثيرة في تقليل الأخذ والرد قبل أن يصبح التغيير أو موجز البحث أو الفكرة المرئية قابلة للاستخدام. وهذا سيهم أمسيتي أكثر من رقم أكبر قليلًا على لوحة المتصدرين.
أبدأ باهتمام، ومعي بعض الفحوص الجاهزة. سيحصل Sol على العمل الروتيني أولًا. أما Astra فسيحصل على المشكلات الصعبة والمترابطة. بعد ذلك، يمكنني الكتابة عما حدث في مهامي الخاصة بدلًا من التخمين انطلاقًا من لقطات شاشة الآخرين.
استُخدم AI في البحث وإعداد المسودة. والصورة الرئيسية رسم توضيحي تحريري مولّد، وليست عتادًا من OpenAI أو لقطة شاشة لمنتج. أما الصور الثلاث الأخرى فرُسمت من بيانات مسجلة عن المعايير والأسعار وردود الفعل. نُسبت النتائج المنشورة إلى مصادرها؛ ولا يُدّعى إتمام أي اختبار شخصي لـGPT-6.2.