Claude Fable 5.2 让我感兴趣,是因为我已经在使用 Fable 处理那些难以拆分成小型、相互隔离问题的工作。我用它制定复杂计划、交流想法、研究问题,并处理一个功能会触及系统多个部分的代码库。
一个小函数通常并不是最难的部分。真正困难的是理解还必须修改什么,以及哪些部分必须继续正常运行。
Anthropic 于 2026 年 11 月 9 日发布了 Fable 5.2。早期结果显示,它很适合这类工作。同时,这些结果也说明,我不会把每项任务都交给它并使用最高强度。这是一篇围绕我现有 Fable 工作流程展开的发布分析,并不声称我独立对 5.2 进行了基准测试。
研究信息核查于 2026 年 11 月 10 日完成。头图是 AI 生成的编辑插图,并非 Anthropic 界面。下方图表使用的是记录的评估数据,而不是生成的数据。
Claude Fable 5.2 有哪些新内容?
Fable 5.2 是 Anthropic 面向高难度推理和长时间技术工作的全新模型。其规格列出了 100 万 token 的上下文窗口、最多 128,000 个输出 token,并支持文本和图像输入以及文本输出。较大的上下文窗口意味着它可以接收大量材料;但这并不保证它能正确使用每一个细节。Claude Fable 5.2 specifications
Anthropic 表示,其输出生成速度比 Fable 5.1 最多快 30%。这是关于 token 生成速度的说法,并不意味着整个项目一定会提前 30% 完成。
Fable 和 Mythos 5.2 共享底层模型,但在安全防护和访问权限方面有所不同。Mythos 面向经过验证的组织,应用领域包括网络安全和生命科学。仅限 Mythos 的结果不应被描述为所有 Fable 用户都能复现的结果。Anthropic: Fable 5.2 and Mythos 5.2 launch
为什么我在功能跨越整个代码库时使用 Fable
想象一下,为文档上传流程增加一个审批步骤。描述这个按钮很容易,但要实现可靠的功能,就需要更多思考。
API 必须检查谁有权审批。数据库必须保存决定。后台任务必须避免重复发送同一条通知。界面需要显示待处理、已批准和失败状态。测试必须覆盖两个人同时操作的情况。
我希望模型在开始编辑之前理解这些关联。分别修复每个文件,可能会留下一个只在某个页面正常工作、但在其他地方失败的功能。
规划并质疑一个想法
这正是我喜欢把 Fable 当作讨论伙伴使用的地方。我可以描述目标、探索不同方案,并要求它质疑各种假设。我想要的是一份能够识别依赖关系和失败场景的计划,而不是一长串听起来井然有序的任务清单。
例如,模型应该解释审批逻辑是属于现有工作流,还是需要单独的服务。它还应该能够告诉我,较小的改动是否已经足够。
为实现提供依据的研究
当研究能够改变决策时,它才有价值。我希望模型比较文档、解释权衡,并区分已经确认的限制和猜测。
我关注的标准很实际:我能否追溯来源、核查结论,并理解哪些内容仍然不确定?无论模型是什么,缺少这些证据的自信总结都不够。
编码基准测试说明了什么?
Anthropic 的发布表显示,FrontierCode 2.0 的得分为 49.1%,而 Fable 5.1 为 32.4%,Opus 5.5 为 45.5%。前两个 Fable 结果使用 xhigh 强度;Opus 使用 max。这些是精选的最高努力结果,并不是等成本比较。
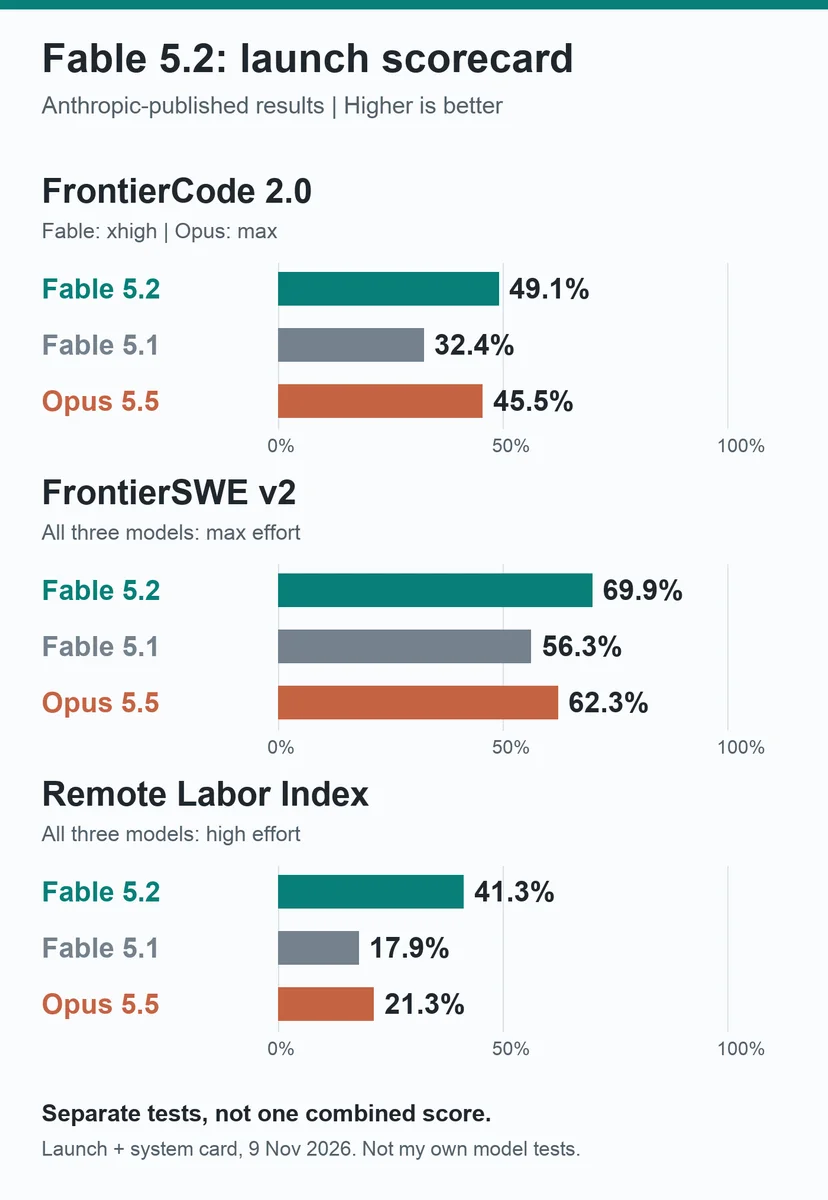
每个面板衡量的任务都不同。不要对这些百分比求平均。根据系统卡,FrontierSWE v2 使用 max 强度;Remote Labor Index 的 Claude 运行使用 high 强度、200,000 个 token 的上下文和 32,000 个 token 的响应上限。Anthropic system card, capabilities section
FrontierSWE 与我的兴趣尤其相关。其作者描述了 34 项长期工程和研究任务,每项任务有 20 小时预算。这比完成一个简短函数更接近持续性问题解决。不过,它仍然是特定的测试环境,并不能预测我的代码库会得到什么结果。FrontierSWE v2 methodology
Remote Labor Index 的结果也很容易被夸大。在这些项目中取得 41.3% 的得分,并不意味着 Fable 可以取代 41.3% 的工作岗位。这只是它在一组明确交付物上的结果。
独立测试者发现了什么?
首批公开测试显示出强大的能力,但也存在重要限制。目前,它们还不足以形成关于生产代码库的广泛共识。
Artificial Analysis 在我查看的快照中,将 Fable 5.2 在 max 强度下的 Intelligence Index 得分四舍五入为 65。其 high 强度结果为 62。成本差异相当明显,下一张图会展示这一点。这是独立于 Anthropic 发布表的另一套评估体系。Artificial Analysis: model results
Spring Prompt 于 11 月 10 日进行了自己的商业测试。Fable 在调查分析和模拟广告预算测试中领先,但 GPT-6.1 Sol 在事实性产品列表方面略微更可靠,而且每条列表的成本低得多。大多数测试只运行了一次;产品列表测试重复了三次。该团队明确表示没有对编码代理进行基准测试。我将其理解为一个早期信号:值得测试分析密集型工作,而不是证明它更适合软件迁移。Spring Prompt: Fable 5.2 review and test limits
Simon Willison 在一次小规模 SVG 生成实验中发现了一个有用的警示。Xhigh 生成了结果,而 max 花费了 128,000 个 token 的上限进行思考,最终没有返回图像。这是一次被报告的实验,并不代表普遍失败率。但它足以让人质疑“最高设置总能产生最佳答案”这一假设。Simon Willison: first Fable 5.2 experiments
它的成本是多少,哪种强度级别更合理?
标准 API 定价为每百万输入 token 8 美元、每百万输出 token 40 美元。这比 Fable 5.1 的 10 美元/50 美元低 20%。Opus 5.5 的价格为 4 美元/20 美元。Fable 5.2 的缓存读取价格为每百万 token 0.20 美元;缓存写入则有单独收费。这些是 API 价格,不是订阅额度。Anthropic pricing
可选的快速模式价格为每百万输入/输出 token 16 美元/80 美元。Anthropic 声称,该模式下 token 生成速度最多可提高 2.5 倍。更快的输出速度和更低的 token 单价,与完成任务的最终成本是不同的概念。
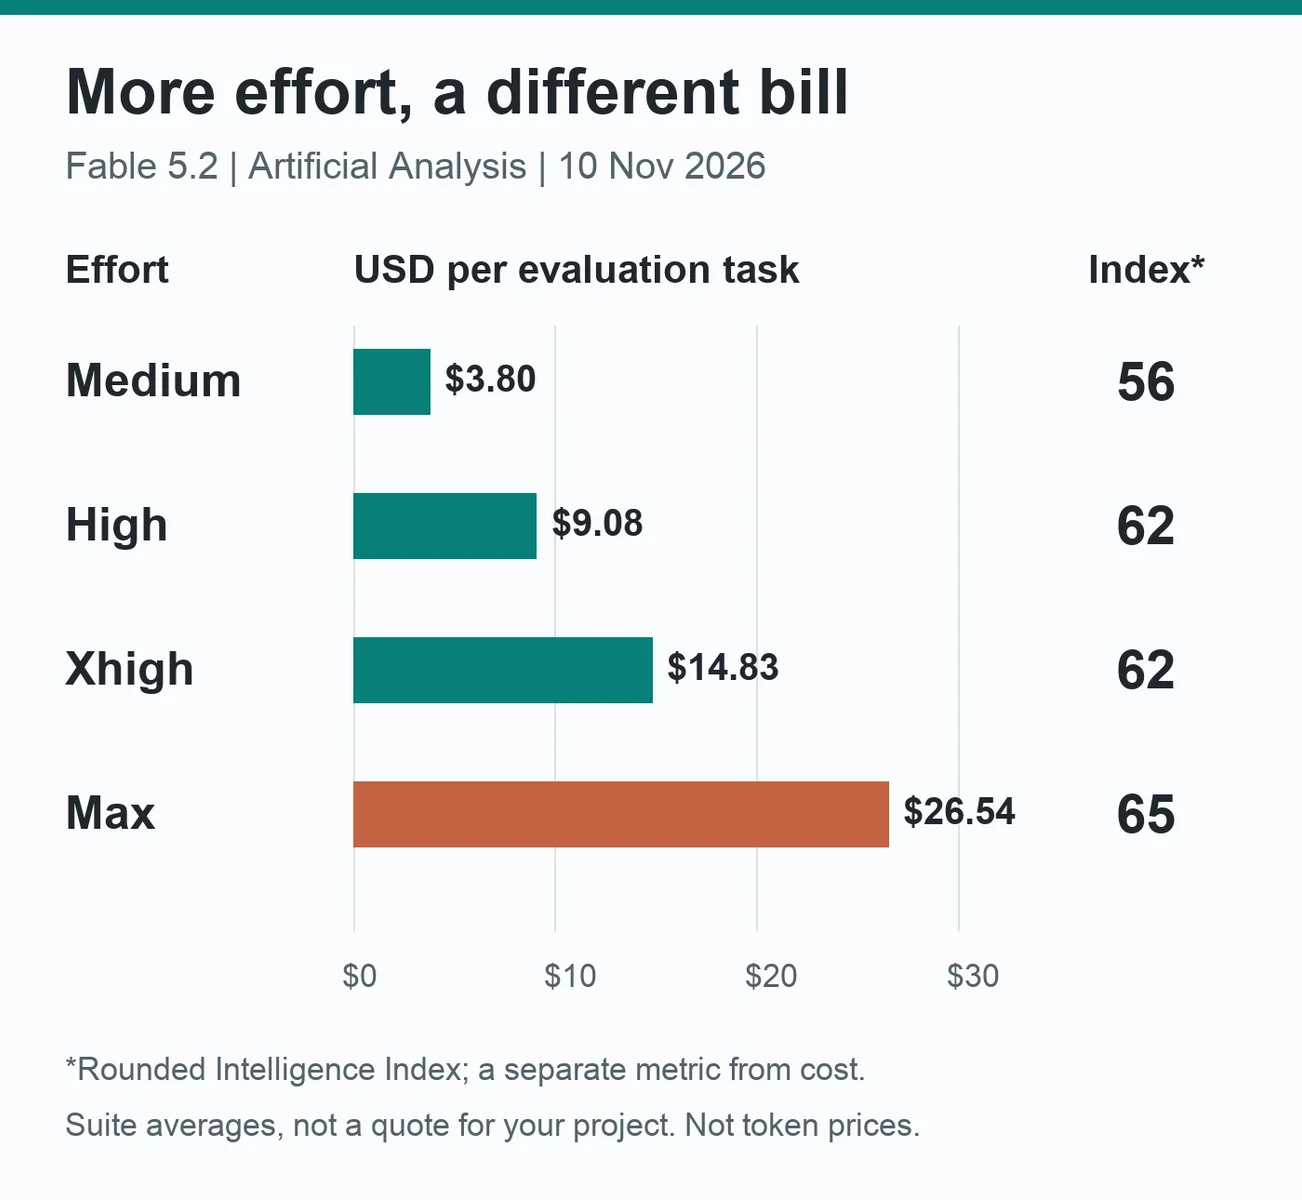
Artificial Analysis 快照,11 月 10 日:medium 为 3.80 美元,high 为 9.08 美元,xhigh 为 14.83 美元,max 为每项 Intelligence Index 任务 26.54 美元。这些是评估套件的平均值,并不是某个功能或研究项目的报价。四者四舍五入后的指数得分分别为 56、62、62 和 65。Artificial Analysis: effort and cost comparison
更高的强度需要理由
Anthropic 的 API 默认将 Fable 5.2 设置为 high,而其发布页面表示 Claude 应用和 Claude Code 默认使用 medium。思考始终开启。强度设置控制模型为响应投入多少工作,并不只是一个让答案变长的开关。
Anthropic 的强度指南建议 API 从 high 开始,并将 max 保留给那些时间和 token 不那么重要的少数任务。我会在具有代表性的工作上比较不同设置,只有当结果值得时才支付更多费用。Claude effort guidance
我会如何组织一次复杂的编码会话
我的起点会是明确的目标,以及要求模型检查现有系统。我希望在会话中得到四样东西:
一个起始提示可以是:
text 在编辑之前,先通过现有代码库追踪这个功能。 梳理它的依赖关系,并解释主要失败场景。 提出最小但完整的改动方案,以及能够发现错误实现的测试。 保留无关工作。涉及迁移、发布或部署时先询问。 完成后,报告修改了什么、验证了什么,以及哪些内容仍未验证。
我不会复制那些赋予模型对客户代码库不受限制所有权的提示。Anthropic 的提示指南警告说,即使其他指令限制了范围,所有权措辞也可能鼓励模型进行额外修改。因此,应明确边界并检查 diff。Prompting Claude Fable 5.2
更便宜的模型也可以处理常规步骤,而让 Fable 协助做困难决策。Claude Code 的 advisor 工具支持这种安排,但需要满足相应的访问和计费条件。建议仍然会消耗 token;委派并不是免费的。Claude Code advisor documentation
我的看法:在理解系统很重要的地方使用它
我对 Fable 5.2 感兴趣,是因为规划、研究和跨代码库修改本来就是我使用 Fable 的原因。我希望它帮助我连接各个部分,并在我花时间实现之前质疑某种方案。
但这并不意味着它会自动成为我处理每次编辑的首选。Anthropic 仍然建议,大多数编码和知识工作从 Opus 5.5 开始。我的 Opus 5.5 overview 和此前的 Fable 5.1 review 为这一选择提供了背景。
对于困难工作,我希望得到清晰的计划、连贯的实现,以及证明其有效的证据。我会保留 multi-agent code review workflow 中描述的独立检查,而不是把更强的模型当作最终审查者。
Fable 5.2 值得在这些更困难的任务上进行测试。真正有用的问题是:它是否能让我少留下未完成的工作,并交付一个我可以验证的结果。