Claude Fable 5.2 цікавить мене, тому що я вже використовую Fable для роботи, яку складно розділити на маленькі ізольовані запитання. Я використовую його, щоб створювати складні плани, обговорювати ідеї, досліджувати проблему та працювати з кодовими базами, де одна функція зачіпає кілька частин системи.
Невелика функція рідко є найскладнішою частиною. Складність полягає в тому, щоб зрозуміти, що ще потрібно змінити, а що має продовжити працювати.
Anthropic випустила Fable 5.2 9 листопада 2026 року. Ранні результати виглядають багатообіцяльно саме для такого типу роботи. Вони також показують, чому я не став би надсилати до нього кожне завдання, використовуючи максимальний рівень зусиль. Це аналіз запуску, побудований навколо мого наявного робочого процесу з Fable, а не твердження про те, що я самостійно протестував 5.2.
Дослідження перевірено 10 листопада 2026 року. Головне зображення — редакційна ілюстрація, створена AI, а не інтерфейс Anthropic. Наведені нижче діаграми використовують зафіксовані дані оцінювання, а не згенеровані числа.
Що нового в Claude Fable 5.2?
Fable 5.2 — це нова модель Anthropic для складних міркувань і тривалої технічної роботи. У її специфікаціях зазначено контекстне вікно на один мільйон токенів, до 128 000 вихідних токенів, а також підтримку текстового й графічного введення з текстовим виведенням. Велике контекстне вікно означає, що модель може прийняти значний обсяг матеріалу; це не гарантує, що вона правильно використає кожну деталь. Специфікації Claude Fable 5.2
Anthropic стверджує, що генерація виведення до 30% швидша, ніж у Fable 5.1. Це твердження стосується генерації токенів, а не обіцянка, що весь проєкт завершиться на 30% швидше.
Fable і Mythos 5.2 використовують одну базову модель, але відрізняються запобіжними заходами та доступом. Mythos призначена для перевірених організацій у таких сферах, як кібербезпека та науки про життя. Результат, доступний лише в Mythos, не слід подавати як такий, що його може відтворити кожен користувач Fable. Anthropic: запуск Fable 5.2 і Mythos 5.2
Чому я використовую Fable, коли функція охоплює всю кодову базу
Уявімо, що потрібно додати етап затвердження до процесу завантаження документів. Кнопку легко описати. Надійна реалізація потребує більшого обмірковування.
API має перевіряти, хто може затверджувати. База даних повинна зберігати рішення. Фонове завдання має не надсилати те саме сповіщення двічі. Інтерфейс потребує станів «очікує», «затверджено» та «помилка». Тести мають охоплювати ситуацію, коли двоє людей діють одночасно.
Я хочу, щоб модель зрозуміла ці зв’язки до початку редагування. Виправлення кожного файлу окремо може залишити функцію, яка працює на одному екрані, але ламається в іншому місці.
Планування та критичний аналіз ідеї
Саме тут мені подобається використовувати Fable як партнера для обговорення. Я можу описати результат, розглянути різні підходи й попросити модель поставити під сумнів припущення. Мені потрібен план, який визначає залежності та сценарії відмови, а не довгий список завдань, що лише виглядає організовано.
Наприклад, модель має пояснити, чи належить затвердження до наявного процесу, чи для нього потрібен окремий сервіс. Вона також має вміти сказати мені, що достатньо меншої зміни.
Дослідження, яке впливає на реалізацію
Дослідження корисне тоді, коли воно змінює рішення. Я хочу, щоб модель порівнювала документацію, пояснювала компроміси та відокремлювала підтверджене обмеження від припущення.
Мене цікавить практичний стандарт: чи можу я перейти до джерела, перевірити твердження та зрозуміти, що залишається невизначеним? Впевненого резюме без таких доказів недостатньо, незалежно від моделі.
Що показують бенчмарки програмування?
У таблиці запуску Anthropic зазначено 49,1% на FrontierCode 2.0 проти 32,4% у Fable 5.1 і 45,5% у Opus 5.5. Обидва результати Fable отримано з рівнем зусиль xhigh; Opus використовував max. Це відібрані результати з максимальними зусиллями, а не порівняння за однакової вартості.
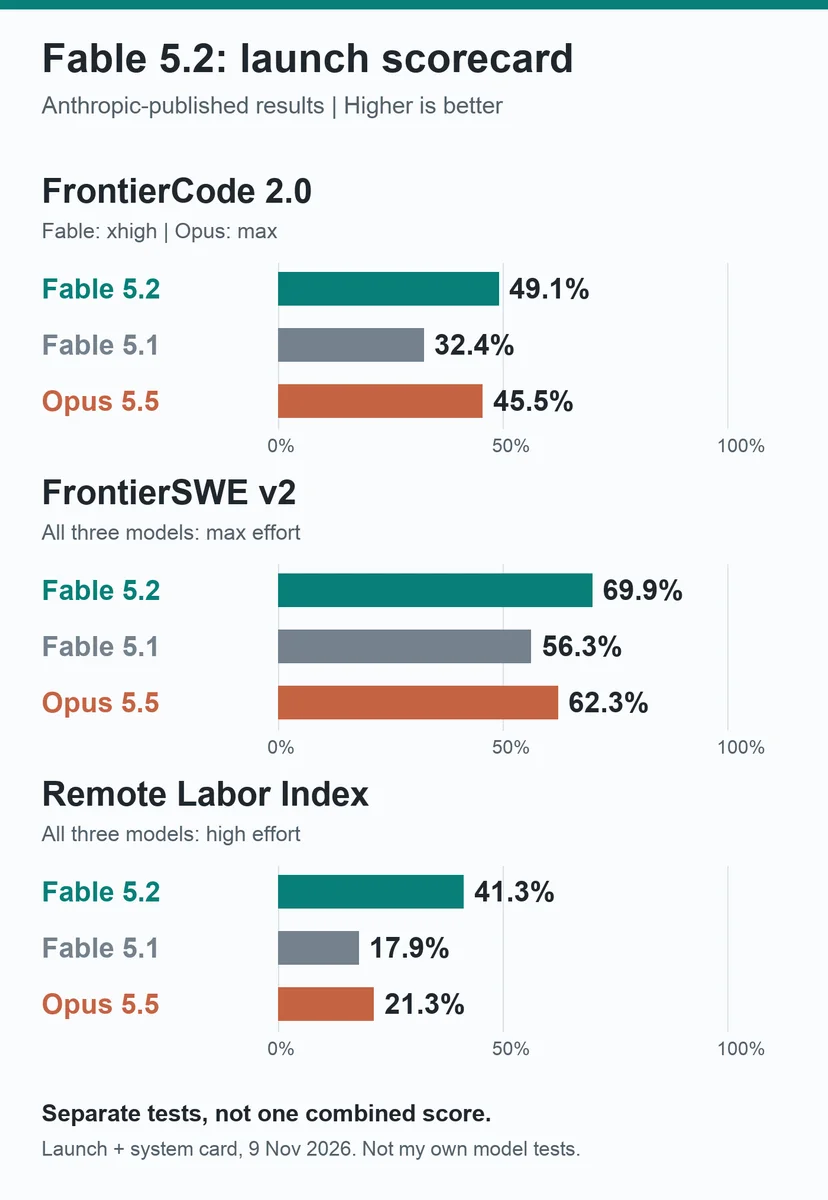
Кожна панель вимірює окреме завдання. Не усереднюйте відсотки. FrontierSWE v2 використовує максимальний рівень зусиль; запуски Claude у Remote Labor Index використовують високий рівень, контекст на 200 000 токенів і обмеження відповіді у 32 000 токенів, згідно із системною картою. Системна карта Anthropic, розділ про можливості
FrontierSWE особливо відповідає моїм інтересам. Його автори описують 34 тривалі інженерні та дослідницькі завдання з бюджетом 20 годин на кожне. Це ближче до тривалого розв’язання проблем, ніж виконання однієї короткої функції. Водночас це конкретне тестове середовище, а не прогноз для моїх репозиторіїв. Методологія FrontierSWE v2
Результат Remote Labor Index також легко перебільшити. Оцінка 41,3% на цих проєктах не означає, що Fable може замінити 41,3% робочих місць. Це результат на визначеному наборі результатів роботи.
Що виявляють незалежні тестувальники?
Перші публічні тести вказують на значні можливості, але також на важливі обмеження. Поки що вони не становлять широкого консенсусу щодо робочих кодових баз.
Artificial Analysis у перевіреному мною знімку вказує для Fable 5.2 округлений показник Intelligence Index 65 за максимального рівня зусиль. Результат за високого рівня зусиль становить 62. Різниця у вартості значна, як показує наступна діаграма. Це окремий набір оцінювань, відмінний від таблиці запуску Anthropic. Artificial Analysis: результати моделі
Spring Prompt провела власні бізнес-тести 10 листопада. Fable очолила її тести з аналізу опитувань і симуляції рекламного бюджету, але GPT-6.1 Sol виявилася трохи надійнішою у фактичних описах товарів і значно дешевшою за кожен опис. Більшість цих тестів запускали один раз; тести описів товарів використовували три повторення. Команда прямо зазначає, що не тестувала coding agents. Я сприймаю це як ранню причину перевірити роботу, пов’язану з аналізом, а не як доказ кращих міграцій програмного забезпечення. Spring Prompt: огляд Fable 5.2 та обмеження тестів
Simon Willison виявив корисне застереження під час невеликого експерименту з генерацією SVG. Xhigh створив результат, тоді як max витратив ліміт у 128 000 токенів на міркування й не повернув зображення. Це один описаний експеримент, а не загальний показник відмов. Цього достатньо, щоб поставити під сумнів припущення, ніби найвищий рівень завжди дає найкращу відповідь. Simon Willison: перші експерименти з Fable 5.2
Скільки це коштує і який рівень зусиль має сенс?
Стандартна ціна API становить $8 за мільйон вхідних токенів і $40 за мільйон вихідних токенів. Це на 20% менше, ніж $10/$50 у Fable 5.1. Opus 5.5 коштує $4/$20. Читання кешу для Fable 5.2 коштує $0,20 за мільйон токенів; запис у кеш оплачується окремо. Це ціни API, а не обсяги, включені до підписки. Ціни Anthropic
Необов’язковий швидкий режим коштує $16/$80 за мільйон вхідних/вихідних токенів. Anthropic стверджує, що в цьому режимі генерація токенів може бути до 2,5 раза швидшою. Швидше виведення та нижча ціна за токен — це окремі речі порівняно з кінцевою вартістю виконання завдання.
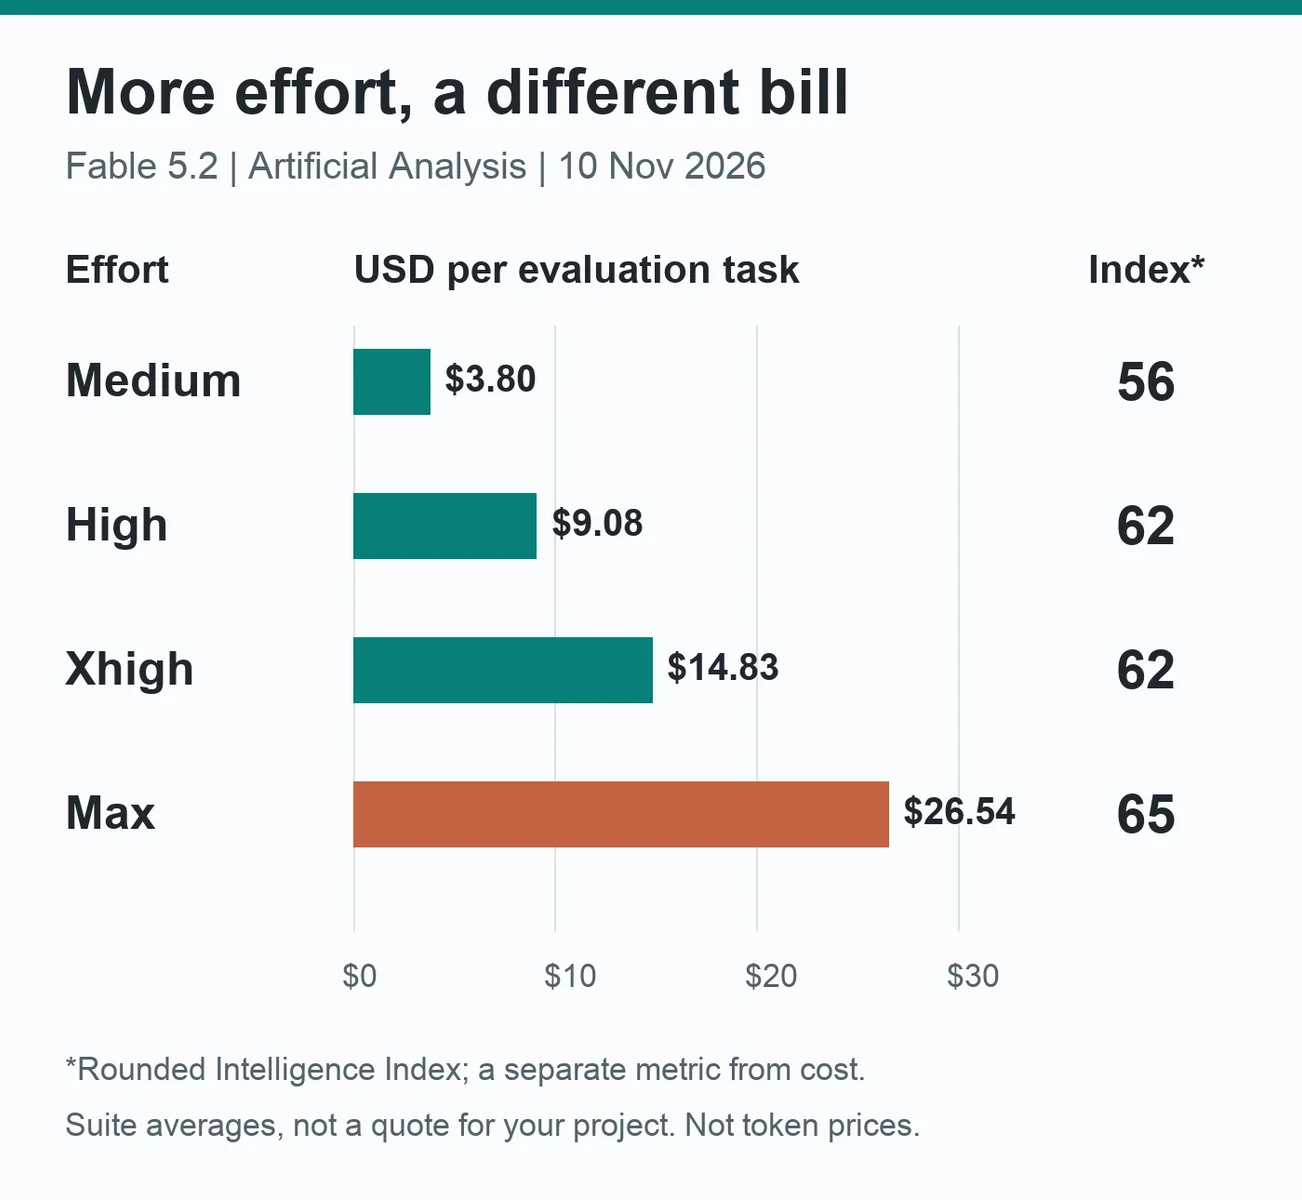
Знімок Artificial Analysis, 10 листопада: medium — $3,80, high — $9,08, xhigh — $14,83, max — $26,54 за одне завдання Intelligence Index. Це середні значення для набору оцінювань, а не ціни конкретної функції чи дослідницького проєкту. Округлені показники індексу становлять відповідно 56, 62, 62 і 65. Artificial Analysis: порівняння рівнів зусиль і вартості
Вищий рівень зусиль має мати причину
API Anthropic за замовчуванням використовує high для Fable 5.2, тоді як сторінка запуску зазначає, що застосунки Claude і Claude Code за замовчуванням використовують medium. Міркування завжди ввімкнені. Налаштування зусиль визначає, скільки роботи модель вкладає у відповідь; це не просто перемикач для довших відповідей.
Посібник Anthropic щодо зусиль рекомендує high як початковий рівень для API та радить залишати max для рідкісних завдань, де час і токени мають менше значення. Я б порівняв налаштування на репрезентативній роботі, а потім платив більше лише тоді, коли результат це виправдовує. Рекомендації Claude щодо зусиль
Як я структурував би складну сесію програмування
Я почав би з чіткого результату та прохання перевірити наявну систему. Від сесії я хотів би отримати чотири речі:
Початковий prompt міг би виглядати так:
text Before editing, trace this feature through the existing codebase. Map its dependencies and explain the main failure cases. Propose the smallest complete change and the tests that would catch a broken implementation. Preserve unrelated work. Ask before migrations, publication or deployment. Afterwards, report what changed, what you verified and what remains unverified.
Я не копіював би prompts, які надають моделі необмежене право власності на клієнтську кодову базу. Посібник Anthropic із prompting попереджає, що формулювання про право власності може заохочувати додаткові зміни, навіть якщо інші інструкції обмежують область роботи. Це причина чітко визначати межі та перевіряти diff. Prompting Claude Fable 5.2
Дешевша модель також може виконувати рутинні кроки, тоді як Fable допомагатиме зі складними рішеннями. Інструмент advisor у Claude Code підтримує такий підхід, але має умови доступу й оплати. Поради все одно споживають токени; делегування не є безкоштовним. Документація Claude Code advisor
Моя думка: використовуйте її там, де важливо розуміти систему
Fable 5.2 цікавить мене, тому що планування, дослідження та зміни в усій кодовій базі вже є причинами, через які я звертаюся до Fable. Я хочу отримувати допомогу у поєднанні частин і критичному аналізі підходу до того, як витрачати час на його реалізацію.
Це не робить її автоматичним вибором для кожного редагування. Anthropic і далі рекомендує починати більшість завдань із програмування та роботи зі знаннями з Opus 5.5. Мій огляд Opus 5.5 і попередній огляд Fable 5.1 дають контекст для такого вибору.
Для складної роботи мені потрібні чіткий план, узгоджена реалізація та докази того, що все працює. Я зберіг би незалежні перевірки, описані в моєму робочому процесі multi-agent code review, а не сприймав би сильнішу модель як остаточного рев’юера.
Fable 5.2 варто протестувати на складніших завданнях. Корисне питання полягає в тому, чи залишає вона мені менше невиконаної роботи та результат, який я можу перевірити.