Claude Fable 5.2 ilgimi çekiyor çünkü Fable'ı zaten küçük, yalıtılmış sorulara bölmenin zor olduğu işler için kullanıyorum. Karmaşık planlar oluşturmak, fikirleri karşılıklı değerlendirmek, bir problemi araştırmak ve tek bir özelliğin sistemin birkaç bölümüne dokunduğu kod tabanları üzerinde çalışmak için ondan yararlanıyorum.
Küçük bir fonksiyon nadiren zor kısımdır. Zor olan, başka nelerin değişmesi gerektiğini ve nelerin çalışmaya devam etmesi gerektiğini anlamaktır.
Anthropic, Fable 5.2'yi 9 Kasım 2026'da yayımladı. İlk sonuçlar bu tür işler için umut verici görünüyor. Ayrıca her görevi en yüksek çabayla ona göndermemem gerektiğini de gösteriyor. Bu, 5.2'yi bağımsız olarak benchmark'ladığım iddiasına değil, mevcut Fable iş akışım etrafında şekillenen bir lansman analizine dayanıyor.
Araştırma 10 Kasım 2026'da kontrol edildi. Kapak görseli, Anthropic arayüzü değil, AI tarafından oluşturulmuş editoryal bir illüstrasyondur. Aşağıdaki grafiklerde oluşturulmuş sayılar değil, kaydedilmiş değerlendirme verileri kullanılıyor.
Claude Fable 5.2'de neler yeni?
Fable 5.2, Anthropic'in zorlu akıl yürütme ve uzun süren teknik çalışmalar için yeni modelidir. Teknik özelliklerinde bir milyon token'lık bağlam penceresi, 128.000'e kadar çıktı token'ı ve metin ile görsel girdiyi, metin çıktısıyla destekleme yer alıyor. Büyük bir bağlam penceresi, önemli miktarda materyali kabul edebileceği anlamına gelir; her ayrıntıyı doğru kullanacağını garanti etmez. Claude Fable 5.2 specifications
Anthropic, çıktı üretiminin Fable 5.1'e göre %30'a kadar daha hızlı olduğunu söylüyor. Bu, token üretimiyle ilgili bir iddiadır; tüm projenin %30 daha kısa sürede tamamlanacağına dair bir vaat değildir.
Fable ve Mythos 5.2 aynı temel modeli paylaşır, ancak güvenlik önlemleri ve erişim bakımından farklıdır. Mythos; siber güvenlik ve yaşam bilimleri gibi alanlarda doğrulanmış kuruluşlar içindir. Yalnızca Mythos'a ait bir sonuç, her Fable kullanıcısının yeniden üretebileceği bir şeymiş gibi sunulmamalıdır. Anthropic: Fable 5.2 and Mythos 5.2 launch
Bir özellik kod tabanının tamamına yayıldığında neden Fable kullanıyorum?
Bir belge yükleme iş akışına onay adımı eklediğinizi düşünün. Butonu tanımlamak kolaydır. Güvenilir bir uygulama daha fazla düşünmeyi gerektirir.
API, kimin onay verebileceğini kontrol etmelidir. Veritabanı kararı saklamalıdır. Bir arka plan işi aynı bildirimi iki kez göndermekten kaçınmalıdır. Arayüzde beklemede, onaylandı ve başarısız durumları bulunmalıdır. Testler, iki kişinin aynı anda işlem yapmasını kapsamalıdır.
Modelin düzenlemeye başlamadan önce bu bağlantıları anlamasını istiyorum. Her dosyayı ayrı ayrı düzeltmek, bir ekranda çalışan ancak başka bir yerde başarısız olan bir özellikle sonuçlanabilir.
Bir fikri planlamak ve sorgulamak
Fable'ı bir tartışma ortağı olarak kullanmayı sevdiğim yer burasıdır. Sonucu açıklayabilir, farklı yaklaşımları inceleyebilir ve varsayımlara meydan okumasını isteyebilirim. Düzenli görünen uzun bir görev listesi yerine, bağımlılıkları ve hata durumlarını belirleyen bir plan istiyorum.
Örneğin model, onayın mevcut iş akışına mı ait olması gerektiğini yoksa ayrı bir servis mi gerektirdiğini açıklamalıdır. Ayrıca daha küçük bir değişikliğin yeterli olduğunu da söyleyebilmelidir.
Bir uygulamayı yönlendiren araştırma
Araştırma, bir kararı değiştirdiğinde faydalıdır. Modelin dokümantasyonu karşılaştırmasını, ödünleşimleri açıklamasını ve doğrulanmış bir sınırlamayı tahminden ayırmasını istiyorum.
Önemsediğim standart pratiktir: Kaynağı takip edebilir, iddiayı kontrol edebilir ve hangi noktaların belirsiz kaldığını anlayabilir miyim? Model ne olursa olsun, bu kanıt olmadan sunulan kendinden emin bir özet yeterli değildir.
Kodlama benchmark'ları ne gösteriyor?
Anthropic'in lansman tablosu, FrontierCode 2.0'da %49,1 sonuç bildiriyor; Fable 5.1 %32,4 ve Opus 5.5 %45,5 seviyesinde. İki Fable sonucu xhigh effort kullanıyor; Opus ise max kullanıyor. Bunlar eşit maliyetli bir karşılaştırma değil, seçilmiş en iyi çaba sonuçlarıdır.
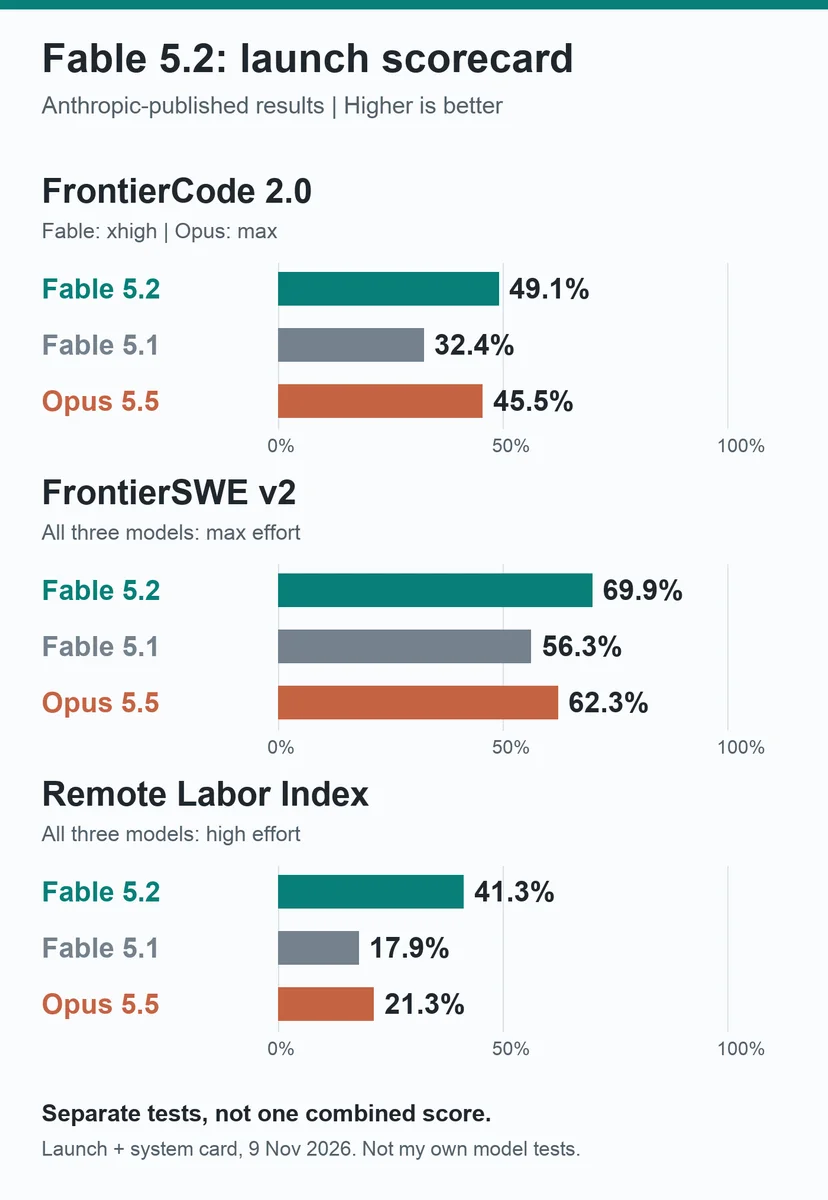
Her panel farklı bir görevi ölçer. Yüzdelerin ortalamasını almayın. FrontierSWE v2 max effort kullanır; sistem kartına göre Remote Labor Index Claude çalıştırmaları high effort, 200.000 token'lık bağlam ve 32.000 token'lık yanıt sınırı kullanır. Anthropic system card, capabilities section
FrontierSWE özellikle ilgimi çekiyor. Yazarları, görev başına 20 saatlik bütçeyle 34 uzun mühendislik ve araştırma görevini tanımlıyor. Bu, tek bir kısa fonksiyonu tamamlamaktan çok sürdürülebilir problem çözmeye yakındır. Yine de bu, depolarım için bir öngörü değil, belirli bir test ortamıdır. FrontierSWE v2 methodology
Remote Labor Index sonucu da kolayca abartılabilir. Bu projelerdeki %41,3'lük skor, Fable'ın işlerin %41,3'ünün yerini alabileceği anlamına gelmez. Bu, tanımlanmış bir teslimat kümesi üzerindeki bir sonuçtur.
Bağımsız test uzmanları ne buluyor?
İlk kamuya açık testler, önemli sınırlamalarla birlikte güçlü bir yeteneğe işaret ediyor. Henüz üretim kod tabanları hakkında geniş bir fikir birliği oluşturacak düzeyde değiller.
Artificial Analysis, kontrol ettiğim anlık görüntüde Fable 5.2'yi max effort seviyesinde yuvarlanmış 65 Intelligence Index skoruyla listeliyor. High-effort sonucu 62. Maliyet farkı, sonraki grafikte görüldüğü gibi önemli. Bu, Anthropic'in lansman tablosundan ayrı bir değerlendirme paketidir. Artificial Analysis: model results
Spring Prompt, 10 Kasım'da kendi iş testlerini gerçekleştirdi. Fable, anket analizi ve simüle edilmiş reklam bütçesi testlerinde öne çıktı; ancak GPT-6.1 Sol, gerçeklere dayalı ürün listelerinde biraz daha güvenilir ve liste başına çok daha ucuzdu. Bu testlerin çoğu bir kez çalıştırıldı; ürün listeleme testlerinde üç tekrar kullanıldı. Ekip, coding agents benchmark'ı yapmadığını açıkça belirtiyor. Bunu, analiz ağırlıklı işleri test etmek için erken bir neden olarak görüyorum; daha iyi yazılım geçişlerinin kanıtı olarak değil. Spring Prompt: Fable 5.2 review and test limits
Simon Willison, küçük bir SVG oluşturma deneyinde faydalı bir uyarı buldu. Xhigh bir sonuç üretirken max, 128.000 token'lık sınırını düşünerek harcadı ve görsel döndürmedi. Bu, genel bir başarısızlık oranı değil, bildirilen tek bir deneydir. En yüksek ayarın her zaman en iyi yanıtı ürettiği varsayımını sorgulamak için yeterlidir. Simon Willison: first Fable 5.2 experiments
Maliyeti ne kadar ve hangi effort seviyesi mantıklı?
Standart API fiyatlandırması milyon input token başına 8 dolar ve milyon output token başına 40 dolar. Bu, Fable 5.1'in 10/50 dolarlık fiyatına göre %20 daha düşük. Opus 5.5'in fiyatı 4/20 dolar. Fable 5.2 için cache okumaları milyon token başına 0,20 dolar; cache yazımları için ayrı ücretler uygulanır. Bunlar API fiyatlarıdır, abonelik kapsamları değildir. Anthropic pricing
İsteğe bağlı fast mode, milyon input/output token başına 16/80 dolara mal olur. Anthropic, bu modda token üretiminin 2,5 kata kadar daha hızlı olduğunu iddia ediyor. Daha hızlı çıktı ve token başına daha düşük fiyat, bir görevi tamamlamanın nihai maliyetinden ayrı konulardır.
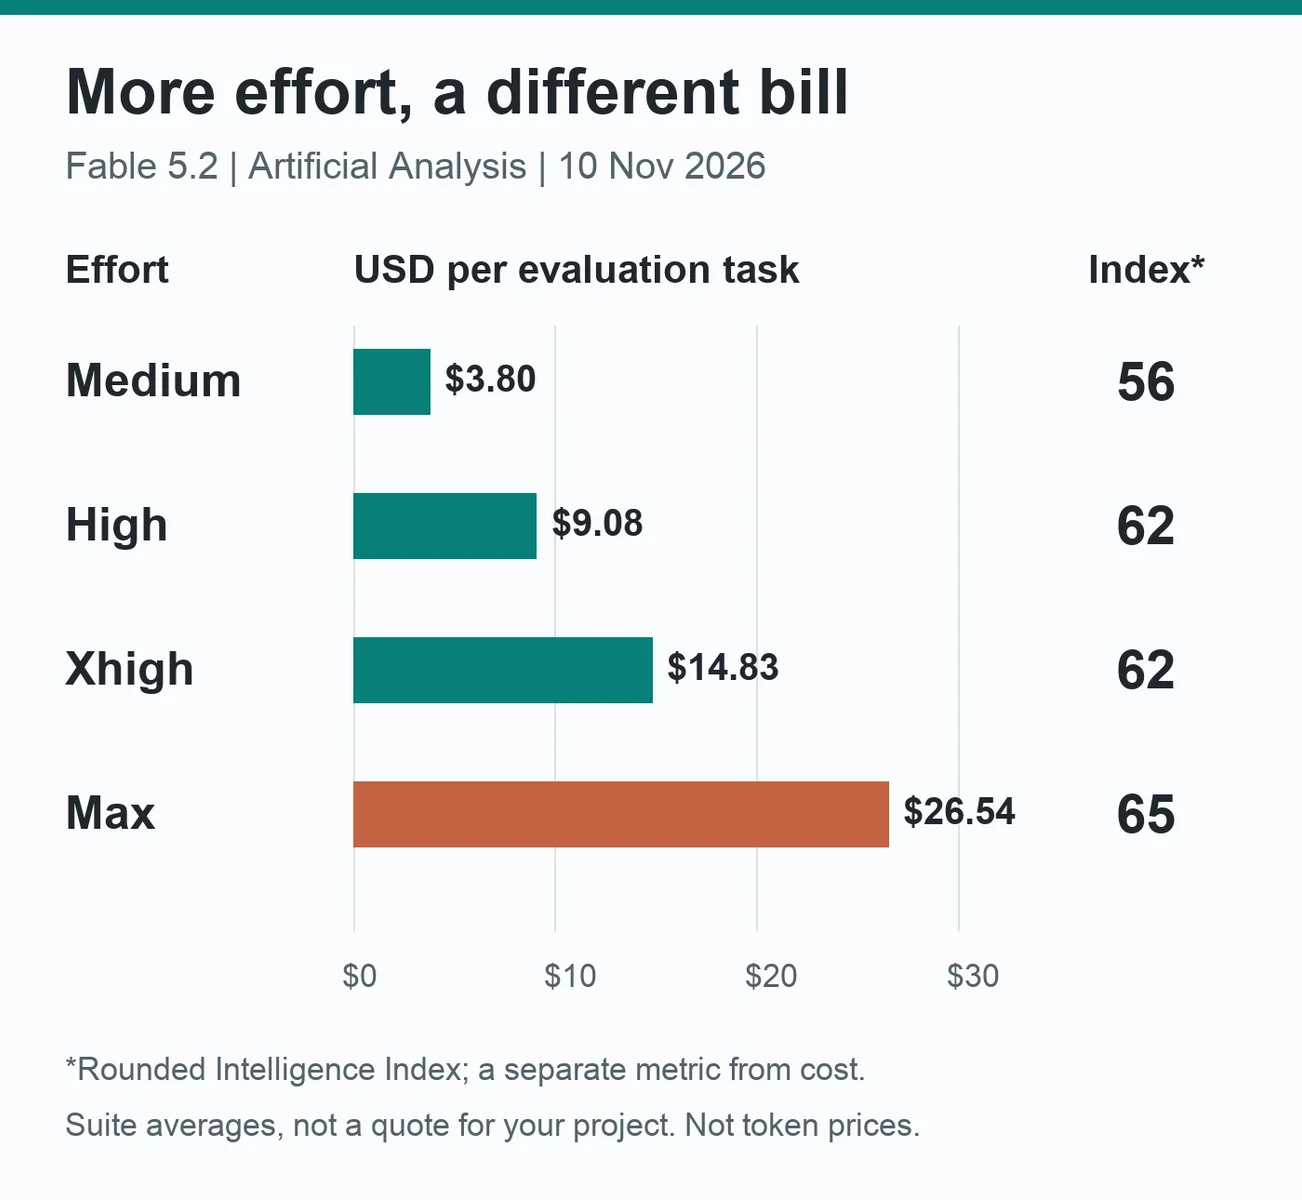
Artificial Analysis anlık görüntüsü, 10 Kasım: Intelligence Index görevi başına medium 3,80 dolar, high 9,08 dolar, xhigh 14,83 dolar, max 26,54 dolar. Bunlar bir özellik veya araştırma projesi için teklif değil, değerlendirme paketinin ortalamalarıdır. Yuvarlanmış index skorları sırasıyla 56, 62, 62 ve 65'tir. Artificial Analysis: effort and cost comparison
Daha yüksek effort için bir neden gerekir
Anthropic'in API'si Fable 5.2 için varsayılan olarak high kullanırken, lansman sayfası Claude uygulamalarının ve Claude Code'un varsayılan olarak medium kullandığını söylüyor. Thinking her zaman açıktır. Effort ayarı, modelin yanıtına ne kadar çalışma ayıracağını kontrol eder; yalnızca daha uzun yanıtlar için kullanılan bir anahtar değildir.
Anthropic'in effort rehberi, API için başlangıç noktası olarak high'ı öneriyor ve max'ı zaman ile token'ların daha az önemli olduğu nadir görevlere ayırıyor. Ayarları temsili işler üzerinde karşılaştırır, ardından yalnızca sonuç bunu haklı çıkardığında daha fazla ödeme yapardım. Claude effort guidance
Karmaşık bir coding oturumunu nasıl yapılandırırdım?
Başlangıç noktam, net bir sonuç ve mevcut sistemi inceleme talebi olurdu. Oturumdan dört şey beklerdim:
Başlangıç prompt'u şöyle olabilir:
text Before editing, trace this feature through the existing codebase. Map its dependencies and explain the main failure cases. Propose the smallest complete change and the tests that would catch a broken implementation. Preserve unrelated work. Ask before migrations, publication or deployment. Afterwards, report what changed, what you verified and what remains unverified.
Modele bir müşteri kod tabanının sınırsız sahipliğini veren prompt'ları kopyalamazdım. Anthropic'in prompting rehberi, sahiplik ifadelerinin diğer talimatlar kapsamı sınırlasa bile ek değişiklikleri teşvik edebileceği konusunda uyarıyor. Bu, sınırları açıkça belirtmek ve diff'i incelemek için bir nedendir. Prompting Claude Fable 5.2
Daha ucuz bir model de rutin adımları ele alabilirken Fable zor kararlara yardımcı olabilir. Claude Code'un advisor aracı, erişim ve faturalandırma koşullarıyla birlikte bu düzenlemeyi destekler. Tavsiye hâlâ token tüketir; delegasyon ücretsiz değildir. Claude Code advisor documentation
Görüşüm: sistemin anlaşılmasının önemli olduğu yerlerde kullanın
Fable 5.2 ilgimi çekiyor çünkü planlama, araştırma ve kod tabanının tamamını kapsayan değişiklikler, Fable'a başvurmamın zaten temel nedenleri. Uygulamaya zaman ayırmadan önce parçaları birbirine bağlama ve bir yaklaşıma meydan okuma konusunda yardım istiyorum.
Bu, onu her düzenleme için otomatik tercihim yapmıyor. Anthropic hâlâ çoğu coding ve knowledge work için Opus 5.5 ile başlamayı öneriyor. Opus 5.5 overview ve önceki Fable 5.1 review yazılarım bu tercihe bağlam sağlıyor.
Zor işler için net bir plan, tutarlı bir uygulama ve çalıştığına dair kanıt istiyorum. Daha güçlü bir modeli kendi nihai reviewer'ı olarak görmek yerine, multi-agent code review workflow yazımda açıklanan bağımsız kontrolleri korurdum.
Fable 5.2, bu daha zor görevlerde test edilmeye değer görünüyor. Asıl faydalı soru, geride daha az eksik iş ve doğrulayabileceğim bir sonuç bırakıp bırakmadığıdır.